
详细介绍
工具简介
SwanHub(SwanLab)是一款面向人工智能开发团队的云端实验平台,专注于解决模型训练过程中的跟踪、记录与可视化难题。在深度学习模型开发中,研究人员往往需要反复调整超参数、运行数十甚至上百次训练实验,如何高效记录每次实验的配置、指标曲线与硬件状态,并能在团队内部进行横向对比,是提升研发效率的关键。SwanHub正是为此而生,它提供了一套开箱即用的MLOps工具链,让开发者能够以极低的接入成本完成实验全生命周期的管理。
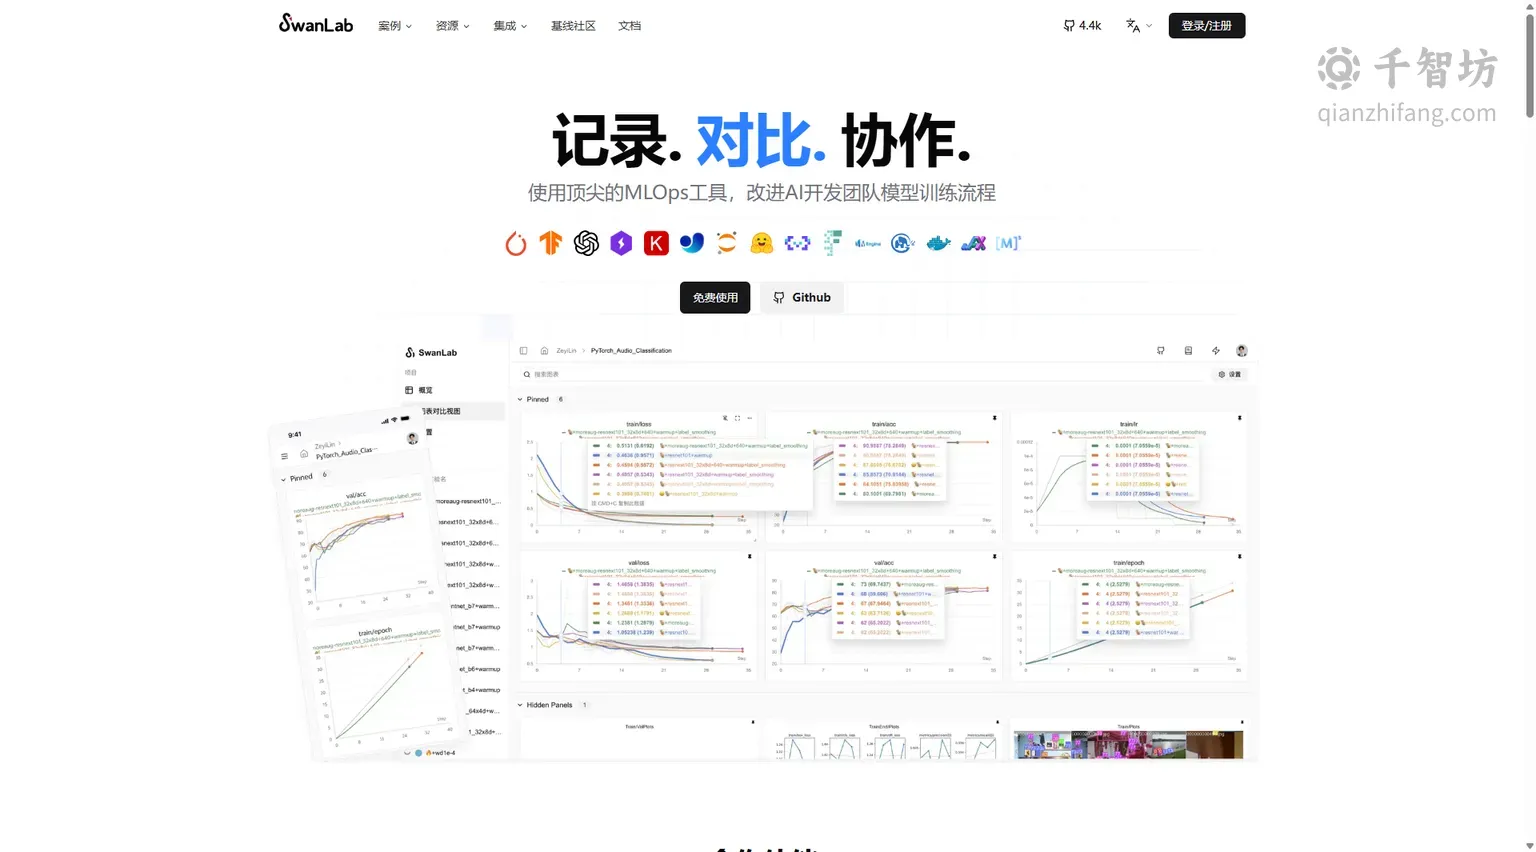
从官网信息来看,SwanHub的核心定位是Trace.Match.Join——即追踪训练过程、匹配实验配置、连接团队协作。它支持通过短短6行代码完成与主流训练框架的集成,官方宣称可对接30余种主流AI训练框架,包括PyTorch、HuggingFace Transformers、PyTorch Lightning、Ultralytics、Swift、MMEngine、Keras以及Stable Baseline3等。这意味着无论开发者使用何种技术栈,都能快速将SwanHub嵌入现有的训练流程,而无需对代码进行大规模改造。
在功能层面,SwanHub覆盖了实验管理的主要环节:训练可视化提供折线图、媒体图表等多种图表类型,实时同步训练进度;超参数记录功能可保存并汇总每次实验的配置项,并支持检索;日志模块自动收集终端打印信息;硬件监控自动记录GPU型号、显存、内存等资源使用情况;编程环境记录则自动捕获Python与Git信息,确保实验可复现。此外,平台还提供实验对比表格,帮助研究者在多个实验之间进行集中比较,快速定位最优配置。
主要功能
训练过程可视化
SwanHub提供多种类型的图表组件,包括基础的折线图、散点图以及面向多媒体任务的媒体图表。训练过程中,损失值、准确率等指标会实时同步到云端仪表盘,开发者可以直观观察模型收敛趋势。这种同步可视化能力让开发者无需频繁查看终端输出,也便于在训练异常时第一时间发现并干预。
超参数管理与检索
每次实验的配置项(如学习率、批次大小、训练轮数等)都会被完整记录并汇总展示。平台提供搜索功能,开发者可以按超参数条件筛选历史实验,快速找到特定配置下的训练结果。这对于需要系统性调参的研究场景尤为重要,避免了手动记录带来的混乱与遗漏。
自动日志与硬件监控
SwanHub会自动收集终端打印日志,省去开发者手动保存日志文件的麻烦。同时,平台自动记录硬件信息,包括GPU型号、显存容量、内存使用情况等,并同步监控CPU与GPU的利用率。这些数据有助于判断训练瓶颈是来自计算资源还是模型本身,为资源调度提供依据。
编程环境与版本记录
平台会自动记录Python版本以及Git仓库信息,确保每次实验的运行环境可追溯。在团队协作中,这一功能可以避免因环境差异导致的实验结果不可复现问题,提升研究的严谨性。
实验对比表格
SwanHub提供集中式的实验表格,将多次实验的关键指标并列展示,支持横向对比。研究者可以据此判断哪组超参数组合效果最佳,从而更有方向地逼近SOTA(当前最优结果)。
多终端与离线支持
除了Web端仪表盘,SwanHub还适配移动端,开发者可以在通勤、运动或用餐时通过手机查看训练进度。同时,平台支持离线使用,满足网络条件不佳场景下的记录需求,待恢复网络后再同步数据。
使用方法
接入SwanHub的流程非常简洁。首先在平台创建项目并获取API Key,然后在训练脚本中引入swanlab库,调用swanlab.init()初始化项目,指定项目名称、实验名称以及配置字典。随后在训练循环中调用swanlab.log()记录指标即可。官方示例显示,仅需创建项目与记录指标两步、约6行代码,就能完成基础集成。对于使用PyTorch、Transformers等框架的用户,官方文档还提供了针对性的集成指南,进一步降低接入门槛。
产品优势
相较于同类实验跟踪工具,SwanHub的优势体现在几个方面:其一,接入成本极低,6行代码即可完成集成,且覆盖30余种框架,兼容性强;其二,功能覆盖全面,从指标可视化到硬件监控、环境记录一应俱全,形成完整的实验管理闭环;其三,支持移动端查看与离线使用,适应多样化的使用场景;其四,提供免费起步方案,开发者可零成本试用核心功能。此外,项目在GitHub上已获得约4.4k星标,具备一定的社区基础。
应用场景
- 学术研究:高校与研究机构的算法研究者需要大量对比实验,SwanHub的超参数检索与实验对比功能可显著提升调参效率。
- 企业AI团队协作:团队成员共享实验记录,统一管理训练过程,避免信息孤岛。
- 大模型微调:在Qwen等大模型的DPO、SFT训练中,实时监控损失曲线与硬件状态。
- 计算机视觉与强化学习:对接Ultralytics、Stable Baseline3等框架,覆盖检测、分割、强化学习等任务。
核心功能
优缺点分析
适用人群
常见问题


