详细介绍
工具简介
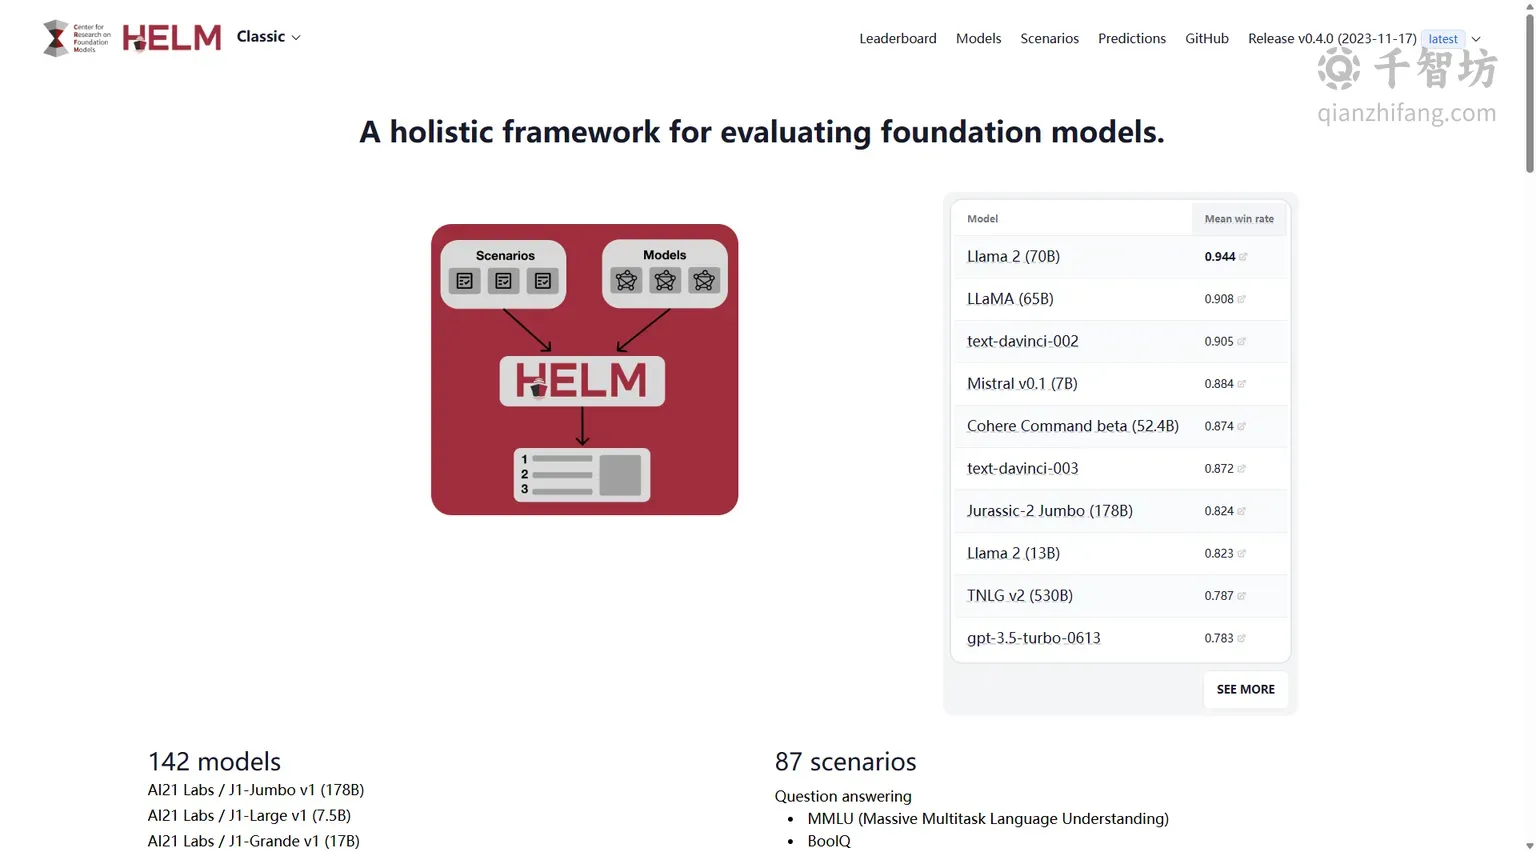
HELM(Holistic Evaluation of Language Models)是由斯坦福大学基础模型研究中心(Center for Research on Foundation Models,简称CRFM)推出的一款综合性AI大模型评测平台。该平台旨在为日益丰富的大语言模型生态提供全面、客观、可复现的评估基准,帮助研究者、开发者以及企业用户深入了解不同模型在各类任务场景下的真实表现。
与市面上许多仅关注单一指标或少数任务的评测工具不同,HELM采取了一种“全方位”(Holistic)的评测理念。它不仅关注模型在准确率上的表现,还系统性地考察模型的鲁棒性、公平性、偏见、毒性、效率等多个维度。这种多维度评估方式使得HELM在学术界和工业界都获得了广泛认可,成为大模型评测领域的重要参考标准之一。
HELM的评测范围覆盖了众多主流大语言模型,包括OpenAI的GPT系列、Anthropic的Claude系列、Google的Gemini系列、Meta的Llama系列以及众多开源模型。平台通过标准化的评测流程和公开透明的评分机制,为用户提供可横向对比的模型性能数据。用户可以通过官网 https://crfm.stanford.edu/helm/latest 访问最新的评测结果和排行榜。
主要功能
多维度基准测试
HELM的核心功能之一是对语言模型进行多维度的基准测试。平台设计了涵盖问答、摘要、信息检索、情感分析、文本分类、代码生成等数十种任务场景的评测集。每个任务都配有标准化的数据集和评价指标,确保不同模型之间的比较具有公平性和可复现性。用户可以通过平台查看每个模型在各任务上的具体得分,从而判断模型是否适合自己的应用场景。
模型排行榜与对比
HELM提供了直观的模型排行榜功能,用户可以根据不同的评测维度对模型进行排序和筛选。排行榜不仅展示模型的综合得分,还支持按任务类型、模型规模、是否开源等条件进行过滤。此外,平台还支持多个模型的并排对比,用户可以直观地看到不同模型在相同任务上的表现差异,为模型选型提供数据支撑。
公平性与偏见评估
HELM特别重视模型的公平性和社会影响评估。平台设计了专门的测试集来检测模型在不同人口统计群体(如性别、种族、年龄等)上的表现差异,以及模型输出中可能存在的偏见和毒性内容。这些评估结果对于负责任的AI开发和应用具有重要意义,帮助开发者识别和缓解模型潜在的社会风险。
效率与成本分析
除了质量指标,HELM还关注模型的推理效率和部署成本。平台记录了各模型在评测过程中的推理延迟、吞吐量、能耗等数据,帮助用户在性能和成本之间做出权衡。对于需要大规模部署模型的企业而言,这些效率数据是不可或缺的参考信息。
开放透明的评测流程
HELM坚持开放科学的原则,其评测流程、数据集、评分代码均对外公开。研究者可以复现评测结果,也可以基于HELM的框架提交自己的模型进行评估。这种透明性保证了评测结果的可信度,也促进了整个AI社区在模型评估标准上的共识形成。
使用方法
访问平台
用户可以直接通过浏览器访问HELM官网 https://crfm.stanford.edu/helm/latest,无需注册即可查看公开的评测结果和排行榜。平台界面简洁直观,主要分为模型列表、任务列表、排行榜和对比工具几个模块。
查看评测结果
在模型列表页面,用户可以浏览所有已被评测的模型及其基本信息。点击任意模型可以查看该模型在各任务上的详细得分,包括准确率、F1值、鲁棒性指标等。平台还提供了可视化图表,帮助用户更直观地理解数据。
进行模型对比
用户可以选择多个模型加入对比列表,平台会生成并排的对比视图,展示各模型在相同任务上的表现差异。对比结果支持导出,方便用户在报告或论文中引用。
提交模型评测
对于希望将自己的模型纳入HELM评测的研究者,平台提供了模型提交入口。提交者需要按照平台要求提供模型接口和相关信息,CRFM团队会进行审核和评测,并将结果纳入排行榜。
产品优势
- 权威性高:由斯坦福大学CRFM团队维护,评测标准和方法论经过学术同行评审,具有较高的公信力。
- 维度全面:不仅评测准确率,还涵盖鲁棒性、公平性、偏见、效率等多个维度,评估结果更加立体。
- 开放透明:评测流程、数据集和代码全部开源,结果可复现,避免了黑箱操作。
- 持续更新:随着新模型的不断涌现,HELM会持续更新评测结果,保持时效性。
- 免费访问:平台对所有用户免费开放,无需付费即可查看完整的评测数据。
应用场景
- 学术研究:研究者可以利用HELM的评测数据进行模型分析、对比实验和论文写作。
- 企业选型:企业在选择大模型API或部署开源模型时,可以参考HELM的评测结果做出更明智的决策。
- 模型开发:模型开发者可以通过HELM的反馈识别自身模型的短板,指导后续优化方向。
- 政策制定:监管机构和政策制定者可以参考HELM的公平性和安全性评估数据,制定负责任的AI发展政策。
- 教育培训:教师和学生可以将HELM作为教学案例,了解大模型评测的方法论和实践。
总结
HELM作为斯坦福大学CRFM推出的AI大模型评测平台,以其全面性、权威性和开放性在大模型评测领域占据了重要地位。无论你是研究者、开发者还是企业决策者,HELM都能为你提供有价值的模型性能参考。随着AI技术的快速发展,HELM将持续演进,为构建更加透明、负责任的AI生态贡献力量。
核心功能
优缺点分析
适用人群
常见问题


