详细介绍
工具简介
PubMedQA是由Qiao Jin、Bhuwan Dhingra、Zhengping Liu、William Cohen和Xinghua Lu等研究人员共同开发的一个生物医学研究问答数据集,发表于2019年EMNLP(自然语言处理经验方法会议)和IJCNLP(国际联合自然语言处理会议)。该数据集旨在推动生物医学领域的自动问答技术发展,特别是针对需要推理能力的复杂医学研究问题。
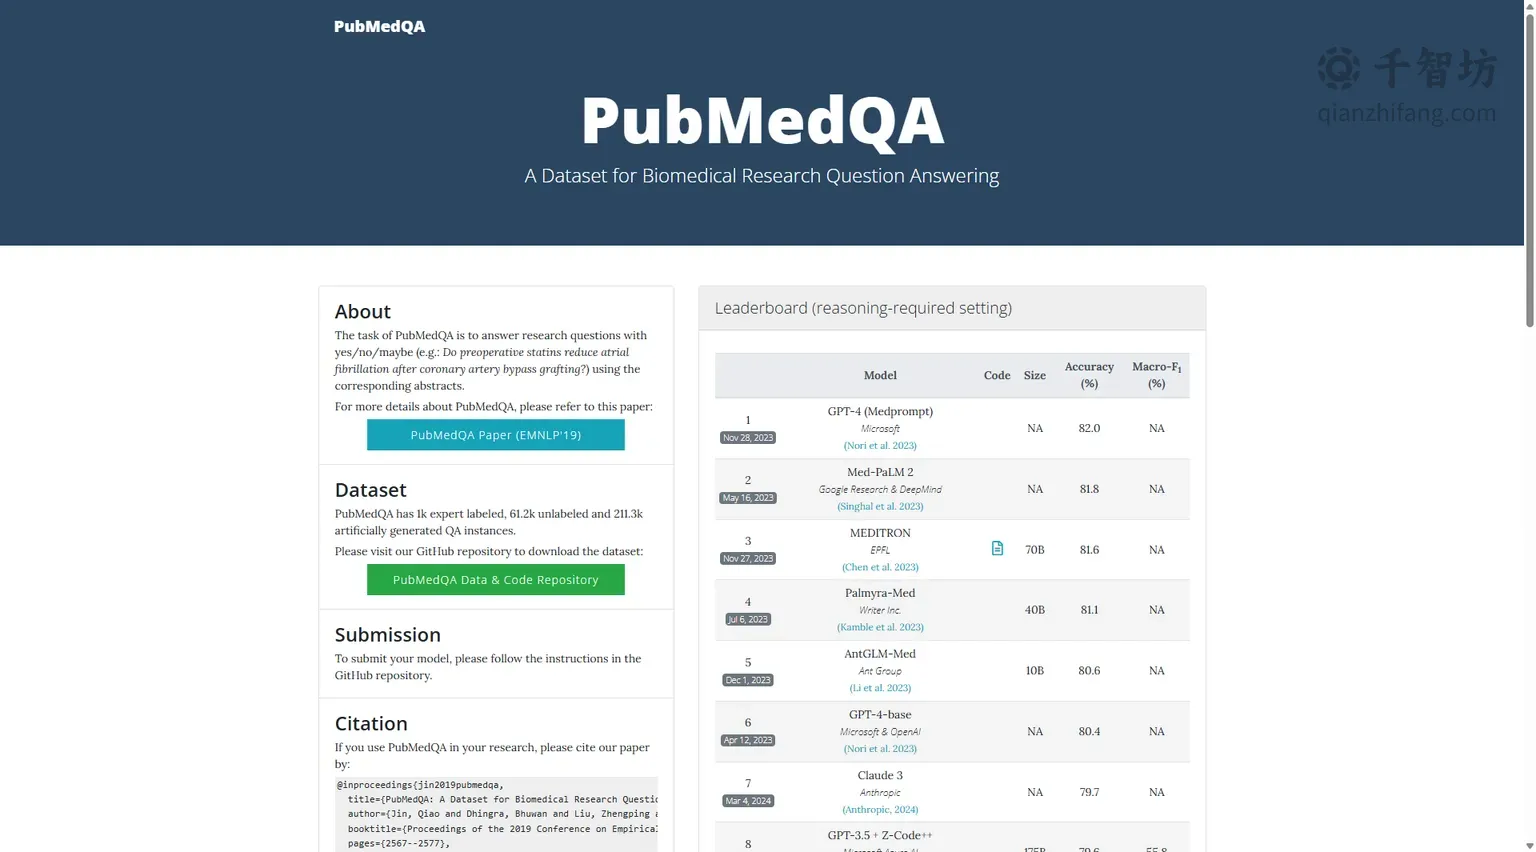
PubMedQA的核心任务是:给定一个生物医学研究问题以及对应的摘要文本,模型需要回答"是"、"否"或"可能"。例如,"术前他汀类药物能否减少冠状动脉搭桥术后的心房颤动?"这类问题,模型需要基于摘要中的证据进行推理,给出准确的判断。这种任务设置不仅要求模型具备语言理解能力,还需要具备医学领域的专业知识和逻辑推理能力。
该数据集包含1000条专家标注的问答实例、6.12万条未标注实例以及21.13万条人工生成的问答实例,总计超过27万条数据。这种规模的数据集为训练和评估生物医学问答模型提供了丰富的资源。PubMedQA的官网提供了数据集的下载链接、论文引用信息以及模型排行榜,方便研究人员提交和比较模型性能。
主要功能
1. 生物医学问答数据集
PubMedQA提供了大规模、高质量的生物医学问答数据集,涵盖多种医学研究问题。数据集分为三个部分:专家标注的1000条实例(PQA-L)、未标注的6.12万条实例(PQA-U)以及人工生成的21.13万条实例(PQA-A)。这些数据来源于PubMed上的生物医学文献摘要,确保了数据的专业性和权威性。研究人员可以使用这些数据训练和评估自己的问答模型。
2. 模型评测排行榜
PubMedQA官网维护了一个模型评测排行榜,采用"需要推理"(reasoning-required)的设置来评估模型性能。排行榜展示了各个模型在准确率(Accuracy)和宏平均F1值(Macro-F1)上的表现。截至2024年,排名前列的模型包括GPT-4(Medprompt)、Med-PaLM 2、MEDITRON、Palmyra-Med等。其中,GPT-4(Medprompt)以82.0%的准确率位居榜首,Med-PaLM 2以81.8%紧随其后。排行榜为研究人员提供了模型性能的参考基准。
3. 数据与代码仓库
PubMedQA在GitHub上提供了完整的数据和代码仓库,研究人员可以下载数据集、查看数据预处理脚本以及模型训练代码。仓库还提供了模型提交的详细说明,方便研究人员将自己的模型结果提交到排行榜。这种开放共享的方式促进了生物医学问答领域的研究进展。
4. 论文引用与学术支持
PubMedQA提供了详细的论文引用信息,如果研究人员在论文中使用了该数据集,需要引用其EMNLP 2019论文。这种学术规范确保了数据集的正确使用和学术贡献的认可。论文中详细介绍了数据集的构建方法、任务定义以及基线模型的性能,为后续研究提供了重要参考。
使用方法
1. 获取数据集
研究人员可以访问PubMedQA官网,点击GitHub仓库链接下载数据集。数据集包含三个子集:PQA-L(专家标注)、PQA-U(未标注)和PQA-A(人工生成)。下载后,可以使用提供的脚本进行数据预处理和加载。
2. 训练模型
使用PQA-L和PQA-A子集训练问答模型。模型需要输入问题和对应的摘要文本,输出"是"、"否"或"可能"。可以采用预训练语言模型(如BERT、GPT等)进行微调,也可以使用提示工程(prompt engineering)方法直接调用大语言模型。
3. 评估模型
在PQA-L的测试集上评估模型性能,计算准确率和宏平均F1值。PubMedQA官网提供了评估脚本,确保评估标准的一致性。
4. 提交结果
如果希望将模型提交到排行榜,需要按照GitHub仓库中的说明,准备模型预测结果和必要的代码,通过Pull Request的方式提交。排行榜会定期更新,展示最新的模型性能。
产品优势
| 优势 | 说明 |
|---|---|
| 数据规模大 | 包含超过27万条问答实例,涵盖专家标注、未标注和人工生成三种类型,满足不同研究需求。 |
| 任务设计合理 | 要求模型基于摘要进行推理,回答"是/否/可能",贴近真实医学研究场景。 |
| 评测标准统一 | 提供官方排行榜和评估脚本,确保不同模型之间的公平比较。 |
| 学术影响力强 | 发表于EMNLP 2019,被广泛引用,是生物医学问答领域的基准数据集之一。 |
应用场景
- 学术研究:用于生物医学问答模型的训练和评估,推动自然语言处理在医学领域的应用。
- 模型对比:研究人员可以通过排行榜比较不同模型在生物医学问答任务上的性能。
- 医学教育:帮助医学生和医生练习基于文献证据的临床推理能力。
- 临床决策支持:为开发临床决策支持系统提供数据基础,辅助医生快速获取研究证据。
技术特点
PubMedQA的任务设置要求模型具备推理能力,而不仅仅是简单的文本匹配。模型需要理解摘要中的研究方法、结果和结论,并据此判断问题中的假设是否成立。这种推理需求使得PubMedQA成为评估大语言模型医学推理能力的重要基准。此外,数据集中的问题来源于真实的生物医学研究,具有高度的专业性和复杂性,对模型的领域知识提出了较高要求。
目标用户
- AI研究人员:专注于自然语言处理、问答系统和医学信息学的研究人员。
- 数据科学家:需要生物医学数据来训练和评估机器学习模型的数据科学家。
- 医学科研人员:希望利用AI技术辅助文献分析和临床研究的医学研究者。
- 医疗AI开发者:开发临床决策支持系统或医学问答应用的工程师和产品经理。
总结
PubMedQA作为生物医学研究问答领域的权威数据集,为AI模型在医学推理任务上的评估提供了标准化基准。其大规模、高质量的数据集和公开的排行榜,促进了生物医学问答技术的快速发展。无论是学术研究还是工业应用,PubMedQA都是不可多得的重要资源。
核心功能
优缺点分析
适用人群
常见问题


