详细介绍
工具简介
H2O EvalGPT 是由知名人工智能公司 H2O.ai 推出的一款面向大语言模型(LLM)的评估与对比工具。随着生成式 AI 技术的爆发式增长,市面上涌现出数量众多的大模型,从 GPT、Claude、Gemini 到各类开源模型,企业和开发者在选型时往往面临一个核心难题:如何客观、系统地判断哪个模型最适合自己的业务场景? H2O EvalGPT 正是为解决这一痛点而生。它提供了一个开放的平台,让用户能够在大量任务和基准测试(Benchmark)中,直观地了解不同大语言模型的性能表现,从而做出更明智的技术决策。
与市面上许多仅提供单一评分或排行榜的评估工具不同,H2O EvalGPT 强调多维度、多任务的综合评估。它不仅关注模型在通用问答上的表现,还覆盖了推理、代码生成、摘要、翻译、情感分析等多种实际应用场景。用户可以通过该平台快速对比多个候选模型,查看它们在不同任务类型下的得分差异,进而筛选出性价比最高、最符合需求的模型方案。这对于需要控制成本、同时又要保证输出质量的企业级应用来说,具有极高的实用价值。
作为 H2O.ai 生态系统的一部分,H2O EvalGPT 与 H2O 旗下的其他产品(如企业级生成式 AI 平台 h2oGPTe、无代码模型微调工具 H2O LLM Studio、自动化机器学习平台 H2O Driverless AI 等)形成了良好的协同效应。企业可以在 H2O 的平台上完成从模型评估、选择、微调到部署的全流程,而 EvalGPT 则承担了其中“选型把关”的关键角色。
主要功能
1. 多模型并行对比评估
H2O EvalGPT 允许用户同时选择多个大语言模型,在相同的任务集和提示词(Prompt)下进行并行测试。平台会自动收集各模型的输出结果,并按照预设的评估指标进行打分和排名。这种“同题竞赛”的方式,能够最大程度地消除测试条件差异带来的偏差,让对比结果更加公平可信。用户无需自己搭建复杂的测试环境,也无需编写繁琐的评测脚本,即可获得专业的对比报告。
2. 丰富的基准测试与任务库
平台内置了大量标准化的基准测试任务,涵盖自然语言理解、逻辑推理、数学计算、代码编写、文本摘要、机器翻译、情感分析等多个维度。这些任务既包括学术界广泛认可的公开基准,也可能包含 H2O.ai 根据实际企业场景设计的定制化任务。用户可以根据自己的业务需求,选择相关的任务类别进行重点评估,而不是仅仅依赖一个笼统的总分。
3. 性能与成本综合考量
在实际应用中,模型的能力并非唯一决定因素,推理成本、响应速度、上下文窗口大小等同样关键。H2O EvalGPT 在评估模型质量的同时,也关注这些工程化指标,帮助用户在“效果”与“成本”之间找到最佳平衡点。例如,某些模型可能在特定任务上得分略低,但推理成本远低于顶级模型,对于大规模部署而言反而更具吸引力。EvalGPT 能够将这类信息一并呈现,辅助用户做出综合判断。
4. 可视化结果与报告
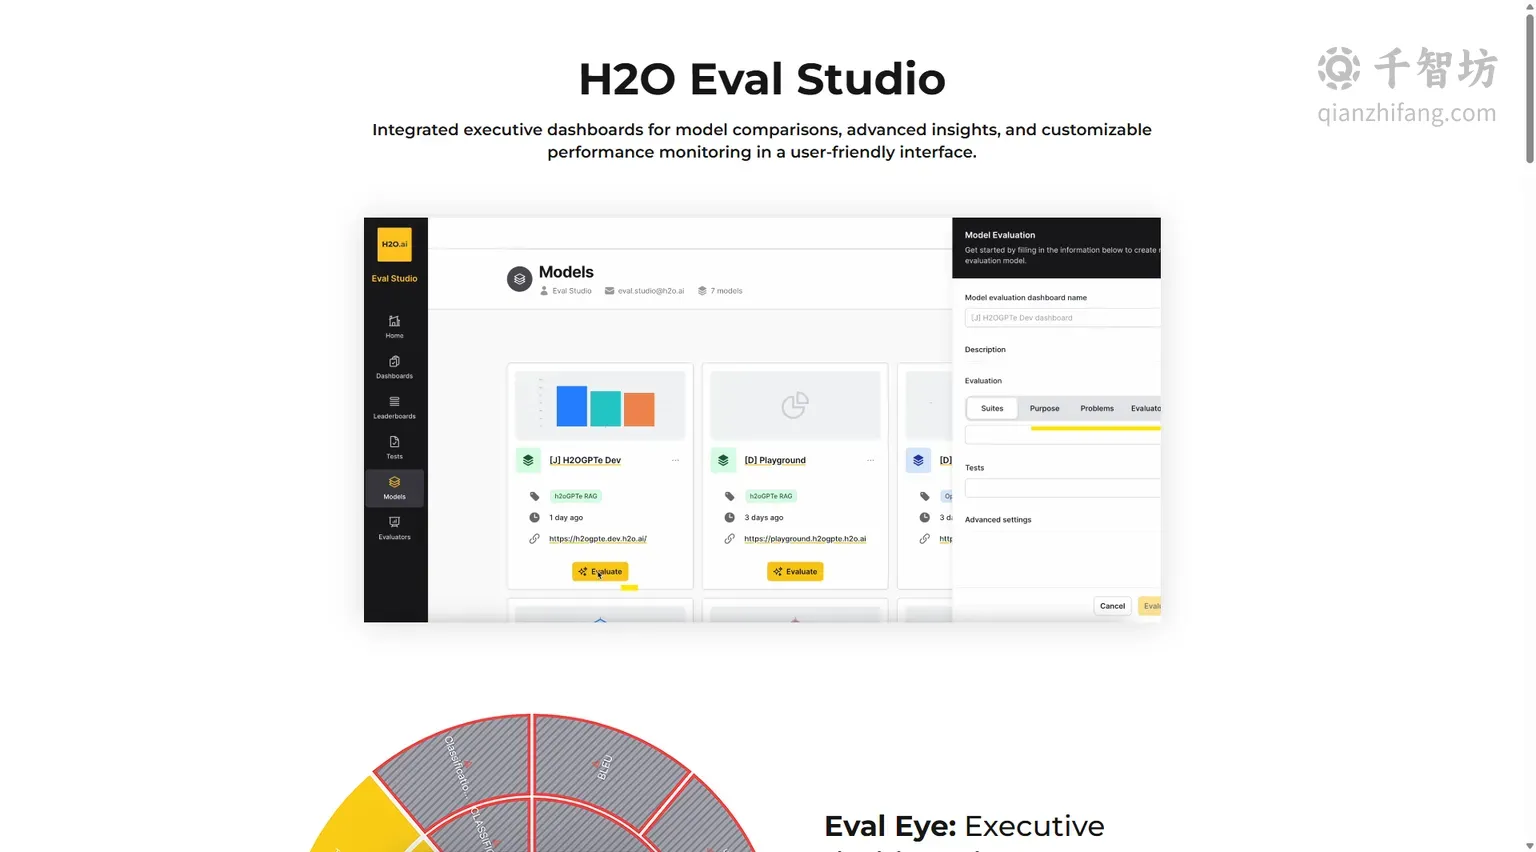
评估完成后,平台会以图表、表格等形式直观展示各模型的表现。用户可以清晰地看到每个模型在不同任务上的得分分布、排名变化以及优劣势对比。这种可视化的呈现方式,极大降低了理解门槛,即使是非技术背景的业务人员也能快速读懂评估结论,参与技术选型的讨论。
5. 开放与可扩展
H2O EvalGPT 定位为开放工具,支持用户接入自己的模型或自定义评估任务。这意味着企业不仅可以评估公开的商用和开源模型,还可以将内部微调后的私有模型纳入对比,验证微调效果是否达到预期。这种开放性使得 EvalGPT 不仅是一个“选型工具”,也可以成为模型迭代优化过程中的“质量监控工具”。
使用方法
- 访问平台:通过浏览器打开 H2O EvalGPT 官网(evalgpt.ai),进入评估平台首页。
- 选择模型:从平台支持的模型列表中,勾选希望对比的一个或多个大语言模型。
- 选择任务:根据评估目的,选择相应的基准测试任务或任务类别。可以全选,也可以只聚焦于与业务最相关的几类任务。
- 启动评估:确认配置后启动评估流程,平台会自动向各模型发送测试提示并收集输出。
- 查看结果:评估完成后,查看可视化报告,分析各模型在不同任务上的得分、排名及成本表现。
- 导出与决策:根据需要导出评估结果,作为技术选型或采购决策的依据。
产品优势
| 对比维度 | H2O EvalGPT | 传统人工评估 |
|---|---|---|
| 评估效率 | 自动化批量测试,短时间内完成多模型对比 | 人工逐条测试,耗时耗力 |
| 客观性 | 标准化任务与指标,减少主观偏差 | 容易受个人偏好影响 |
| 覆盖范围 | 多任务、多维度、多模型 | 通常只能覆盖少量场景 |
| 成本考量 | 结合推理成本综合评估 | 往往忽略成本因素 |
| 可复现性 | 评估流程可重复执行,结果可追溯 | 难以完全复现 |
应用场景
- 企业 AI 选型:企业在引入大模型能力时,需要从众多候选模型中挑选最适合自身业务的一个或多个,EvalGPT 提供了客观的对比依据。
- 模型微调验证:团队对开源模型进行微调后,需要验证微调是否带来了实际提升,EvalGPT 可以将微调模型与基座模型、其他模型进行对比。
- 学术研究与教学:研究人员和学生可以利用该平台快速了解不同模型的能力边界,开展对比实验。
- 成本优化:在保证效果可接受的前提下,寻找性价比更高的模型替代方案,降低推理成本。
- 产品迭代监控:随着模型版本更新,定期评估新版本的表现,确保产品质量稳定或持续提升。
总结
H2O EvalGPT 是一款定位清晰、功能实用的 LLM 评估工具。它依托 H2O.ai 在机器学习与企业级 AI 领域的技术积累,为大模型选型提供了一个开放、客观、多维度的评估平台。无论是企业技术决策者、AI 工程师还是研究人员,都可以借助它更高效地了解模型性能,做出更明智的选择。虽然目前关于其定价模式的信息尚不明确,但其开放工具的定位和与 H2O 生态的协同,使其在大模型评估赛道中具有独特的价值。
核心功能
优缺点分析
适用人群
常见问题


