详细介绍
工具简介
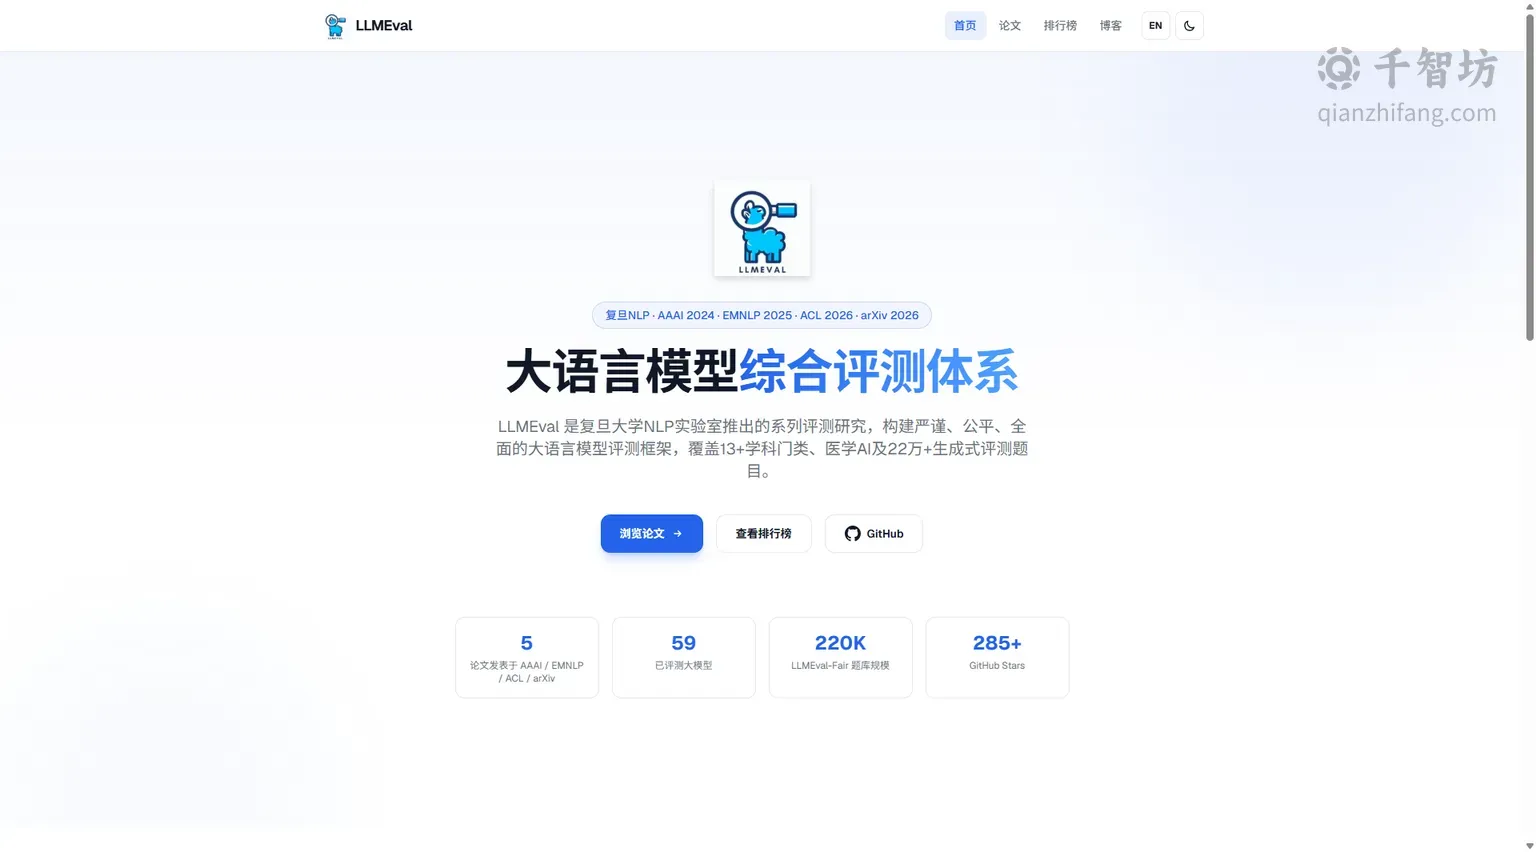
LLMEval3(亦以LLMEval为品牌名对外发布)是由复旦大学自然语言处理实验室(FDU-NLP)发起并维护的一套面向大语言模型(LLM)的综合性评测研究项目。该项目致力于为快速迭代的大模型生态建立严谨、公平、可复现的评估框架,帮助研究者、开发者与企业客观衡量不同模型在真实任务中的能力边界。LLMEval系列成果已先后发表于AAAI 2024、EMNLP 2025、ACL 2026等国际顶级学术会议,并在arXiv上持续发布最新研究进展,是中文大模型评测领域具有代表性的学术开源项目之一。
与市面上许多偏重商业宣传的评测榜单不同,LLMEval3的核心定位是学术研究驱动。它并非简单地把模型拉来跑一遍题库,而是围绕评测方法论本身展开系统研究:如何设计抗污染(contamination-resistant)的测试集、如何用形式化方法验证答案的正确性、如何通过对抗性加固(adversarial hardening)剔除过于简单的题目、如何构建可被第三方复现的评测流水线。这些方法论上的投入,使得LLMEval3的评测结果在学术圈内具有较高的可信度与参考价值。
根据官网信息,LLMEval项目已累计评测了59个大语言模型,构建了包含22万+生成式问题的LLMEval-Fair数据集,覆盖13个以上学术学科以及医学AI等专业领域。项目在GitHub上已获得285+ Stars,并开源了多个子基准的数据集与评测代码,供全球研究者自由使用与验证。
主要功能
1. 多学科综合评测基准
LLMEval3构建了覆盖13个以上学术学科的评测体系,涵盖人文、社科、理工、医学等多个领域。其旗舰数据集LLMEval-Fair包含超过22万个生成式问题,题目设计强调真实场景与推理深度,而非简单的知识检索。这使得评测结果能够更真实地反映模型在复杂任务中的综合能力,而不仅仅是记忆能力。
2. LLMEval-Logic逻辑推理基准
LLMEval-Logic是项目最新开源的中文逻辑推理基准,专门用于评估大模型的逻辑推理能力。该基准采用三阶段审核流水线构建:首先由标注人员从真实世界故事出发正向编写题目,而非从公式反向套模板;其次通过手写评分清单与Z3 SMT求解器双重审核每一条自然语言到一阶逻辑的翻译;最后通过闭环对抗性加固智能体工作流,自动剔除过于简单的题目。数据集分为LLMEval-Logic-Base(单题命题逻辑与一阶逻辑,含Z3验证答案、黄金形式化与原子级NL→FL评分标准)和LLMEval-Logic-Hard(多题/子题,覆盖枚举、计数、唯一性、替代解、反事实推理等)两个配对子集。在14个前沿模型的测试中,最强模型在Hard集上的题目准确率仅为37.5%,说明该基准为前沿推理研究留下了充足空间。
3. 抗污染测试集机制
针对大模型训练数据可能包含评测题目的污染问题,LLMEval3延续了LLMEval-Fair的抗污染传统:仅公开80%的语料,剩余20%作为私有抗污染测试集,由复旦大学NLP实验室维护。这一机制有效降低了模型通过记忆题目刷分的可能性,使排行榜结果更贴近模型的真实泛化能力。
4. 公开排行榜与论文库
官网提供Leaderboard(排行榜)页面,集中展示各参评模型在LLMEval系列基准上的得分与排名,方便用户横向对比不同模型的表现。同时设有Papers(论文)页面,汇总项目在AAAI、EMNLP、ACL及arXiv上发表的全部研究成果,供研究者深入了解评测方法论与实验细节。
5. 开源数据集与可复现评测流水线
LLMEval3在GitHub与Hugging Face上开源了多个数据集与评测代码。以LLMEval-Logic为例,公开了196个Base题目、154个对抗性加固题目、Z3验证答案、专家评分标准以及可复现的评测流水线,研究者可以据此复现论文结果或在此基础上开展新的评测研究。
使用方法
LLMEval3主要面向研究与评测场景,普通用户的使用路径相对简洁:
- 访问官网:打开llmeval.com,浏览首页了解项目概况与最新动态。
- 查看排行榜:进入Leaderboard页面,查看各模型在LLMEval系列基准上的得分与排名,快速了解当前大模型的整体能力分布。
- 阅读论文:在Papers页面查阅AAAI、EMNLP、ACL及arXiv论文,深入理解评测方法、数据集构建流程与实验结论。
- 获取开源资源:通过GitHub仓库或Hugging Face数据集页面下载评测数据与代码,在本地环境中复现评测或开展二次研究。
- 关注博客:Blog页面会发布项目更新、新基准发布与评测结果解读等内容。
产品优势
| 对比维度 | LLMEval3 | 普通商业评测榜单 |
|---|---|---|
| 出品方 | 复旦大学NLP实验室,学术背景深厚 | 多为商业机构或媒体 |
| 评测方法 | Z3形式化验证+对抗性加固+抗污染机制 | 多为静态题库直接跑分 |
| 数据规模 | 22万+生成式问题,13+学科 | 规模参差不齐 |
| 可复现性 | 开源数据集与评测流水线,可复现 | 多数不公开细节 |
| 学术认可 | AAAI/EMNLP/ACL/arXiv发表 | 学术背书较弱 |
应用场景
- 学术研究:NLP研究者可基于LLMEval3的基准与方法论,开展大模型能力评估、推理能力分析等研究。
- 模型选型:企业与开发者可参考排行榜,了解不同模型在中文逻辑推理、多学科知识等维度的表现,辅助技术选型。
- 模型训练反馈:模型开发者可利用LLMEval-Logic等基准定位模型在逻辑推理上的短板,指导后续训练与优化。
- 教学与学习:AI相关课程可将LLMEval3作为案例,讲解大模型评测方法论与抗污染设计思路。
核心功能
优缺点分析
适用人群
常见问题


