sematic

sematic

免费Web
访问官网

Sematic是一个开源机器学习开发平台,帮助ML工程师和数据科学家编写任意复杂的端到端流水线,实现本地与云端无缝运行。

sematic访问官网

详细介绍

工具简介

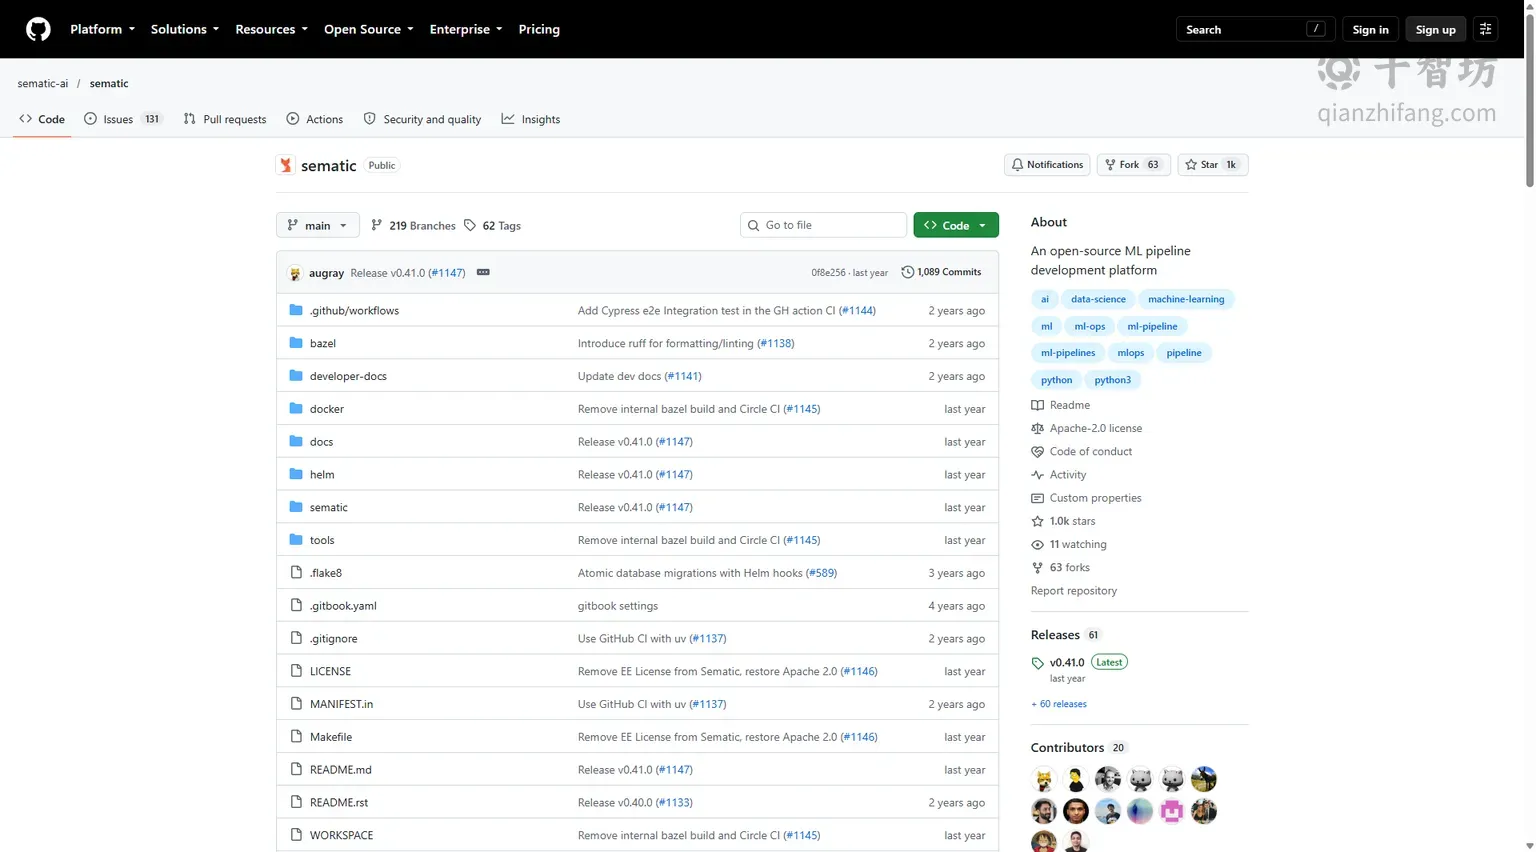
Sematic 是一个开源的机器学习(ML)开发平台,旨在帮助机器学习工程师和数据科学家编写任意复杂的端到端 ML 流水线。根据其 GitHub 开源仓库信息,Sematic 的核心理念是让开发者能够以更自然、更直观的方式构建和管理机器学习工作流,从而弥合本地开发与云端部署之间的鸿沟。尽管其官网域名 sematic.dev 目前显示为域名停放状态(可通过 Afternic 购买),但该项目在开源社区中已有一定的关注度,其代码托管于 GitHub 的 sematic-ai/sematic 仓库中。

在机器学习项目的实际开发过程中,数据科学家和 ML 工程师常常面临诸多挑战:实验代码难以复现、本地环境与生产环境不一致、流水线依赖关系复杂难以管理、中间产物追踪困难等。Sematic 正是针对这些痛点而设计的开发平台。它允许用户编写任意复杂的端到端流水线,从数据预处理、特征工程、模型训练到评估和部署,整个流程都可以在统一的框架下进行编排和管理。其最大的特色在于支持本地与云端无缝切换运行——开发者可以在本地机器上快速迭代和调试,然后无需修改代码即可将同一套流水线部署到云端大规模执行。


主要功能

端到端流水线编排

Sematic 提供了强大的流水线编排能力,支持用户以 Python 函数的形式定义各个计算步骤,并自动处理步骤之间的依赖关系。用户可以将一个复杂的机器学习任务拆解为多个可复用的函数,Sematic 会自动构建依赖图并按正确的顺序执行。这种基于函数式的编排方式大大降低了流水线构建的门槛,使得数据科学家可以专注于业务逻辑本身,而无需过多关注底层的调度细节。

本地与云端无缝运行

Sematic 的一大亮点是支持同一套代码在本地环境和云端基础设施上无缝运行。开发者在本地开发调试时,可以利用本地资源快速验证逻辑;当需要大规模计算时,只需切换运行目标,Sematic 便会将流水线调度到云端执行。这种设计避免了因环境差异导致的"本地能跑、线上报错"的常见问题,显著提升了开发效率和部署可靠性。

中间产物追踪与可视化

在机器学习流水线运行过程中,会产生大量的中间产物,如数据集、模型权重、评估指标等。Sematic 能够自动追踪这些中间结果,并提供可视化界面供用户查看流水线的执行状态、各步骤的输入输出以及运行日志。这为实验复现和问题排查提供了极大的便利,开发者可以清晰地了解每一步的执行情况,快速定位失败环节。

开源可扩展架构

作为开源项目,Sematic 允许开发者自由查看和修改源代码,并根据自身需求进行定制化扩展。其架构设计考虑了可扩展性,支持接入不同的计算资源和存储后端,方便团队根据自身的基础设施情况进行集成。开源特性也意味着用户可以避免供应商锁定,对平台的长期发展拥有更大的掌控权。


使用方法

使用 Sematic 的基本流程通常包括以下几个步骤:

  1. 安装与初始化:通过 pip 等包管理工具安装 Sematic 的 Python 包,并在项目中初始化配置。
  2. 定义流水线函数:使用 Python 装饰器将普通函数标记为 Sematic 的计算步骤,函数之间通过参数传递建立依赖关系。
  3. 本地运行调试:在本地环境中执行流水线,利用 Sematic 的可视化界面查看执行过程和中间结果。
  4. 切换云端执行:配置云端运行环境后,无需修改代码即可将流水线提交到云端执行,实现规模化计算。
  5. 监控与迭代:通过平台界面监控运行状态,根据结果迭代优化流水线逻辑。


产品优势

  • 开发体验友好:以 Python 函数为核心的编排方式贴近数据科学家的日常习惯,学习成本较低。
  • 环境一致性:本地与云端同一套代码运行,有效消除环境差异带来的问题。
  • 开源透明:代码开放,可自由定制和集成,避免供应商锁定。
  • 可观测性强:自动追踪中间产物并提供可视化界面,便于调试和复现。


应用场景

Sematic 适用于多种机器学习工程场景,包括但不限于:数据预处理流水线的构建与管理、模型训练与超参数调优实验的编排、批量推理任务的调度、以及需要多步骤依赖的复杂 ML 工作流。对于希望提升团队协作效率、规范 ML 工程实践的团队而言,Sematic 提供了一个值得关注的开源选择。

核心功能

1
端到端流水线编排
支持以Python函数定义计算步骤,自动构建依赖图并按顺序执行,帮助用户轻松编排从数据预处理到模型部署的完整机器学习流水线,降低复杂工作流的管理难度。
2
本地与云端无缝切换
同一套流水线代码可在本地环境和云端基础设施之间自由切换运行,开发者可先在本地快速迭代调试,再无缝部署到云端规模化执行,消除环境差异问题。
3
中间产物自动追踪
平台自动记录流水线运行过程中产生的数据集、模型权重、评估指标等中间产物,用户可随时回溯查看各步骤的输入输出,为实验复现和问题排查提供依据。
4
可视化执行监控
提供可视化界面展示流水线的执行状态、依赖关系和运行日志,用户可以直观地了解每个步骤的执行情况,快速定位失败环节并进行针对性修复。
5
开源可扩展架构
作为开源项目,源代码完全开放,开发者可根据自身需求定制功能并集成不同的计算资源和存储后端,避免供应商锁定,保障平台的长期可控性。
6
Python原生开发体验
基于Python函数式编程范式设计,数据科学家无需学习新的DSL或复杂框架即可上手,专注于业务逻辑本身,显著降低流水线构建的学习门槛。

优缺点分析

优点
+以Python函数为核心的编排方式贴近数据科学家的使用习惯,学习成本低,上手快
+本地与云端同一套代码无缝运行,有效解决开发与生产环境不一致的痛点
+开源架构允许自由定制和集成,避免供应商锁定,社区可共同推动项目发展
+自动追踪中间产物并提供可视化监控界面,大幅提升实验复现和调试效率
缺点
-官网域名目前处于停放状态,官方文档和产品信息获取渠道有限,可能影响新用户了解产品
-作为相对小众的开源项目,社区规模和生态集成丰富度可能不及主流ML平台,遇到问题时可参考的资料较少

适用人群

机器学习工程师数据科学家MLOps工程师AI研发团队负责人开源技术爱好者

常见问题

Q: Sematic是什么工具?主要解决什么问题?
Sematic是一个开源的机器学习开发平台,主要帮助ML工程师和数据科学家编写和管理任意复杂的端到端机器学习流水线。它解决了实验代码难以复现、本地与生产环境不一致、流水线依赖关系复杂难管理、中间产物追踪困难等常见痛点,让开发者能够以Python函数的方式定义计算步骤,并在本地和云端之间无缝切换运行。
Q: Sematic支持哪些平台?如何获取和使用?
根据现有信息,Sematic主要通过Web平台提供服务,其源代码托管在GitHub的sematic-ai/sematic仓库中,用户可以通过Python包管理工具安装使用。需要注意的是,其官网域名sematic.dev目前显示为停放状态,建议用户通过GitHub仓库获取最新的安装指南和文档。作为开源项目,用户可以在自己的基础设施上部署和运行。
Q: Sematic是免费的吗?价格模式是怎样的?
目前关于Sematic的具体价格模式信息尚不明确(UNKNOWN)。不过从其开源项目属性来看,Sematic的核心代码是开源免费的,用户可以自由下载、使用和修改。如果未来推出托管云服务或企业版,可能会有相应的付费方案。建议关注其GitHub仓库或官方渠道获取最新的定价信息。
Q: Sematic适合哪些人使用?
Sematic主要适合机器学习工程师、数据科学家、MLOps工程师以及AI研发团队使用。特别是那些需要构建复杂多步骤机器学习流水线、希望提升实验可复现性、或者面临本地开发与云端部署环境不一致问题的团队。对于偏好开源方案、希望避免供应商锁定的技术团队而言,Sematic也是一个值得考虑的选择。
Q: Sematic与主流ML流水线工具有何不同?
Sematic的差异化特点在于其以Python函数为核心的编排方式,强调本地与云端无缝切换的开发体验,以及自动追踪中间产物的可视化能力。与一些重量级ML平台相比,Sematic更加轻量、开源透明,学习成本相对较低。不过作为相对小众的项目,其在生态集成丰富度和社区规模方面可能不及一些成熟的商业平台,团队选型时需结合自身需求综合评估。