
详细介绍
工具简介
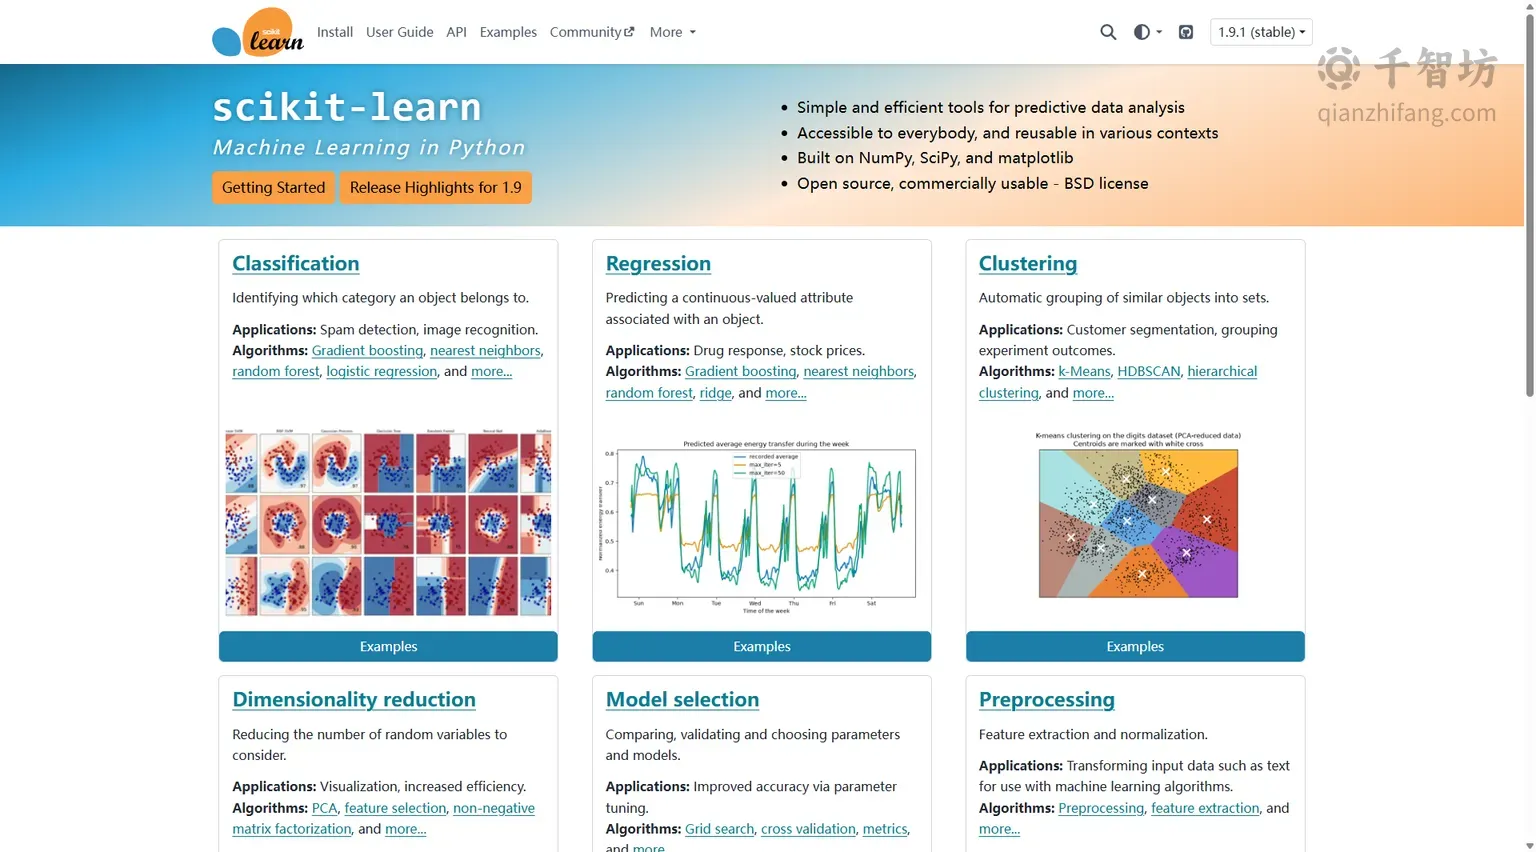
Scikit-Learn(也常写作 scikit-learn 或 sklearn)是一款基于 Python 语言构建的开源机器学习库,专注于为数据挖掘和数据分析任务提供简单而高效的工具。它并非由某一家商业公司运营,而是由全球开源社区持续维护,采用 BSD 许可证发布,这意味着它既可以用于学术研究,也可以免费用于商业项目,这一点对企业和个人开发者都非常友好。
从定位上看,Scikit-Learn 更像是一个“机器学习算法工具箱”,而不是一个端到端的可视化平台。它建立在 NumPy、SciPy 和 matplotlib 这三大科学计算基础库之上,因此能够与 Python 数据科学生态无缝衔接。用户在 NumPy 数组或 Pandas 数据框上完成数据整理后,可以直接把数据交给 Scikit-Learn 的模型进行训练,无需额外的格式转换成本。这种设计让它成为 Python 机器学习工作流中的核心环节。
Scikit-Learn 以其实用性、高性能和丰富的算法实现而闻名。它覆盖了从监督学习到无监督学习的众多经典算法,包括分类、回归、聚类和降维等主要任务类型。同时,它还提供了数据预处理、模型选择与评估、流水线(Pipeline)等配套工具,帮助用户把零散的操作组织成规范、可复用的流程。对于初学者而言,官方提供了详尽的文档、用户指南和大量示例代码,可以快速上手;对于专家而言,其统一的 API 设计和可组合的组件结构,也足以支撑复杂项目的开发。
主要功能
丰富的机器学习算法
Scikit-Learn 内置了大量经典机器学习算法,覆盖多种任务场景。分类任务方面,提供逻辑回归、支持向量机、决策树、随机森林、K 近邻、朴素贝叶斯等;回归任务方面,提供线性回归、岭回归、Lasso、梯度提升回归等;聚类方面,提供 K-均值、DBSCAN、层次聚类等;降维方面,则提供主成分分析(PCA)、t-SNE、独立成分分析等。这些算法共享统一的接口,用户只需调用 fit、predict、transform 等方法即可完成训练与预测,学习成本较低。
数据预处理工具
在训练模型之前,数据往往需要清洗和转换。Scikit-Learn 提供了完整的数据预处理能力,包括特征缩放(如 StandardScaler、MinMaxScaler)、缺失值填充(SimpleImputer)、特征编码(如 OneHotEncoder、OrdinalEncoder)以及特征选择等。这些工具可以帮助用户把原始数据整理成适合模型训练的格式,减少因数据质量问题导致的模型偏差。
模型选择与评估
Scikit-Learn 提供交叉验证、超参数调优和性能评估工具。用户可以使用 train_test_split 划分训练集与测试集,使用 GridSearchCV 或 RandomizedSearchCV 搜索最佳超参数,并通过 accuracy_score、classification_report、混淆矩阵等指标评估模型表现。这些工具让模型选择和优化过程更加系统化,避免凭经验盲目调参。
流水线(Pipeline)
Pipeline 是 Scikit-Learn 中非常实用的组织工具。它可以把数据预处理、特征变换、模型训练和评估等步骤串联成一个完整的流程。使用流水线后,代码结构更加清晰,同时可以避免在交叉验证过程中出现数据泄露问题。对于需要反复实验的项目,流水线显著提升了代码的可维护性和复用效率。
集成学习与多输出支持
Scikit-Learn 提供 Bagging、Boosting 和随机森林等集成学习算法,通过组合多个弱模型来提升整体性能和稳定性。此外,它还支持多输出分类、多输出回归以及多标签分类任务,允许模型同时预测多个目标值或类别,适用于图像标注、文本标签预测等复杂场景。
使用方法
安装与导入
用户可以通过 pip 或 conda 安装 Scikit-Learn。使用 pip 时执行 pip install -U scikit-learn;使用 conda 时执行 conda install -c conda-forge scikit-learn。安装完成后,在 Python 脚本中导入 sklearn 及相关模块即可开始使用。
加载数据与预处理
Scikit-Learn 内置了鸢尾花数据集、手写数字数据集等经典数据集,方便用户练习和测试。对于自定义数据,可以使用 Pandas 读取 CSV 文件,再分离特征列和目标列。随后通过 train_test_split 划分训练集和测试集,并使用 StandardScaler 对特征进行标准化处理。
训练、评估与保存模型
选择合适模型后,调用 fit 方法完成训练,再用 predict 方法在测试集上生成预测结果,并通过 accuracy_score 和 classification_report 查看性能指标。训练好的模型可以使用 joblib 保存为文件,后续直接加载用于新数据的预测,避免重复训练。
产品优势
Scikit-Learn 的核心优势在于统一而简洁的 API 设计、与 Python 科学计算生态的深度集成以及完善的文档与示例。它采用 BSD 许可证,商业使用无授权障碍;算法实现经过长期社区检验,稳定性较高;同时社区活跃,版本持续更新,能够跟上机器学习领域的发展。对于教学、科研和工业原型开发来说,它都是一个可靠的基础工具。
应用场景
- 数据挖掘:通过聚类算法发现数据中的自然分组,从大量数据中提取有价值的信息。
- 数据分析:使用降维算法(如 PCA)对高维数据进行可视化探索。
- 分类任务:垃圾邮件检测、图像分类、疾病诊断等。
- 回归任务:房价预测、股票价格预测、销售量预测等连续值预测。
- 聚类分析:基于 K-均值等无监督算法对客户或样本进行分群,发现数据模式与结构。
核心功能
优缺点分析
适用人群
常见问题


