
详细介绍
工具简介
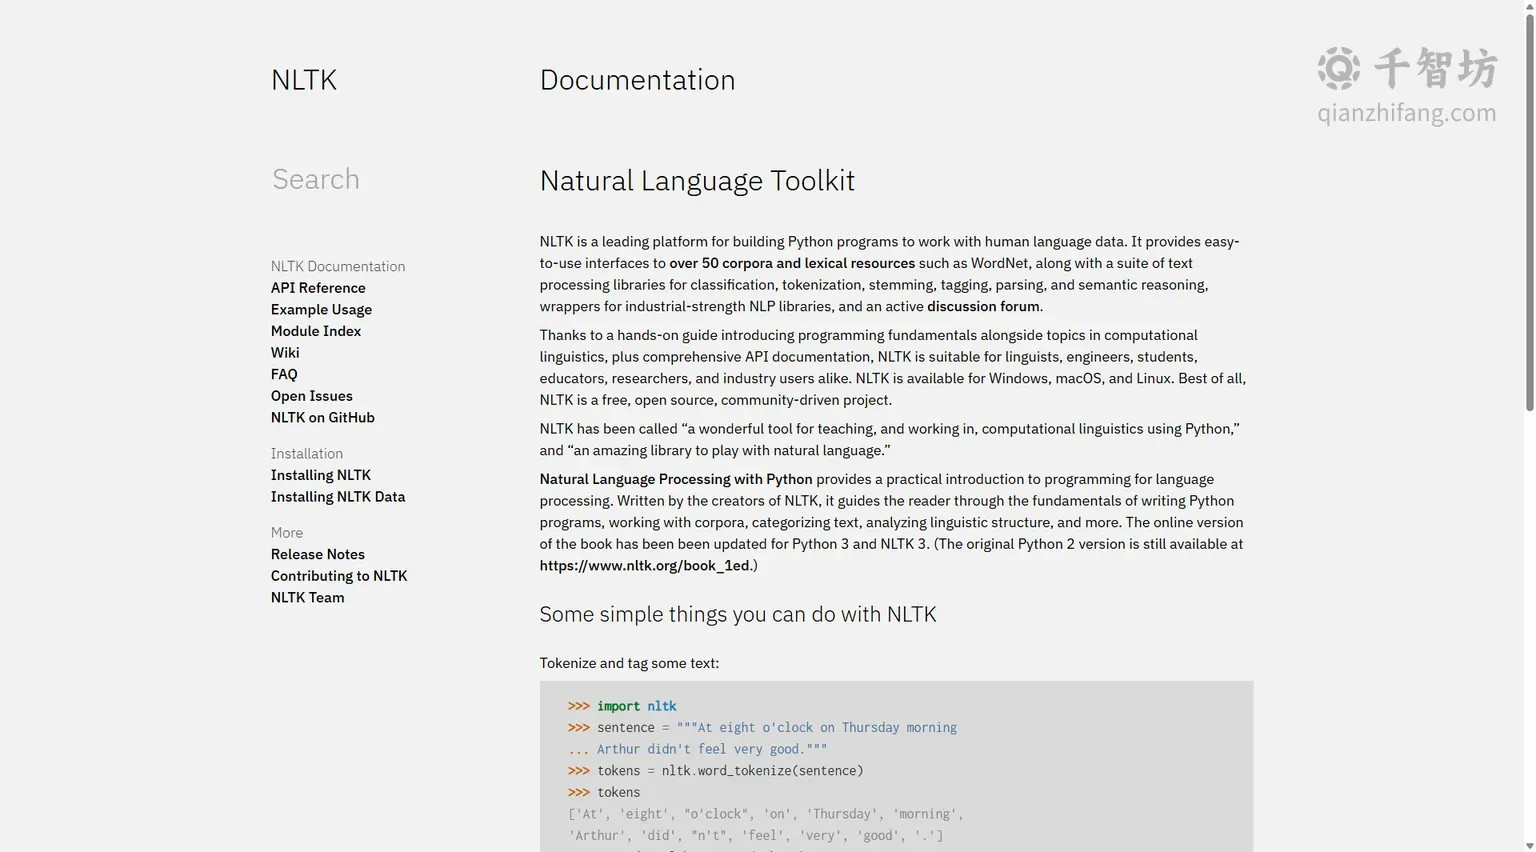
NLTK(Natural Language Toolkit,自然语言工具包)是一套完全开源的Python模块、数据集与教程的集合,专门服务于自然语言处理(NLP)领域。它由社区驱动开发,自诞生以来便成为计算语言学教学与实践领域最具影响力的平台之一。NLTK提供了极为丰富的工具和资源,涵盖文本分词、词性标注、句法分析、命名实体识别等核心NLP任务,并内置了大量语料库和词汇资源(如WordNet),方便用户进行语言学研究和应用开发。官方将其定位为“构建Python程序处理人类语言数据的领先平台”,并提供了超过50种语料库和词汇资源的易用接口,以及一整套用于分类、分词、词干提取、标注、句法分析和语义推理的文本处理库。
NLTK的兼容性良好,支持Python 3.7、3.8、3.9、3.10或3.11版本,可在Windows、macOS和Linux操作系统上运行。无论你是刚接触NLP的初学者,还是从事学术研究的专业人士,NLTK都能提供从入门到进阶的完整支持。它被广泛评价为“使用Python进行计算语言学教学和工作的绝佳工具”,也是一款“把玩自然语言的奇妙库”。NLTK的文档齐全,社区活跃,拥有专门的讨论论坛,是学习和实践自然语言处理不可多得的利器。
主要功能
文本分词(Tokenization)
分词是NLP流程的第一步,NLTK能将连续文本切分为单词或句子单元。其word_tokenize函数可以智能处理标点、缩写等边界情况,例如将“didn't”切分为“did”和“n't”,为后续的词性标注、句法分析等任务奠定基础。
词性标注(Part-of-Speech Tagging)
NLTK的pos_tag函数可为文本中的每个单词标注词性,如名词(NN)、动词(VB)、形容词(JJ)、介词(IN)等。该功能基于宾夕法尼亚树库标签集,广泛应用于信息抽取、句法分析和文本挖掘等场景。
命名实体识别(NER)
NLTK能够识别文本中的人名、地名、组织名等命名实体,通过nltk.chunk模块和预训练模型,将非结构化文本中的关键实体抽取出来,常用于新闻分析、知识图谱构建等任务。
词干提取与词形还原
词干提取(Stemming)通过PorterStemmer等算法将单词还原为词干形式,便于统一处理;词形还原(Lemmatization)则借助WordNet将单词还原为词典形式,更准确地保留语义。两者结合可有效降低词汇维度,提升文本分析效果。
句法分析(Parsing)
NLTK支持生成句法树,分析句子的语法结构,包括成分句法分析和依存句法分析。用户可以利用ChartParser等工具构建语法规则,深入理解句子的层次结构,服务于机器翻译、问答系统等高级应用。
语料库访问
NLTK内置了Brown语料库、PENN Treebank、WordNet等超过50种语料库和词汇资源,用户可通过统一接口加载和检索,极大方便了语言学研究和模型训练。这些资源覆盖多种语言和领域,是NLTK的核心优势之一。
文本分类与特征提取
NLTK提供了朴素贝叶斯分类器、决策树分类器等多种分类器,并支持从文本中提取特征(如词袋模型、n-gram特征),用于垃圾邮件检测、情感分析、文档分类等机器学习任务。
使用方法
安装与验证
用户可通过pip命令安装NLTK:pip install nltk。安装完成后,在Python环境中运行import nltk; print(nltk.__version__)即可验证版本。随后需下载必要的数据包,例如运行nltk.download('punkt')下载分词器,nltk.download('averaged_perceptron_tagger')下载词性标注器。
基本操作示例
分词操作:from nltk.tokenize import word_tokenize; words = word_tokenize("NLTK is a powerful library for natural language processing."),输出分词结果列表。词性标注:from nltk import pos_tag; tagged_words = pos_tag(words),得到每个单词对应的词性标签。这些简洁的API设计使得NLTK非常适合教学和快速原型开发。
产品优势
- 完全免费开源:NLTK是社区驱动的开源项目,无需任何费用,代码可自由修改和分发。
- 资源极其丰富:内置50+语料库和词汇资源,覆盖多种语言和领域,为研究和开发提供坚实基础。
- 文档与教程完善:官方提供详细的API文档、示例用法以及由创作者编写的《Natural Language Processing with Python》在线书籍,学习曲线平缓。
- 跨平台兼容:支持Windows、macOS、Linux,兼容Python 3.7至3.11,适应多种开发环境。
- 社区活跃:拥有活跃的讨论论坛和GitHub仓库,用户可快速获取帮助并参与贡献。
应用场景
- 文本分类:利用NLTK的分类器进行垃圾邮件检测、文档分类等任务。
- 情感分析:分析社交媒体文本的情感倾向,辅助市场调研和舆情监控。
- 机器翻译:通过语言模型和句法分析辅助实现不同语言间的文本翻译。
- 问答系统:构建能理解并回答自然语言问题的智能系统。
- 文本摘要:提取文本关键信息,生成简洁摘要,提升信息获取效率。
- 学术研究:语言学家可利用NLTK进行语料库语言学和计算语言学的实证研究。
综上所述,NLTK凭借其全面的功能、丰富的资源和友好的学习曲线,成为自然语言处理领域一款不可替代的基础工具。无论是课堂教学、科研实验还是工业级原型开发,NLTK都能提供强有力的支持。
核心功能
优缺点分析
适用人群
常见问题


