
详细介绍
工具简介
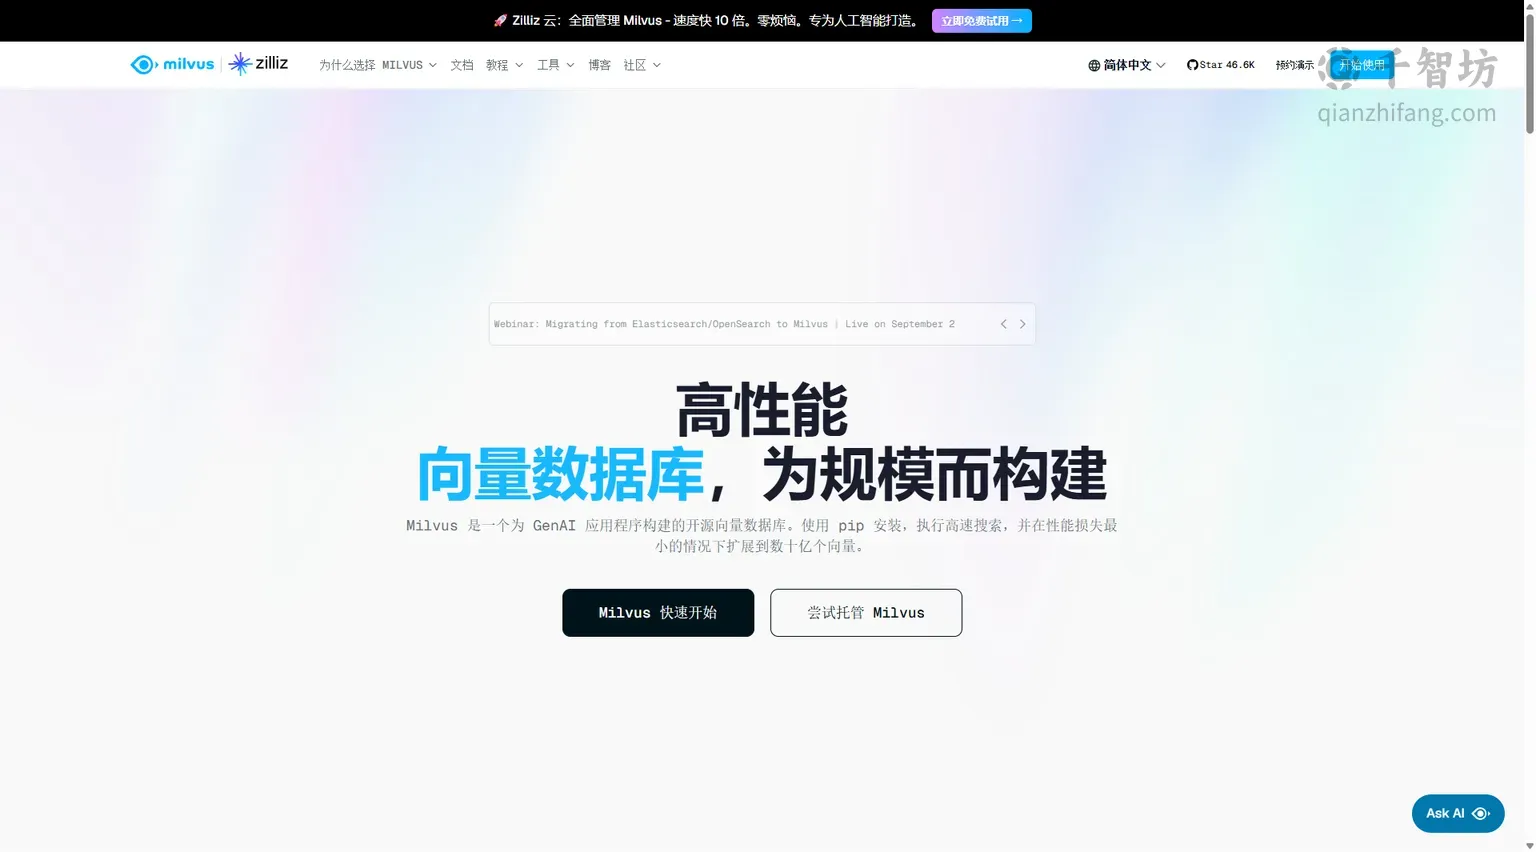
Milvus 是一款由 Zilliz 公司主导开发并开源的高性能云原生向量数据库,专为大规模 AI 检索场景而设计。在人工智能应用快速普及的今天,文本、图像、音频、视频等非结构化数据呈爆炸式增长,传统的关系统数据库难以高效处理这类数据的相似性检索需求。Milvus 正是在这样的背景下应运而生,它通过高效的向量相似性搜索能力,帮助开发者构建强大且可扩展的图像检索系统、语义搜索、推荐系统以及检索增强生成(RAG)等 AI 应用。无论是管理个人照片库,还是开发商业级的图像检索平台,Milvus 都能提供稳定可靠的底层支撑。
Milvus 采用存储与计算分离的云原生架构,这一设计使其能够灵活应对从本地开发到大规模集群部署的不同需求。项目在 GitHub 上已获得超过 46.6K 的 Star,拥有活跃的开源社区和丰富的生态工具。其核心优势在于将向量索引、查询调度、存储管理等模块解耦,使得系统可以独立扩展,从而在保证高性能的同时兼顾成本控制。对于希望在 AI 应用中集成向量检索能力的团队而言,Milvus 提供了一条从原型验证到生产部署的完整路径。
主要功能
多种向量索引支持
Milvus 内置了丰富的向量索引类型,包括 HNSW、IVF 系列、DiskANN 等,能够满足不同规模与精度要求的检索场景。HNSW 适合低延迟高召回的场景,IVF 系列通过聚类划分加速大规模检索,DiskANN 则针对磁盘存储优化,在内存受限时仍能保持较高性能。开发者可以根据数据量、查询延迟和硬件资源灵活选择合适的索引策略。
混合搜索与多模态检索
除了纯向量相似性搜索,Milvus 还支持标量字段过滤与向量检索的组合查询,即混合搜索。这意味着用户可以在一次查询中同时应用属性条件和向量相似度排序,例如在图像检索中先按时间范围过滤再按视觉相似度排序。该能力对于构建复杂的推荐系统和多模态检索应用尤为关键。
存储与计算分离架构
Milvus 采用云原生架构,将存储层与计算层解耦。存储层负责数据的持久化,计算层负责查询与索引构建,二者可以独立扩缩容。这种架构使得系统在面对海量数据和高并发查询时仍能保持弹性,同时降低了运维复杂度,适合在 Kubernetes 等云环境中部署。
多种部署形态
Milvus 提供多种部署选项以适应不同阶段的需求。Milvus Lite 非常适合本地 Python 程序的入门与快速验证,无需复杂配置即可在笔记本上运行。对于大规模数据或生产环境,则可以选择单机版或分布式集群部署。此外,Zilliz 还提供全托管的 Zilliz Cloud 服务,号称比自建 Milvus 快 10 倍且免运维,进一步降低了使用门槛。
丰富的生态工具
Milvus 生态提供了多款辅助工具,包括可视化管理工具 Attu、命令行工具 Milvus CLI、容量规划工具 Sizing Tool、备份工具 Milvus Backup、向量传输服务 VTS 以及面向 RAG 场景的 Deep Searcher 和 Claude Context 等。这些工具覆盖了开发、调试、运维和场景化应用的各个环节。
使用方法
快速入门
对于初学者,推荐从 Milvus Lite 开始。通过 pip 安装对应的 Python 包后,即可在本地程序中创建集合并插入向量数据,整个过程无需额外部署服务。官方文档提供了详细的快速入门指南,帮助用户在几分钟内完成第一次向量检索。
生产部署
当数据规模增长或需要多用户并发访问时,可迁移至单机版或分布式集群。部署前建议使用 Sizing Tool 评估硬件资源需求,比较本地与服务器环境的要求。在 Kubernetes 环境中,Milvus 可通过 Helm Chart 或 Operator 进行编排,实现自动化运维。
数据管理与检索
用户通过 Collection 组织数据,每个 Collection 可定义向量字段和标量字段。插入数据后建立索引,即可执行相似性搜索。Milvus 支持批量插入、删除和更新操作,并提供丰富的查询接口,方便与上层 AI 应用集成。
产品优势
| 对比维度 | Milvus 优势 |
|---|---|
| 架构 | 存储计算分离,弹性扩缩容,云原生设计 |
| 索引 | 支持 HNSW、IVF、DiskANN 等多种索引,适应不同场景 |
| 生态 | 开源社区活跃,GitHub Star 超 46.6K,工具链完善 |
| 部署 | 从 Lite 到分布式集群,再到托管云服务,覆盖全阶段 |
此外,Milvus 专注于高效的向量相似性搜索,在图像检索、语义搜索等场景中表现出色。其开源属性使得团队可以自主掌控技术栈,避免供应商锁定;而 Zilliz Cloud 托管服务则为缺乏运维资源的团队提供了便捷选择。
应用场景
- 图像检索系统:通过向量化图像特征实现以图搜图,适用于电商、版权保护等场景。
- 语义搜索:将文本转换为向量后进行语义匹配,提升搜索引擎的召回质量。
- 检索增强生成(RAG):为大语言模型提供外部知识库检索能力,降低幻觉。
- 推荐系统:基于用户和物品的向量表示进行相似度匹配,实现个性化推荐。
- 多模态检索:结合文本、图像等多种模态的向量进行跨模态搜索。
总体而言,Milvus 凭借其高性能、可扩展的架构和丰富的生态,已成为 AI 时代向量数据库领域的重要基础设施,适合从个人开发者到大型企业的广泛用户群体。
核心功能
优缺点分析
适用人群
常见问题


