
详细介绍
工具简介
Llamahub(官网 llamahub.ai)是 LlamaIndex 生态体系中的一个重要组成部分,定位为面向开发者的开源数据连接与LLM调用枢纽。它最初以“LlamaHub”之名被社区熟知,核心使命是解决大语言模型应用开发中最棘手的一环——如何把外部私有数据、文档、API 和各类知识源,高效、标准化地接入到 LLM 的推理流程中,从而实现基于文档的语义对话、检索增强生成(RAG)以及智能体(Agent)工具调用。
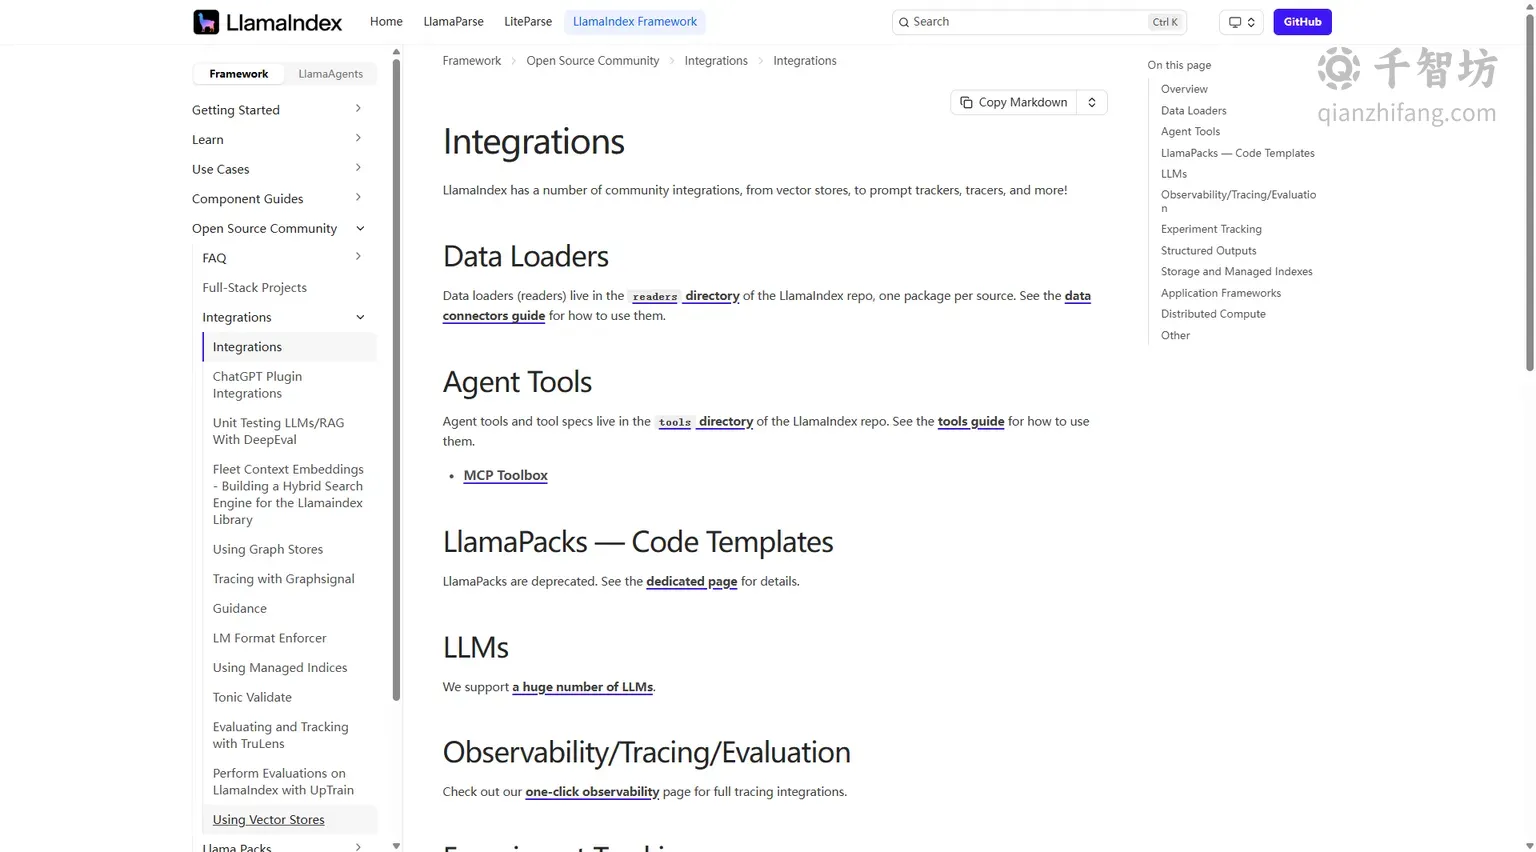
从官网当前指向的开发者文档结构可以看出,Llamahub 与 LlamaIndex Framework、LlamaParse、LiteParse 等产品共同构成了一个完整的开发者工具矩阵。其中 LlamaIndex Framework 提供了构建 LLM 应用的高层概念、安装配置、入门教程(包括使用 OpenAI 与本地 LLM 两种路径)、异步编程指南,以及构建 Agent、使用现有工具、维护状态、流式输出、Human-in-the-loop、多智能体模式、结构化输出等一整套能力。Llamahub 则承担着“连接器仓库”的角色:它汇集了大量由官方与社区贡献的数据加载器(Data Loader)、工具(Tool)、向量存储集成、回调处理器等组件,让开发者不必从零编写数据接入代码,而是通过统一的接口规范快速复用。
主要功能
1. 海量数据加载器与连接器
Llamahub 最核心的价值在于其丰富的数据加载器(Data Loader)库。无论是本地文件(PDF、Word、Markdown、CSV、JSON)、网页内容、数据库记录,还是第三方 SaaS 平台(如 Notion、Slack、Google Docs、GitHub 等)中的结构化与非结构化数据,开发者都可以在 Llamahub 中找到对应的加载器。每个加载器都遵循 LlamaIndex 的统一接口,将原始数据转换为标准的 Document 对象,从而无缝进入后续的索引、检索与对话流程。这极大降低了 RAG 应用的数据准备成本。
2. 文档语义对话与检索增强生成
借助 Llamahub 接入的文档数据,开发者可以构建基于语义的问答系统。系统会将文档切分、向量化并建立索引,当用户提出自然语言问题时,先通过语义检索召回最相关的文档片段,再交由 LLM 生成答案。这种方式让模型回答有据可依,显著减少幻觉,并能处理超出模型训练知识范围的私有文档内容,是企业知识库问答、文档助手等场景的基础能力。
3. Agent 工具集成
Llamahub 不仅提供数据加载器,还收录了大量可供 LLM Agent 调用的工具(Tools)。这些工具涵盖搜索、计算、API 调用、代码执行等能力,开发者可以按照 LlamaIndex 的 Agent 构建范式,将工具注册给智能体,使其能够根据用户意图自主选择并调用合适的外部能力,完成多步骤复杂任务。结合多智能体模式与状态维护机制,可以搭建协作式的智能应用。
4. 向量存储与生态集成
Llamahub 汇集了主流向量数据库与存储后端的集成组件,方便开发者将索引持久化到生产级存储中,并支持大规模检索。同时它与 LlamaParse(文档解析)、LiteParse 等工具协同,形成从文档解析、数据加载、索引构建到对话生成的完整链路。
5. 标准化与社区共建
所有组件遵循统一的接口规范,开发者既可以直接复用,也可以按照规范贡献自己的加载器与工具,形成活跃的开源社区生态。这种开放性保证了 Llamahub 能持续快速覆盖新的数据源与服务。
使用方法
- 环境准备:参考 LlamaIndex 官方文档完成安装与配置,可选择接入 OpenAI 或本地 LLM。
- 选择加载器:在 Llamahub 中检索目标数据源对应的加载器,安装并初始化。
- 加载与索引:将文档加载为 Document 对象,切分后构建向量索引。
- 构建查询引擎:基于索引创建查询引擎或对话引擎,接入 LLM。
- 扩展 Agent:按需注册工具,构建具备工具调用能力的智能体。
产品优势
| 维度 | Llamahub 表现 |
|---|---|
| 开放性 | 开源、社区共建,组件丰富且持续增长 |
| 标准化 | 统一接口,降低集成与迁移成本 |
| 生态完整 | 与 LlamaIndex、LlamaParse 等形成完整链路 |
| 灵活性 | 支持云端与本地 LLM,适配多种部署场景 |
应用场景
- 企业私有知识库的智能问答与文档助手
- 基于多源数据的检索增强生成应用开发
- 需要调用外部工具的 LLM 智能体搭建
- 研究与小团队快速验证 RAG 原型
核心功能
优缺点分析
适用人群
常见问题


