
详细介绍
工具简介
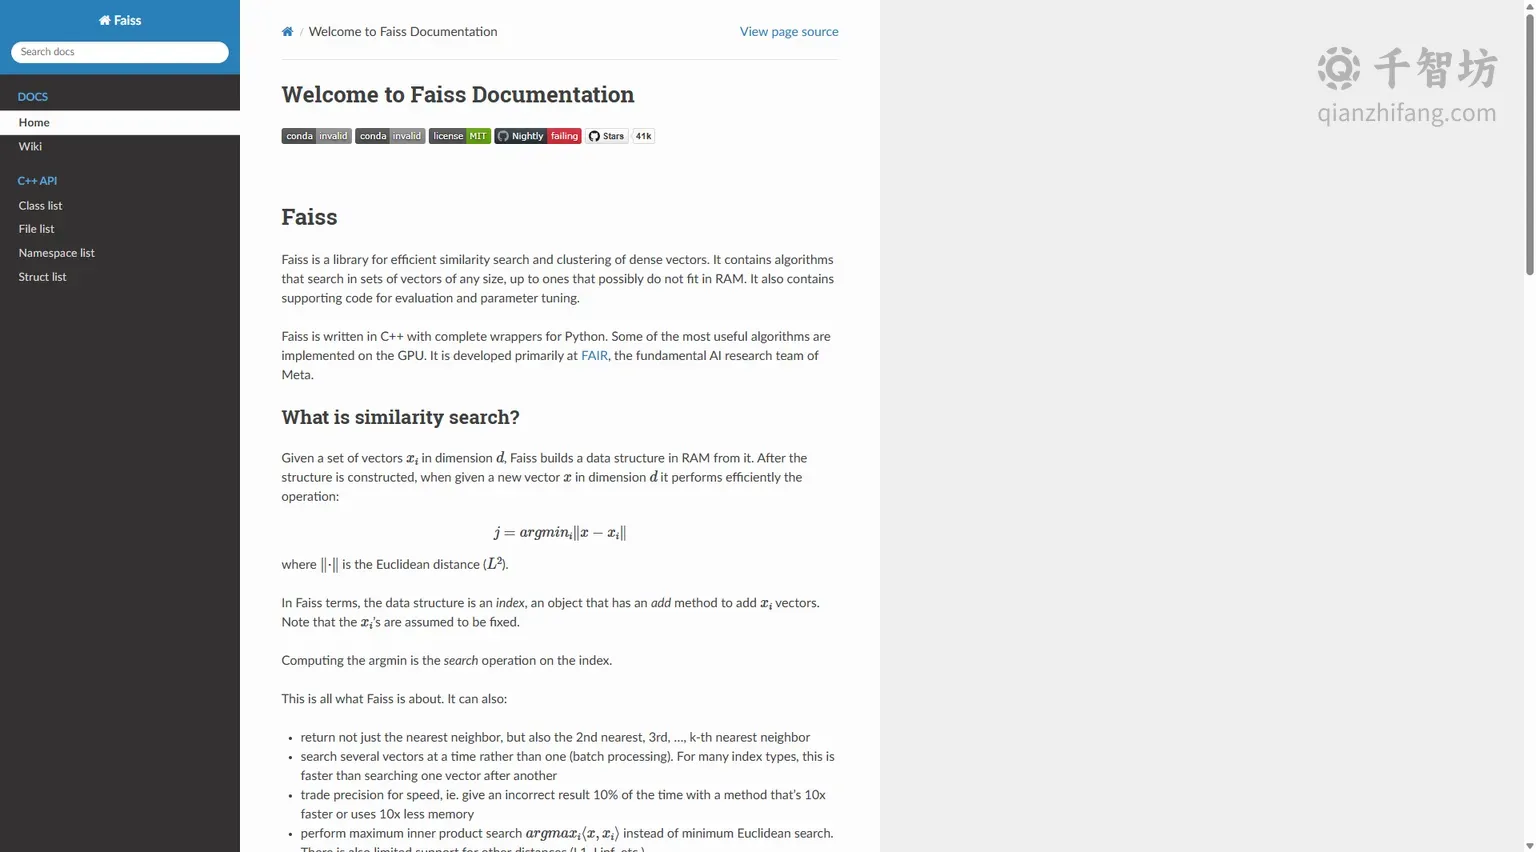
FAISS(Facebook AI Similarity Search)是由Meta旗下基础人工智能研究团队FAIR开发并开源的一款高性能向量检索库,专注于解决稠密向量的高效相似性搜索与聚类问题。自发布以来,FAISS凭借其卓越的检索性能和灵活的索引结构,迅速成为向量数据库与语义检索领域的基础设施级工具,在学术界和工业界均引起了广泛关注。它本质上是一个算法库而非完整的数据库产品,核心能力是快速完成大规模——例如十亿级别——向量的最近邻搜索任务。
从数学角度看,FAISS解决的问题非常清晰:给定维度为d的一组向量x_i,FAISS会在内存中构建一个数据结构;当输入一个新的d维向量x时,它能够高效地执行操作 j = argmin_i ||x - x_i||,其中||·||表示欧几里得距离(L2距离)。在FAISS的术语体系中,这个数据结构被称为索引(index),索引对象提供add方法用于添加向量,而计算argmin的过程则称为对索引的搜索(search)操作。FAISS假设被检索的向量集合是固定的,在此基础上提供极致的检索效率。
FAISS使用C++编写,并为Python提供了完整的封装接口,使得研究人员和工程师可以方便地在Python环境中调用其强大功能。更值得一提的是,FAISS中一些最有用的算法还实现了GPU版本,能够充分利用显卡的并行计算能力,将检索速度提升到新的高度。该项目由Meta FAIR团队主要维护,代码托管于GitHub并采用开源许可证发布,社区活跃度高,持续有版本迭代和功能更新。
主要功能
多样化的索引类型
FAISS最核心的竞争力在于其丰富的索引类型体系。不同的索引结构在检索精度、内存占用和搜索速度之间提供了不同的权衡方案。常见的核心索引类型包括:
- Flat索引:即暴力穷举搜索,对所有向量进行精确比对,召回率最高但计算量随数据量线性增长,适合小规模数据集或作为召回效果的基准参考。
- IVF(倒排文件)索引:通过聚类将向量空间划分为多个单元,搜索时只考察与查询向量最接近的若干聚类中心所对应的单元,大幅减少计算量,适合大规模数据集。
- PQ(乘积量化)索引:将高维向量切分为若干子向量并分别量化编码,显著压缩内存占用,使十亿级向量检索在有限内存中成为可能。
- HNSW(分层可导航小世界图)索引:基于图结构的近似最近邻搜索算法,在查询速度和召回率之间取得良好平衡。
- IVF+PQ组合索引:将倒排文件与乘积量化结合,兼顾速度与内存效率,是工业界大规模检索的常用方案。
此外,FAISS还支持LSH、标量量化等更多索引类型,用户可以根据数据规模、精度要求和硬件条件灵活选择。
K近邻与批量搜索
FAISS的搜索能力不止于返回最近的一个邻居。它支持返回第2近、第3近直至第k近的邻居,满足K近邻检索的完整需求。同时,FAISS支持一次对多个查询向量进行批量搜索,而非逐个串行处理,这在实际工程中能显著提升吞吐量。批量处理能力使得FAISS非常适合在线服务场景下的高并发查询。
GPU加速
FAISS将部分最有用的算法在GPU上实现,借助CUDA并行计算能力,在大规模向量集合上的搜索速度可获得数量级的提升。对于需要处理海量向量且对延迟敏感的应用,GPU版本是重要的性能保障。
评估与参数调优支持
FAISS不仅提供检索功能,还包含用于评估检索效果和调优索引参数的配套代码。开发者可以借助这些工具衡量召回率、比较不同索引配置的表现,从而针对具体业务场景找到精度与性能的最佳平衡点。
聚类功能
除相似性搜索外,FAISS还提供稠密向量的聚类算法支持,可用于对向量集合进行分组分析,为数据探索和索引构建(如IVF的聚类中心训练)提供基础能力。
使用方法
使用FAISS的典型流程包括以下几个步骤:
- 环境安装:可通过conda安装faiss-cpu或faiss-gpu包,也可从源码编译。Python用户安装后即可导入faiss模块使用。
- 准备向量数据:将待检索的数据转换为稠密向量形式(如通过嵌入模型生成),并整理为浮点数组。
- 构建索引:根据数据规模和精度需求选择合适的索引类型,创建索引对象并调用add方法将向量加入索引。对于IVF等索引,还需先用训练数据对索引进行训练。
- 执行搜索:对查询向量调用search方法,返回最相近的k个向量及其距离。
- 评估与调优:利用FAISS的评估工具衡量召回率,调整nprobe等参数优化检索效果。
FAISS同时提供C++ API和Python接口,官网文档包含完整的类列表、文件列表、命名空间列表和结构体列表,方便开发者查阅。
产品优势
| 对比维度 | FAISS表现 |
|---|---|
| 检索规模 | 可支持十亿级向量,甚至处理无法完全放入内存的向量集合 |
| 性能 | C++底层实现加GPU加速,检索速度业界领先 |
| 灵活性 | 多种索引类型可选,精度与效率可自由权衡 |
| 生态 | 开源免费,Python封装完善,社区活跃 |
应用场景
- RAG系统:作为检索增强生成系统的向量检索后端,为LLM提供相关知识片段。
- 智能问答平台:在海量文档向量中快速定位与问题最相关的内容。
- 文本相似度比对:用于查重、语义匹配等任务。
- AI搜索系统:支撑以向量为核心的语义搜索引擎。
- 推荐系统:通过向量相似性发现相似物品或内容。
- 图像检索:基于图像特征向量实现以图搜图。
总体而言,FAISS是构建现代AI检索应用不可或缺的底层工具,尤其适合需要处理大规模向量且对检索性能有较高要求的开发团队。
核心功能
优缺点分析
适用人群
常见问题


