

详细介绍
工具简介
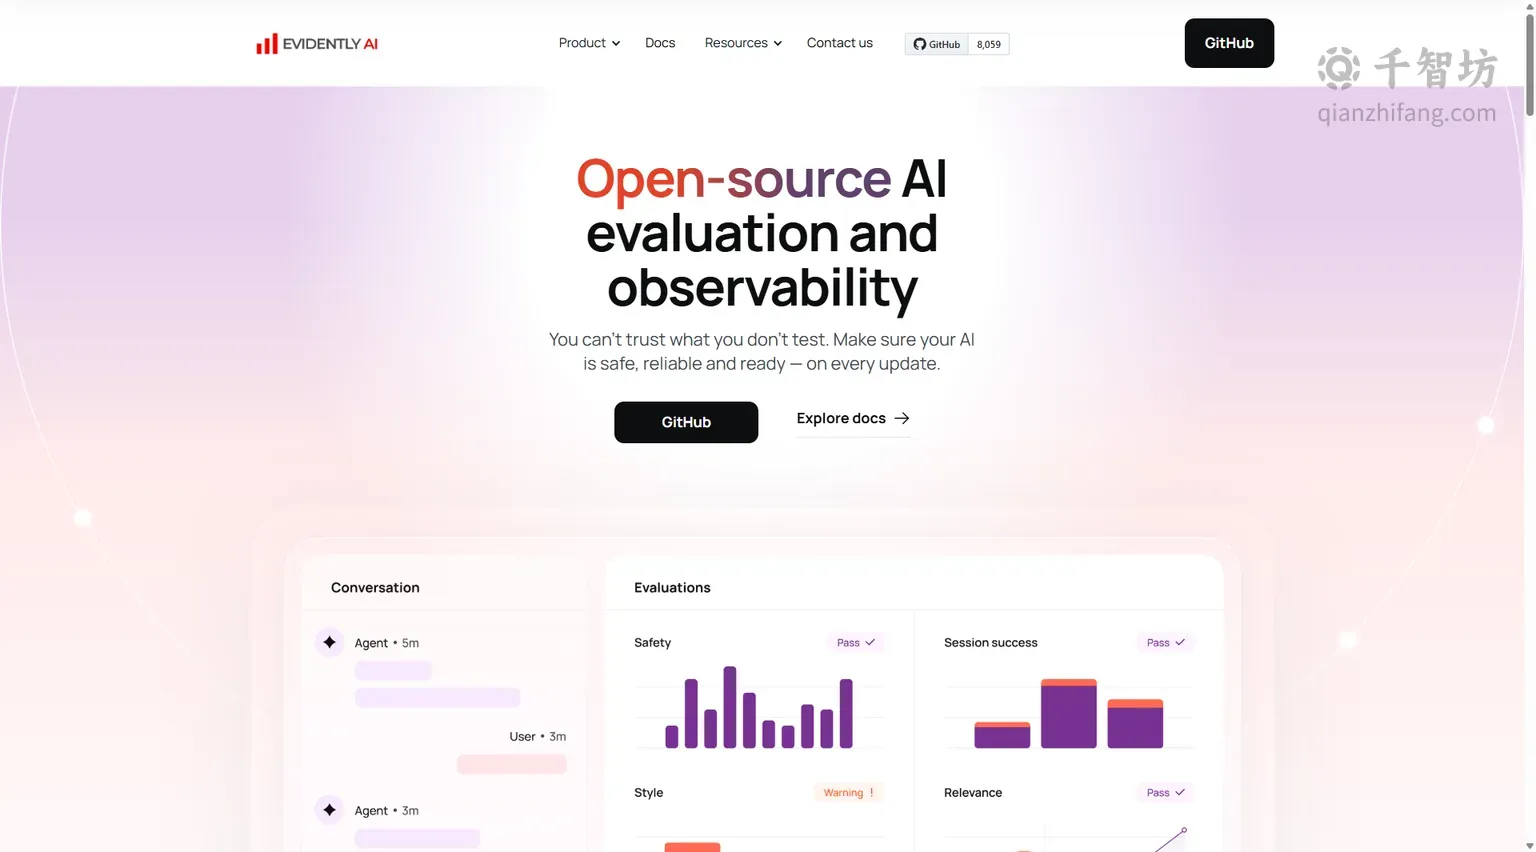
Evidently AI 是一款领先的开源 AI 评估与可观测性框架,致力于帮助开发者和数据科学团队系统性地评估、测试并监控大语言模型(LLM)、RAG 应用、AI Agent 以及传统机器学习模型的运行表现。该工具以 Apache 2.0 协议完全开源,目前在 GitHub 上已获得超过 7500 颗星,累计下载量突破 4000 万次,社区成员超过 3000 人,是 AI 工程领域广受认可的基础设施级项目。
与传统软件测试不同,基于 AI 的系统具有非确定性特征,其失败模式也更加隐蔽和多样。Evidently AI 的核心理念是“未经测试的东西就无法被信任”——只有通过持续的评估与监控,才能确保 AI 系统在每一次更新迭代中都保持安全、可靠和可用。该工具正是围绕这一理念构建了一整套从测试用例生成、自动化评估到持续监控的完整工作流。
主要功能
1. LLM 与 AI Agent 质量评估
Evidently AI 提供了一套系统化的评估机制,能够对 LLM 输出质量、安全性和可靠性进行量化打分。平台内置了 100 多种评估指标,覆盖幻觉与事实性检测、PII(个人身份信息)泄露识别、检索质量与上下文相关性评估、情感与毒性分析、语气与触发词监控、格式与指南遵循度检查等维度。用户既可以直接调用这些内置指标,也可以使用任意提示词、模型或规则自定义评估逻辑,从而针对具体业务场景构建专属的 AI 质量体系。
2. 预测性机器学习系统监控
对于传统机器学习模型,Evidently AI 提供了数据漂移(Data Drift)追踪和预测质量监控能力。随着线上数据分布的变化,模型性能可能逐渐衰减,该工具能够实时捕捉数据分布偏移、特征异常和预测质量下降等信号,帮助团队在问题扩大之前及时介入。评估结果可以通过可共享的可视化报告呈现,便于团队协作分析。
3. 合成数据生成
测试 AI 系统需要大量贴近真实场景的输入数据,尤其是边界情况和对抗性样本。Evidently AI 支持生成逼真的合成数据,包括边缘案例输入和对抗性攻击提示(从无害提示到恶意攻击),帮助团队在模型上线前充分暴露潜在风险。这一功能对于安全测试和红队演练尤其有价值。
4. 持续监控与实时仪表盘
Evidently AI 提供实时监控仪表盘,持续跟踪评估结果和日常质量检查指标。团队可以借此及早发现模型漂移、性能回归和新兴风险,将“一次性测试”升级为“全生命周期监控”。评估任务可以嵌入到 CI/CD 流水线中,实现每次更新自动运行评估并生成报告。
5. 可共享的可视化报告
所有评估和监控结果都可以生成直观的可视化报告,支持团队内部分享与讨论。报告内容涵盖指标趋势、异常检测、数据分布对比等,降低了跨职能团队(如产品、工程、合规)之间的沟通成本。
6. 丰富的学习资源与社区支持
Evidently AI 官方提供了大量配套资源,包括 250 个 LLM 基准测试与数据集、800 个 ML 与 LLM 用例、45 个以上内部 ML/AI 平台案例,以及关于 AI 可观测性和 MLOps 的系列教程与深度指南。官方还开设了免费的 LLM 评估与 AI 可观测性课程,并面向 AI 构建者提供应用型课程,帮助用户快速上手。
使用方法
Evidently AI 以 Python 库的形式提供,典型使用流程如下:
- 安装与集成:通过 pip 安装 Evidently 库,将其集成到现有的数据管道或模型训练流程中。
- 定义评估数据集:准备参考数据集(基准)和当前数据集(待评估),或使用内置合成数据生成功能构造测试用例。
- 选择或自定义指标:从 100+ 内置指标中挑选适合的评估维度,或编写自定义评估提示词与规则。
- 运行评估:执行评估任务,生成可视化报告,查看各项指标得分与异常项。
- 嵌入流水线:将评估步骤加入 CI/CD 流水线,实现每次模型更新自动触发测试。
- 持续监控:部署实时仪表盘,长期跟踪质量指标,设置告警阈值,及时发现漂移与回归。
产品优势
| 对比维度 | Evidently AI 的特点 |
|---|---|
| 开源协议 | Apache 2.0 完全开源,可自由使用、修改和分发 |
| 覆盖范围 | 统一框架同时支持 LLM、RAG、AI Agent 和传统 ML 模型 |
| 评估指标 | 内置 100+ 指标,支持自定义扩展 |
| 社区规模 | 7500+ GitHub Stars,4000 万+ 下载,3000+ 社区成员 |
| 工作流闭环 | 从合成数据生成、自动化评估到持续监控的端到端覆盖 |
应用场景
- LLM 应用上线前测试:在聊天机器人、问答系统上线前系统评估幻觉率、PII 泄露风险和上下文相关性。
- RAG 系统质量保障:监控检索质量与生成内容的事实一致性,防止检索退化导致回答质量下降。
- AI Agent 安全评估:通过对抗性合成数据测试 Agent 对越狱提示和恶意输入的鲁棒性。
- 传统 ML 模型运维:持续追踪生产环境中的数据漂移和预测质量衰减。
- 合规与风险审计:生成可共享的评估报告,为内部审计和合规检查提供依据。
目标用户
Evidently AI 主要面向 AI 工程师、数据科学家、MLOps 团队、AI 产品经理以及负责 AI 系统合规与风险管理的相关人员。无论是构建 LLM 应用的初创团队,还是维护大规模 ML 系统的企业平台团队,都可以借助该工具建立系统化的 AI 质量保障体系。
核心功能
优缺点分析
适用人群
常见问题


