
详细介绍
工具简介
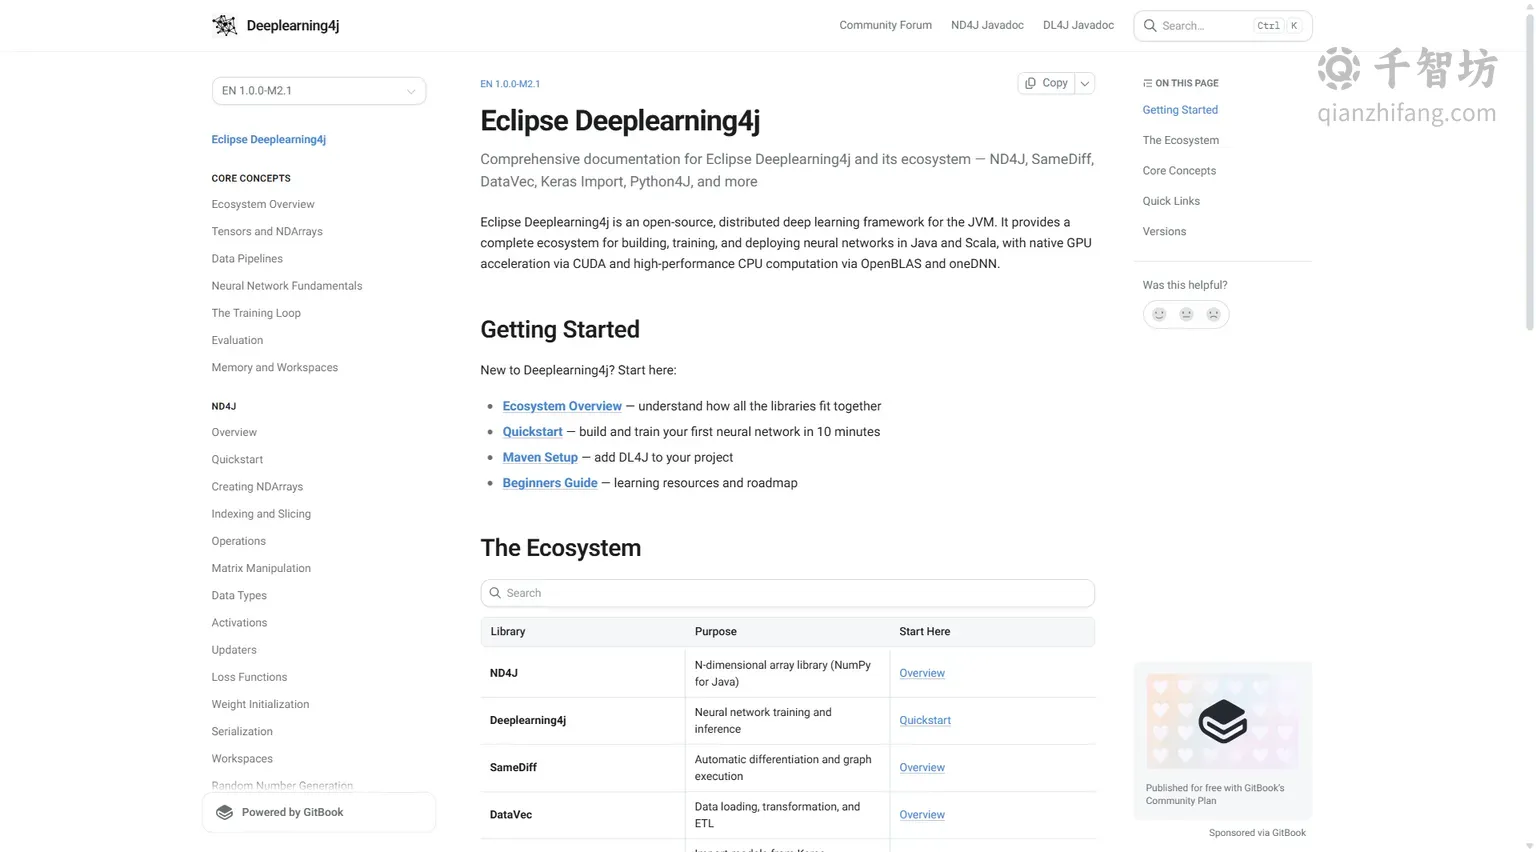
Eclipse Deeplearning4j(简称DL4J)是一款基于Java虚拟机(JVM)的开源深度机器学习框架,由Eclipse基金会管理并以Apache 2.0许可协议开源。它专为Java和Scala开发者量身打造,填补了深度学习领域长期以Python为主导而JVM生态相对空白的缺口。DL4J允许开发者在纯Java环境中完成从模型构建、训练到部署的全流程,同时保持与Python生态的良好兼容性,能够导入并再训练来自TensorFlow、PyTorch和Keras等主流框架的预训练模型。
DL4J并非单一组件,而是一个由多个子模块构成的完整技术栈。其中Nd4j是强大的张量操作库,为整个框架提供底层数值计算能力;SameDiff是类似TensorFlow和PyTorch的低层次API,支持自动微分和计算图;Datavec负责数据预处理,可将原始数据转换为适合神经网络处理的张量格式;此外还集成了Apache Spark,使分布式深度学习训练成为可能。底层通过Libnd4j提供C++支持,对数学运算进行优化,并可适配多种硬件设备。
对于企业级开发者而言,DL4J的最大价值在于它能够将深度学习能力直接嵌入到已有的Java微服务架构中。无论是构建图像分类、对象检测、图像分割系统,还是处理自然语言处理任务和时间序列预测,DL4J都提供了完整的解决方案。模型可以部署到JVM微服务、移动设备、物联网终端等多种环境中,实现边缘计算和实时智能决策。
主要功能
跨语言互操作与模型导入
DL4J支持Java、Scala和Python之间的无缝集成,开发者可以通过CPython绑定在Java项目中执行Python脚本。更重要的是,它能够导入、再训练来自TensorFlow、PyTorch和Keras的预训练模型,这意味着团队可以在Python生态中完成前沿研究,再将成熟模型迁移到JVM生产环境中进行微调和部署,极大降低了技术栈切换的成本。
完整的模型训练与部署链路
框架提供从数据加载、预处理、网络配置、训练到评估、保存的完整工具链。开发者可以通过DataSetIterator加载数据集,使用Datavec进行归一化和标准化等预处理操作,再通过API定义网络层数、神经元数量、激活函数和优化器等参数,最后调用fit方法训练模型,并用监听器实时监控训练进度和性能指标。
分布式计算与大数据集成
通过与Apache Spark的深度集成,DL4J支持在大规模分布式集群上执行深度学习任务,适合处理海量数据集。这一特性使其在推荐系统、大规模图像处理等需要处理TB级数据的场景中具有显著优势,能够充分利用企业已有的大数据基础设施。
跨平台部署能力
训练完成的模型可以灵活部署到多种环境中:JVM微服务、云端容器、移动设备以及物联网终端。这种跨平台特性使得同一套模型能够在数据中心完成训练后,直接下发到边缘设备执行推理,满足实时性和隐私保护的双重需求。
使用方法
环境准备
- 安装Java:DL4J基于JVM运行,推荐使用JDK 11或更高版本。
- 配置开发环境:推荐使用IntelliJ IDEA或Eclipse等支持Java的IDE,提升开发效率。
- 添加依赖:通过Maven或Gradle等构建工具,将DL4J相关依赖引入项目。
创建与配置项目
在IDE中新建Java项目后,确保正确导入DL4J依赖。随后使用框架提供的数据加载工具读取数据集,并通过Datavec模块完成数据预处理。接下来配置神经网络结构,定义层数、每层神经元数量、激活函数、优化器等核心参数。
训练与评估
调用fit方法启动训练,训练过程中可通过ScoreIterationListener等监听器监控损失值和性能指标。训练完成后,使用测试数据集评估模型准确率、召回率等指标,并将模型保存到文件中供后续部署使用。
产品优势
| 对比维度 | DL4J优势说明 |
|---|---|
| 语言生态 | 原生支持Java和Scala,无需切换语言即可在企业级JVM项目中集成深度学习 |
| 模型兼容 | 可导入TensorFlow、PyTorch、Keras模型,保护已有AI资产 |
| 部署灵活 | 支持微服务、移动端、物联网设备等多环境部署 |
| 大数据协同 | 与Apache Spark集成,适配分布式训练场景 |
| 开源许可 | Apache 2.0协议,商业使用友好 |
应用场景
- 企业级应用开发:在已有Java/Scala技术栈中直接嵌入深度学习能力,适合金融、电商、制造等行业的智能化升级。
- 模型迁移与再训练:将Python生态中训练好的模型导入JVM环境进行微调,兼顾研究灵活性与生产稳定性。
- 微服务与云计算:将模型封装为JVM微服务,在云环境中提供高性能、可扩展的智能服务。
- 移动设备与物联网:把模型部署到边缘设备,实现本地化实时推理,降低延迟并保护数据隐私。
- 大数据分析:结合Spark处理海量数据,支撑大规模推荐、风控、预测等任务。
核心功能
优缺点分析
适用人群
常见问题


