
详细介绍
工具简介
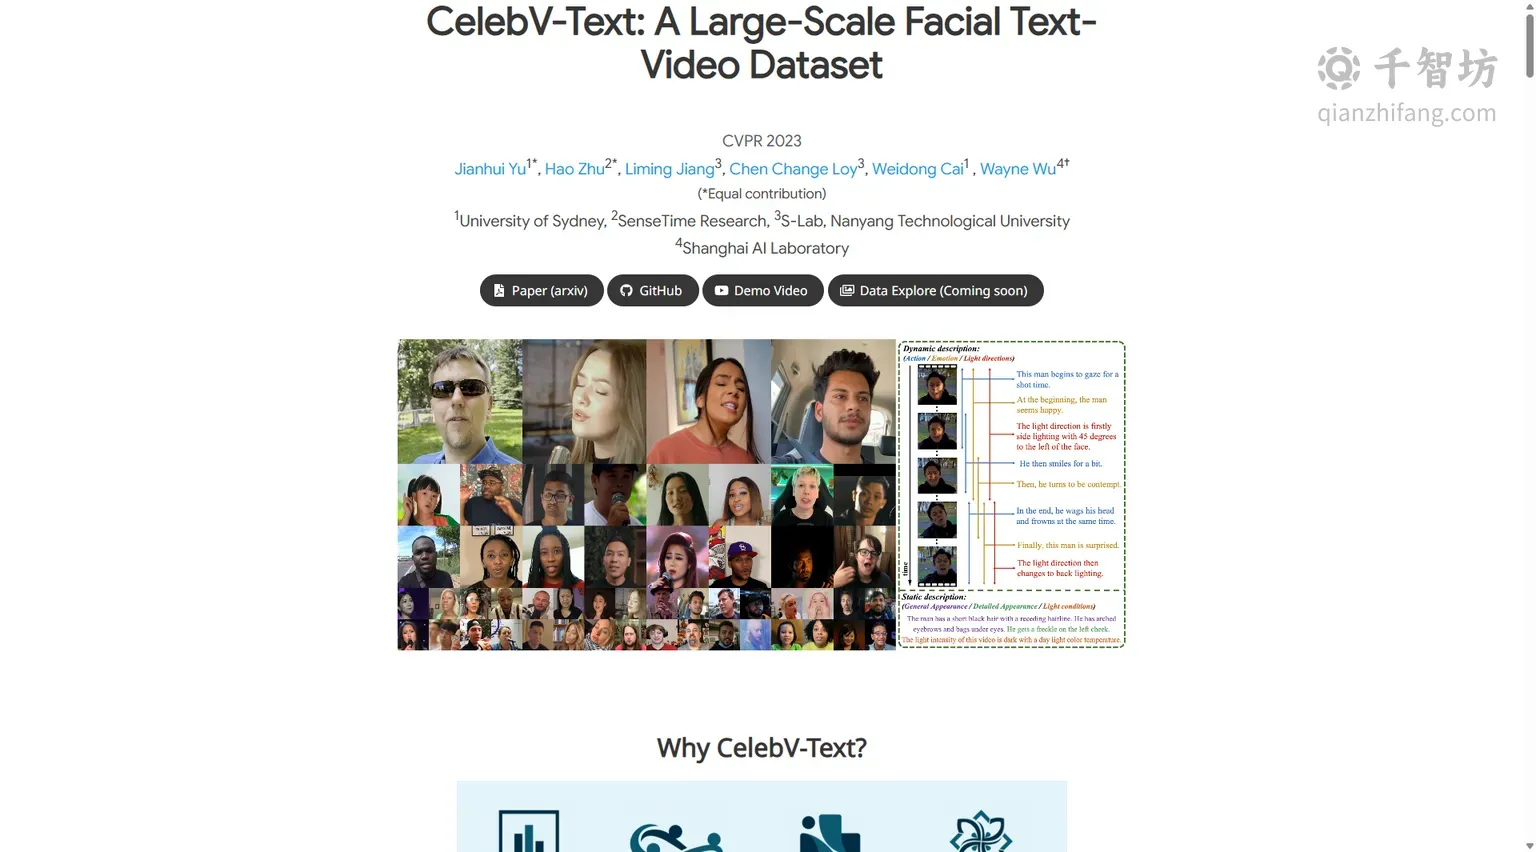
CelebV-Text 是一个由悉尼大学、商汤科技、南洋理工大学 S-Lab 以及上海人工智能实验室联合推出的大规模、高质量、多样化的面部文本-视频数据集,相关论文已被 CVPR 2023 收录。该数据集旨在推动面部中心(face-centric)的文本到视频生成任务的研究。当前,文本驱动的生成模型在视频编辑领域蓬勃发展,但针对面部文本到视频生成,仍面临严峻挑战,主要瓶颈在于缺乏一个同时具备高质量视频和高度相关文本的合适数据集。CelebV-Text 的诞生正是为了解决这一痛点。
该数据集包含 70,000 个野外(in-the-wild)面部视频片段,总时长约 279 小时,覆盖了丰富多样的视觉内容。每个视频片段都配对了 20 条由半自动文本生成策略生成的文本描述,这些文本能够精确地描述视频中的静态和动态属性。研究团队对数据集中的视频、文本以及文本-视频相关性进行了全面的统计分析,验证了其相较于其他数据集的优越性。此外,他们还进行了广泛的自我评估,展示了该数据集的有效性和潜力,并构建了一个基准测试(benchmark),以标准化面部文本到视频生成任务的评估。
主要功能
大规模高质量视频库
CelebV-Text 的核心是一个包含 70,000 个面部视频片段的数据集,总时长约 279 小时。这些视频均为野外采集,涵盖了多样的视觉内容,包括不同的光照条件、面部表情、动作和外观特征。视频的高质量和多样性确保了数据集能够支持训练出鲁棒性强的生成模型。
丰富的文本标注
每个视频片段都配有 20 条精心生成的文本描述,这些描述覆盖了 6 个设计好的属性类别:40 种一般外观、5 种详细外观、6 种光照条件、37 种动作、8 种情绪以及 6 种光照方向。这种半自动的文本生成策略能够精确地捕捉视频中的静态和动态属性,使得文本与视频内容高度相关。
全面的统计分析
数据集提供了对视频属性分布、文本分布以及文本-视频相关性的详细统计分析。这些分析不仅验证了数据集在各类属性上的多样性分布,还证明了生成的文本具有多样性、自然性和可扩展性,并且与视频内容高度相关。
标准化基准测试
为了标准化面部文本到视频生成任务的评估,研究团队构建了一个基准测试,并采用了代表性的方法进行评测。这为后续研究提供了统一的比较平台,有助于推动该领域的技术进步。
数据探索与演示
官网提供了数据探索(Data Explore)功能的预览(即将推出),以及视频演示(Demo Video),让用户能够直观地了解数据集的内容和质量。此外,还提供了论文、补充材料、GitHub 代码库等资源,方便研究人员获取和使用。
使用方法
CelebV-Text 主要面向学术研究和商业应用中的研究人员和开发者。用户可以通过以下步骤获取和使用该数据集:
- 访问官网:前往 https://celebv-text.github.io 了解数据集详情。
- 阅读论文:查阅 CVPR 2023 论文《CelebV-Text: A Large-Scale Facial Text-Video Dataset》,了解数据集的设计理念、构建方法和统计特性。
- 获取数据:通过 GitHub 仓库(https://github.com/celebv-text/CelebV-Text)获取数据下载链接和使用说明。请注意,数据集的使用可能需要遵守相应的许可协议。
- 数据探索:利用官网提供的数据探索工具(即将推出)浏览和筛选视频及对应的文本描述。
- 模型训练与评估:使用该数据集训练面部文本到视频生成模型,并利用提供的基准测试进行标准化评估。
产品优势
CelebV-Text 相较于其他面部视频数据集具有显著优势:
| 特性 | CelebV-Text | 其他数据集 |
|---|---|---|
| 数据规模 | 70,000 视频片段,约 279 小时 | 通常规模较小 |
| 文本标注 | 每视频 20 条文本,覆盖 6 类属性 | 文本标注较少或缺失 |
| 文本-视频相关性 | 高度相关,半自动生成策略 | 相关性参差不齐 |
| 属性多样性 | 外观、光照、动作、情绪等多维度 | 属性覆盖有限 |
| 基准测试 | 提供标准化评估基准 | 缺乏统一评估标准 |
此外,该数据集由多家知名学术机构联合发布,经过同行评审(CVPR 2023),具有较高的学术认可度和可靠性。其半自动文本生成策略在保证文本质量的同时,实现了大规模标注,为面部文本到视频生成研究提供了宝贵资源。
应用场景
- 学术研究:用于面部文本到视频生成模型的训练和评估,推动计算机视觉和生成式 AI 领域的发展。
- 视频编辑与特效:基于文本描述生成或编辑面部视频,应用于影视制作、社交媒体内容创作等。
- 虚拟数字人:训练模型根据文本生成逼真的面部动画,用于虚拟主播、虚拟助手等场景。
- 隐私保护:研究面部视频的合成与匿名化技术。
- 基准测试开发:为面部生成任务提供标准化的评估数据集。
核心功能
优缺点分析
适用人群
常见问题


