
详细介绍
工具简介
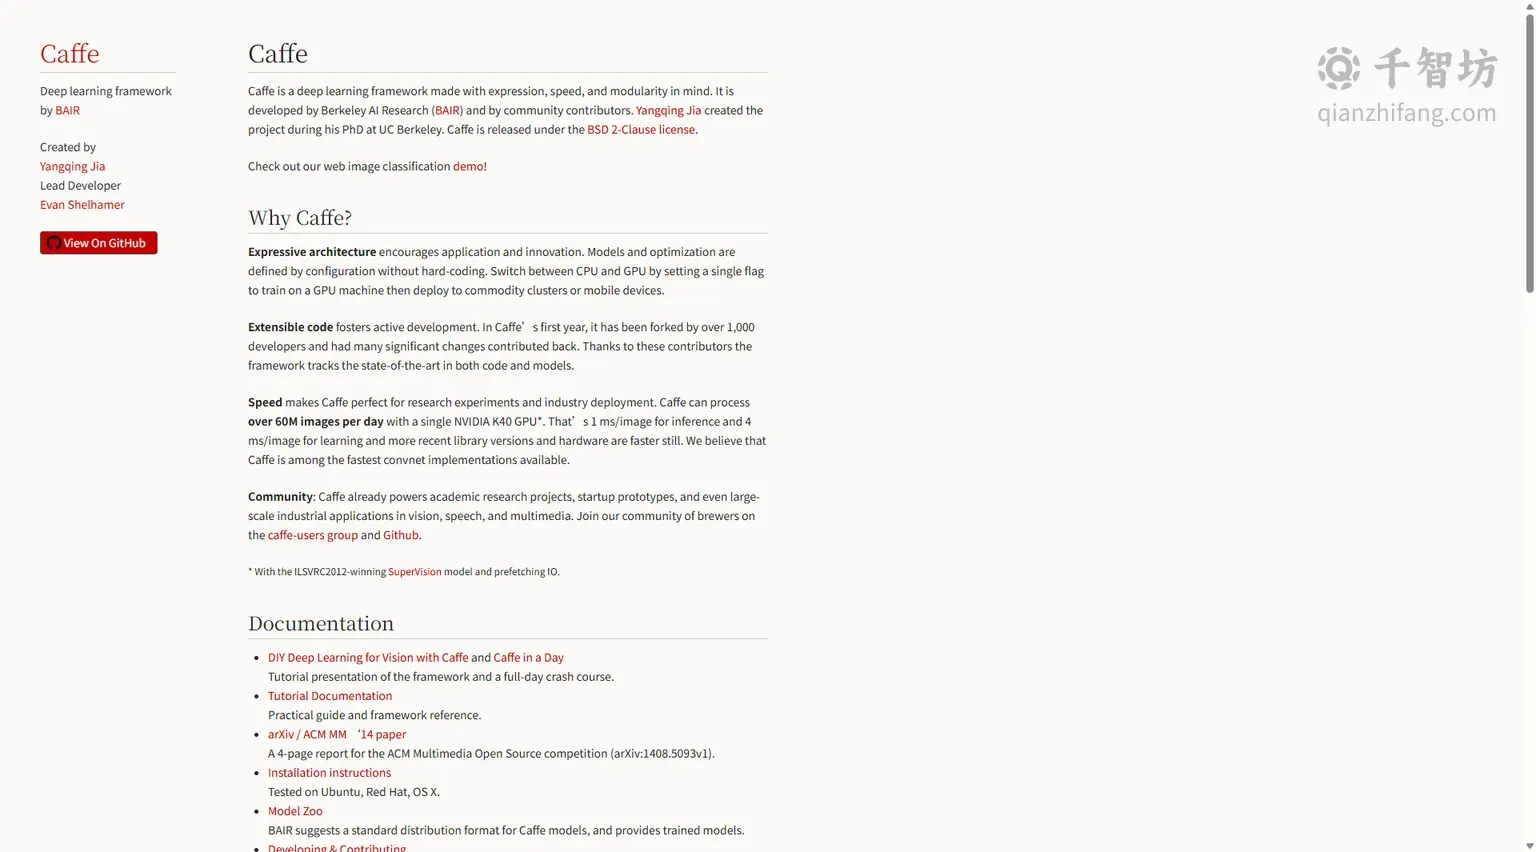
Caffe(全称Convolutional Architecture for Fast Feature Embedding,即快速特征嵌入的卷积架构)是一款由加州大学伯克利分校伯克利人工智能研究团队(BAIR)开发并维护的开源深度学习框架。该项目最初由Yangqing Jia在其博士研究期间创建,后由Evan Shelhamer担任首席开发者,并吸引了全球众多社区贡献者共同参与。Caffe采用BSD 2-Clause开源许可证发布,允许开发者和研究者在商业与学术场景中自由使用和修改。
Caffe的设计哲学围绕三个核心理念展开:表达性(Expression)、速度(Speed)和模块化(Modularity)。与许多需要大量手写代码的框架不同,Caffe中的模型定义和优化过程均通过配置文件完成,无需硬编码。开发者只需编写简单的配置文档即可描述网络结构、层类型、超参数等,大大降低了模型搭建的门槛。同时,只需设置一个标志位,就能在CPU和GPU模式之间切换,使得研究者可以在GPU机器上训练模型,然后部署到普通集群或移动设备上。
Caffe在深度学习发展史上具有重要地位。2012年,AlexNet(SuperVision模型)在ILSVRC图像分类竞赛中以显著优势夺冠,而Caffe正是承载这一突破性成果的重要框架之一。凭借其出色的性能,Caffe在发布后的第一年就被超过1000名开发者fork,社区贡献了大量重要改进,使框架在代码和模型两方面都保持在当时的最前沿水平。2017年4月,Facebook发布了Caffe2,增加了递归神经网络(RNN)等新功能;2018年3月底,Caffe2被正式并入PyTorch生态,标志着这一框架血脉的延续与演进。
主要功能
1. 配置驱动的模型定义
Caffe最显著的特点是其表达性架构。模型和优化过程完全通过配置文件(prototxt格式)定义,开发者无需编写大量代码即可描述复杂的神经网络结构。这种设计鼓励应用创新,使得研究人员可以快速实验不同的网络架构,而不必陷入繁琐的编程细节。配置文件采用Protocol Buffer格式,结构清晰、易于阅读和修改,极大提升了模型原型的迭代效率。
2. CPU/GPU无缝切换
Caffe支持通过单一标志位在CPU和GPU模式之间切换。这意味着开发者可以在配备GPU的工作站上快速训练模型,然后将训练好的模型部署到没有GPU的普通集群或移动设备上进行推理。这种灵活性使得Caffe既适合研究实验,也适合工业级部署,大大降低了从研发到生产的迁移成本。
3. 卓越的运行速度
速度是Caffe的核心竞争力之一。根据官方数据,使用单块NVIDIA K40 GPU,Caffe每天可以处理超过6000万张图像,相当于每张图像推理仅需1毫秒,学习训练每张图像约需4毫秒。随着后续硬件和库版本的升级,实际速度还会更快。官方认为Caffe是当时最快的卷积网络实现之一。这一性能优势使其在需要处理大规模图像数据的场景中表现尤为突出。
4. 丰富的模型库(Model Zoo)
Caffe提供了Model Zoo,BAIR建议采用标准的分发格式来共享Caffe模型。开发者可以直接下载预训练模型,用于图像分类、特征提取等任务,也可以在此基础上进行微调(fine-tuning),快速适配自己的应用场景。这大大降低了深度学习入门门槛,避免了从零开始训练模型所需的大量时间和计算资源。
5. 可扩展的代码架构
Caffe的代码具有高度可扩展性,鼓励活跃的社区开发。在项目发布的第一年,就有超过1000名开发者fork了代码库,并贡献了许多重要改进。这种开放的贡献模式使得框架能够持续跟踪最新的技术进展,在代码质量和模型多样性方面保持领先。开发者可以根据需要添加新的层类型、损失函数或数据预处理方式。
6. 完整的文档与教程体系
Caffe提供了丰富的学习资源,包括《DIY Deep Learning for Vision with Caffe》和《Caffe in a Day》等教程演示文稿,涵盖框架介绍和全天速成课程。此外还有详细的教程文档、安装指南(已在Ubuntu、Red Hat、OS X上测试)、以及发表于arXiv/ACM MM 2014的4页技术报告(arXiv:1408.5093v1),为不同层次的使用者提供了从入门到进阶的完整路径。
使用方法
使用Caffe通常遵循以下流程:
- 环境安装:根据官方安装指南,在Ubuntu、Red Hat或OS X系统上配置依赖项并编译安装Caffe。
- 数据准备:将图像等数据转换为Caffe支持的格式(如LMDB或LevelDB),并编写数据层配置。
- 模型定义:使用prototxt配置文件定义网络结构(train_val.prototxt)和求解器参数(solver.prototxt)。
- 训练模型:通过命令行工具caffe train启动训练,可指定GPU或CPU模式。
- 模型评估与调优:利用验证集评估模型性能,调整超参数或网络结构。
- 部署推理:将训练好的模型部署到目标环境,使用caffe test或相关接口进行推理预测。
产品优势
| 优势维度 | 具体表现 |
|---|---|
| 速度 | 单卡K40 GPU每天处理超6000万张图像,推理1ms/张,训练4ms/张 |
| 易用性 | 配置文件定义模型,无需硬编码,降低开发门槛 |
| 部署灵活性 | CPU/GPU一键切换,训练与部署环境解耦 |
| 社区生态 | 首年超1000次fork,Model Zoo提供丰富预训练模型 |
| 学术影响力 | 承载AlexNet等里程碑模型,被大量学术和工业项目采用 |
应用场景
- 学术研究:Caffe已支持众多学术研究项目,是计算机视觉领域论文复现和实验的常用框架。
- 创业原型开发:快速搭建图像分类、目标检测等原型系统,验证产品概念。
- 工业级视觉应用:在视觉、语音和多媒体领域的大规模工业应用中发挥作用,如内容审核、图像检索等。
- 教学培训:凭借清晰的配置体系和丰富教程,适合深度学习入门教学。
值得一提的是,虽然Caffe原始版本已不再活跃开发,其后续Caffe2已并入PyTorch生态,但Caffe在深度学习框架演进史上的地位不可忽视,其设计理念深刻影响了后续框架的发展。对于学习深度学习框架原理、维护遗留项目或研究经典视觉模型的用户而言,Caffe仍然是值得了解的重要工具。
核心功能
优缺点分析
适用人群
常见问题


