
详细介绍
工具简介
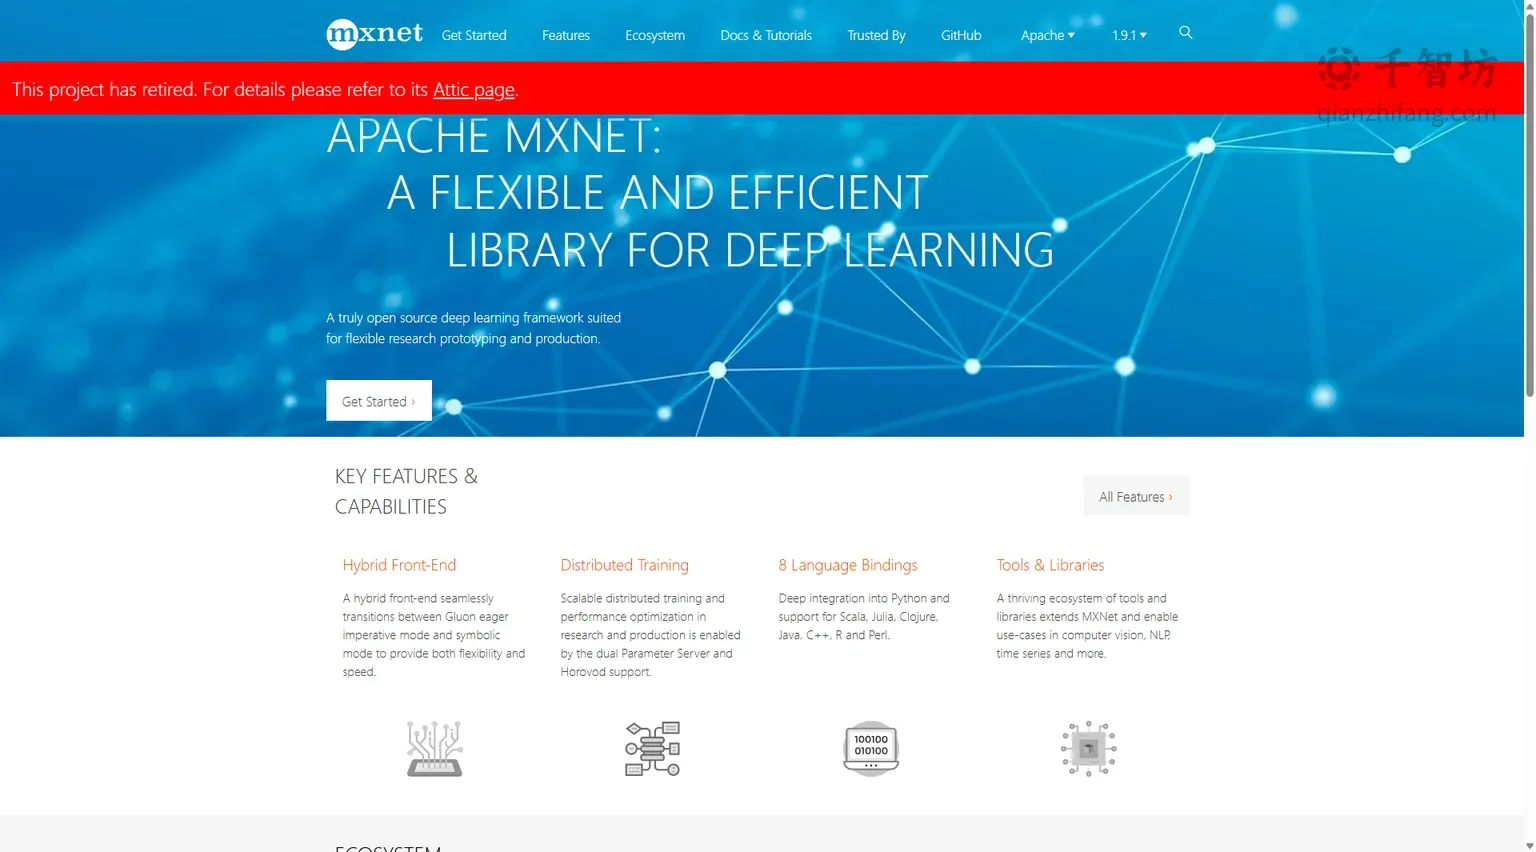
Apache MXNet 是由 Apache 软件基金会(Apache Software Foundation)孵化和维护的一款真正意义上的开源深度学习框架。它最初由学术界与工业界的研究者共同推动,后进入 Apache 孵化器并成为顶级项目,凭借其灵活的编程模型和出色的扩展能力,在深度学习框架的演进史中占据了重要位置。根据官网信息,当前文档对应版本为 1.9.1,官网同时保留了从 0.11.0 到 master 的多个版本文档入口,方便开发者按需查阅历史版本。需要特别说明的是,官网首页已明确标注该项目已退役(retired),并提供了指向 Apache Attic 页面的链接,这意味着 MXNet 已进入维护归档阶段,但这并不影响它作为经典深度学习框架的技术参考价值与历史地位。
MXNet 的定位非常清晰:一个适用于灵活研究原型设计与生产部署的真正开源深度学习框架。这一定位贯穿了它的全部设计哲学。与许多偏重单一场景的框架不同,MXNet 试图在“研究友好”和“生产可用”之间取得平衡。它既提供了类似 PyTorch 的命令式(imperative)编程体验,让研究者可以像写普通 Python 代码一样逐行调试模型;又提供了符号式(symbolic)的图计算模式,让模型能够被编译优化、高效部署到生产环境。这种“双模式”能力,正是 MXNet 最具辨识度的技术标签。
主要功能
混合前端:命令式与符号式的无缝切换
MXNet 的核心创新之一是其混合前端(Hybrid Front-End)。传统深度学习框架往往在“易用性”和“执行效率”之间二选一:命令式框架(如早期 PyTorch)调试方便但性能优化空间有限,符号式框架(如早期 TensorFlow)执行高效但调试困难。MXNet 通过 Gluon 接口将两者统一起来——开发者可以用命令式模式逐行编写和调试网络,随后通过 hybridize() 一键将模型转换为符号图,从而获得图优化、算子融合、内存复用等性能收益。这种“先灵活开发、后高效部署”的流程,极大降低了从研究到生产的迁移成本,是 MXNet 区别于同期框架的关键设计。
分布式训练:参数服务器与 Horovod 双支持
在分布式训练方面,MXNet 提供了两条成熟的技术路线。其一是自研的参数服务器(Parameter Server)架构,它将模型参数分散存储在多台工作节点上,支持数据并行与模型并行,适合超大规模模型和集群环境;其二是对 Horovod 的支持,Horovod 是 Uber 开源的分布式训练框架,基于 Ring-AllReduce 通信策略,在多 GPU 场景下具有出色的扩展效率。双路支持意味着团队可以根据自身集群规模、网络拓扑和运维习惯灵活选型,既能在自建集群上使用参数服务器,也能在标准 MPI 环境中借助 Horovod 快速扩展。官方强调其在研究与生产场景中均具备可扩展的分布式训练与性能优化能力。
八种语言绑定:深度融入多语言技术栈
MXNet 对多语言的支持在同类框架中相当突出。官网明确列出了 8 种语言绑定:Python、Scala、Julia、Clojure、Java、C++、R 和 Perl。其中 Python 是深度集成的主推语言,拥有最完整的 API、教程和生态工具;Scala 绑定使其能够融入 Spark 大数据生态;Julia 和 R 则照顾到科学计算与统计分析社区;Java 和 C++ 绑定为 enterprise 级应用和嵌入式部署提供了可能;Clojure 与 Perl 则覆盖了特定技术栈的开发者群体。这种多语言策略让 MXNet 不仅能服务于算法研究员,也能被后端工程师、数据工程师和统计分析师直接使用,降低了跨团队协作的语言门槛。
工具与库生态
围绕核心框架,MXNet 构建了较为完整的工具与库生态。官方列出了包括 GluonCV(计算机视觉)、GluonNLP(自然语言处理)、GluonTS(时间序列)、InsightFace(人脸识别)等在内的多个高层库,这些库封装了常见任务的模型结构、预训练权重和训练脚本,开发者可以用少量代码完成图像分类、目标检测、文本分类、时间序列预测等任务。此外,MXNet 还提供了模型转换工具、可视化工具和性能分析工具,帮助开发者完成从实验到部署的全流程管理。
使用方法与上手路径
MXNet 的上手路径相对标准。开发者首先需要根据操作系统和硬件环境选择安装方式,官方提供 pip 安装包、预编译二进制包以及从源码编译等多种途径,并针对 CPU 与 GPU(CUDA)环境给出不同指引。安装完成后,可以通过 Gluon 接口定义网络层、损失函数和优化器,使用命令式模式进行训练与调试;待模型稳定后,调用 hybridize() 转换为符号图以提升推理性能。对于分布式场景,则需配置参数服务器集群或 Horovod 环境后启动多机多卡训练。官网的 Get Started、Features、Ecosystem、Docs & Tutorials 等栏目提供了从入门到进阶的完整文档体系。
产品优势与局限
MXNet 的优势集中体现在三个方面:灵活性(混合前端兼顾调试与性能)、可扩展性(双分布式方案支撑大规模训练)和多语言覆盖(8 种绑定适配多样技术栈)。同时它完全开源、由 Apache 基金会治理,许可证宽松,适合对开源合规性有要求的企业。但其局限同样明显:项目已退役进入 Attic,官方不再进行活跃的功能迭代与安全更新,社区活跃度和生态新鲜度无法与主流框架相比;此外,其学习资料以英文为主,中文社区规模相对有限,新手上手成本较高。
应用场景
尽管已退役,MXNet 仍在以下场景中具有参考和使用价值:学术研究中的快速原型验证、需要多语言协同的企业级机器学习平台、基于 Spark 的大规模数据处理流水线、以及对开源许可证和基金会治理有严格要求的组织。对于正在维护存量 MXNet 项目的团队,理解其混合前端与分布式训练机制,仍是保障系统稳定运行的关键。
核心功能
优缺点分析
适用人群
常见问题


