详细介绍
工具简介
Open LLM Leaderboard(开放大语言模型排行榜)是由Hugging Face旗下的H4团队维护运营的一个专注于开源大语言模型性能评测的在线平台。该工具的核心使命是为全球AI研究社区提供一个公开、透明、可复现的模型性能对比基准,帮助研究人员、开发者和企业用户在众多开源大语言模型中做出更明智的选择。
随着开源大语言模型生态的爆发式增长,Meta的Llama系列、Mistral AI的Mistral系列、阿联酋TII的Falcon系列、微软的Phi系列等众多模型层出不穷,如何客观评价这些模型的真实能力成为了一个亟待解决的问题。Open LLM Leaderboard正是在这一背景下应运而生,它通过一套标准化的评测基准,对提交的每一个模型进行统一测试,并将结果以排行榜的形式公开展示。
该排行榜最初基于EleutherAI的LM Evaluation Harness框架构建,围绕六大核心基准测试对模型进行综合评估。这些基准覆盖了常识推理、语言理解、数学推理、代码生成、知识问答等多个维度,能够较为全面地反映模型在不同任务场景下的表现。2024年,Hugging Face对排行榜进行了重大更新,引入了更严格的评测标准和新的基准测试集,以应对模型训练数据污染和评测过拟合等问题,进一步提升了排行榜的权威性和参考价值。
主要功能
标准化模型评测
Open LLM Leaderboard最核心的功能是对提交的开源大语言模型进行标准化评测。任何开发者或研究机构都可以将自己训练的模型提交到排行榜,系统会自动使用统一的评测流程和基准测试集对模型进行测试。这种标准化的评测方式确保了不同模型之间的结果具有可比性,避免了因评测方法差异导致的不公平比较。
多维度基准测试
排行榜采用多个权威基准测试集对模型进行综合评估,主要包括:
- AI2 Reasoning Challenge(ARC):评估模型的科学常识推理能力,包含小学到初中难度的科学选择题。
- HellaSwag:测试常识推理和情境理解能力,要求模型选择最合理的句子续写。
- MMLU(Massive Multitask Language Understanding):涵盖57个学科领域的多项选择题,全面评估模型的知识广度和深度。
- TruthfulQA:衡量模型回答的真实性和诚实度,检测模型是否会产生虚假信息。
- Winogrande:评估模型的常识推理和代词消解能力。
- GSM8K:测试小学数学应用题求解能力,反映模型的数学推理水平。
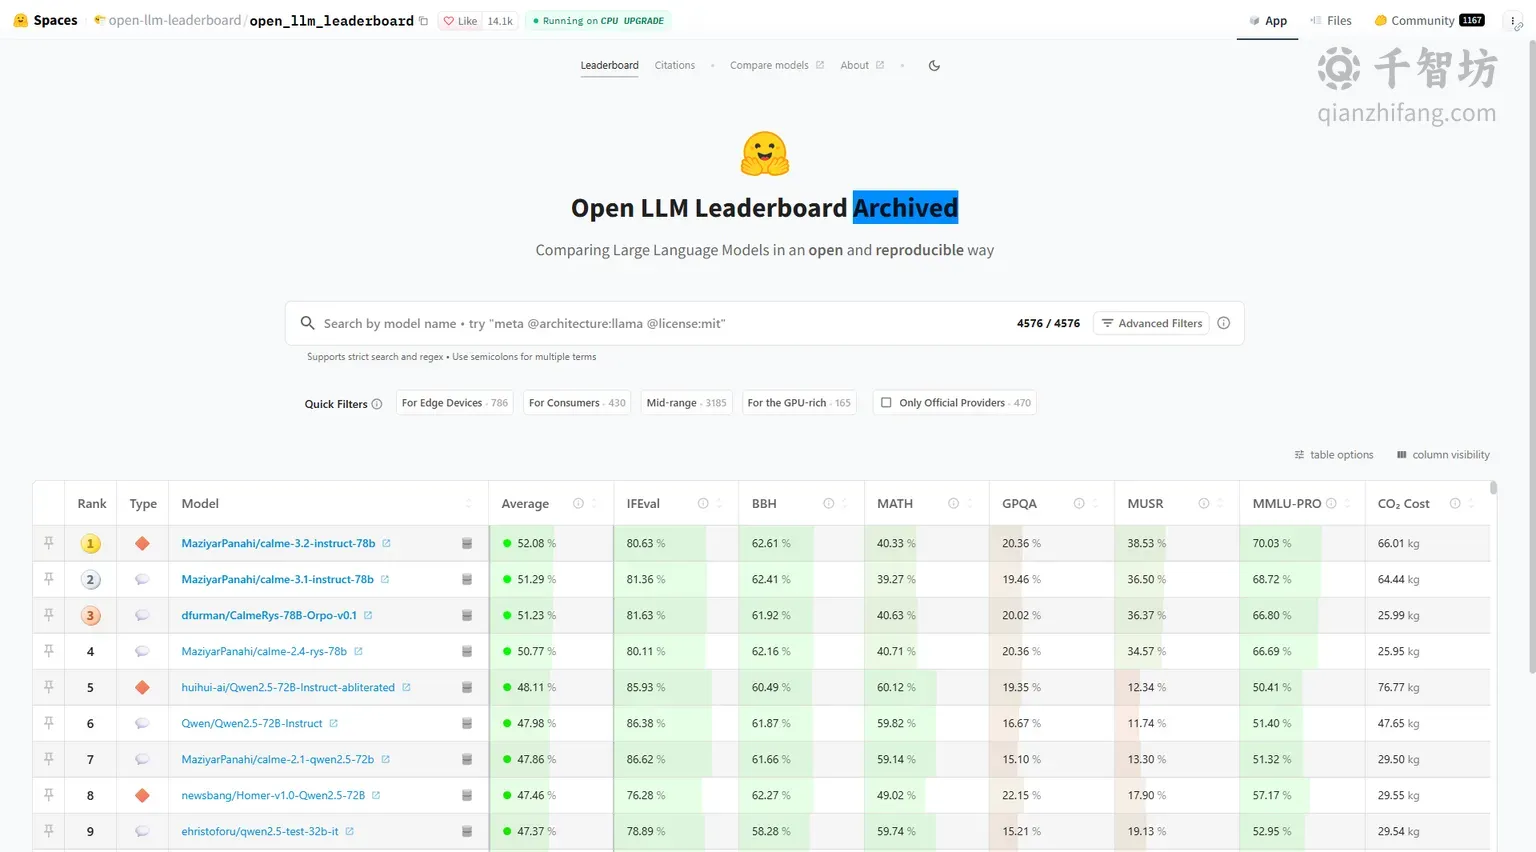
2024年更新后,排行榜还引入了BBH(BIG-Bench Hard)、GPQA、IFEval、MUSR、MMLU-PRO等更具挑战性的基准测试,以更准确地评估模型的高级推理能力。
实时排行榜展示
所有通过评测的模型会按照综合得分进行排名,并以表格形式在网页上实时展示。用户可以查看每个模型在各项基准测试中的具体得分、平均分、模型参数量、是否经过指令微调等信息。排行榜支持按不同维度排序和筛选,方便用户根据自身需求找到最适合的模型。
模型提交与自动化评测
模型开发者可以通过在Hugging Face模型仓库中添加特定的评估请求文件来提交模型。系统会自动拉取模型并运行评测流程,整个过程无需人工干预。评测完成后,结果会自动更新到排行榜中。这种自动化的流程大大降低了模型评测的门槛,使得更多开源模型能够获得公开展示的机会。
历史数据与趋势追踪
排行榜记录了模型评测的历史数据,用户可以观察不同模型在不同时间点的表现变化,了解开源大语言模型领域的整体发展趋势。这对于追踪技术进展、评估新模型是否真正带来了性能提升具有重要参考价值。
使用方法
查看排行榜
- 访问Open LLM Leaderboard的官方网站(https://huggingface.co/spaces/HuggingFaceH4/open_llm_leaderboard)。
- 在排行榜页面中,可以看到所有已评测模型的列表,默认按平均得分从高到低排序。
- 点击表头可以按不同基准测试的得分进行排序,也可以使用搜索框查找特定模型。
- 点击模型名称可以跳转到该模型在Hugging Face上的详情页面,查看模型卡、使用说明和下载链接。
提交模型进行评测
- 确保你的模型已经上传到Hugging Face模型仓库,并且是Transformers兼容的格式。
- 在模型仓库中创建一个名为
.eval_request的文件,或者在模型卡中添加特定的YAML配置。 - 系统会自动检测到评测请求,并将模型加入评测队列。
- 等待评测完成,结果会自动更新到排行榜中。评测时间取决于模型大小和排队情况。
产品优势
| 优势维度 | 具体说明 |
|---|---|
| 权威性 | 由Hugging Face官方团队维护,评测流程标准化,结果具有高度公信力 |
| 全面性 | 覆盖多个维度的基准测试,能够全面反映模型在不同任务上的表现 |
| 透明性 | 评测方法、基准测试集和评测代码全部开源,结果可复现 |
| 实时性 | 新模型提交后可快速获得评测结果,排行榜持续更新 |
| 免费开放 | 完全免费使用,无论是查看排行榜还是提交模型评测 |
应用场景
- 模型选型:开发者在选择开源大语言模型时,可以参考排行榜的评测结果,快速了解各模型的优劣势。
- 学术研究:研究人员可以基于排行榜数据开展模型能力分析、评测方法研究等工作。
- 模型优化:模型开发者可以通过排行榜了解自己的模型与竞品的差距,明确优化方向。
- 行业洞察:关注AI行业发展的从业者可以通过排行榜追踪开源大模型的技术演进趋势。
- 教学参考:AI课程教师和学生可以将排行榜作为了解大语言模型发展现状的教学素材。
总结
Open LLM Leaderboard作为开源大语言模型领域最具影响力的评测平台之一,为全球AI社区提供了一个客观、透明、可复现的模型性能对比基准。它不仅帮助用户在海量开源模型中快速找到最适合自己需求的模型,也推动了整个开源大模型生态的良性竞争和持续进步。无论你是AI研究者、应用开发者还是技术爱好者,Open LLM Leaderboard都是一个值得关注和使用的重要工具。
核心功能
优缺点分析
适用人群
常见问题


