详细介绍
工具简介
LMArena(原名Chatbot Arena)是由加州大学伯克利分校的研究团队主导开发的一个开放、透明的AI大模型评测平台。它的核心理念非常独特:不再依赖实验室自报的跑分数据,而是让真实用户在不知情的情况下与两个匿名AI模型进行对话,然后投票选出表现更好的那一个。这种“盲测”机制类似于AI领域的“图灵测试”,通过海量用户的真实投票数据,最终生成一个动态更新的模型排行榜(Leaderboard),成为业界公认的权威参考之一。
LMArena的诞生背景源于AI模型评测领域的一个长期痛点:各大厂商发布的基准测试成绩往往存在“刷榜”嫌疑,且实验室环境下的评测无法完全反映模型在真实对话中的表现。为了解决这个问题,LMArena团队构建了一个开放的竞技场,让模型在完全公平的条件下同台竞技。用户只需在网页上输入任意问题,系统会随机从模型池中抽取两个模型分别生成回答,用户根据回答质量投票后,系统才会揭晓两个模型的真实身份。这种设计有效避免了品牌偏见,确保了投票结果的客观性。
目前,LMArena已经评测了数百个AI模型,包括GPT-4o、Claude 3.5 Sonnet、Gemini 1.5 Pro、Llama 3等主流大语言模型,以及众多开源模型和新兴厂商的产品。平台不仅提供文本对话的排行榜,还扩展到了图像生成、代码编写、长文本理解等多个专项领域。其排行榜数据被广泛引用在学术论文、行业报告和媒体报道中,成为衡量AI模型综合能力的重要标尺。
主要功能
匿名对战与投票
这是LMArena最核心的功能。用户进入竞技场后,界面会同时呈现两个匿名模型的回答。用户可以与它们进行多轮对话,然后从“A更好”、“B更好”、“平局”或“都不好”中做出选择。投票后,两个模型的名称才会显示出来。这种机制确保了投票的公正性,因为用户在投票时完全不知道模型来自哪家公司、是开源还是闭源。
多维度排行榜
LMArena根据用户投票数据,通过Elo评分系统(类似国际象棋的等级分)计算出每个模型的综合排名。排行榜分为多个类别:总榜、文本对话榜、图像生成榜、代码能力榜、长文本榜、多语言榜等。每个榜单都会实时更新,反映模型的最新表现。用户还可以查看特定模型的详细评分、胜率、对战记录等数据。
模型对比与筛选
平台提供了强大的模型对比工具,用户可以同时选择多个模型进行并排对比,查看它们在相同问题下的回答差异。此外,还可以按照模型类型(开源/闭源)、参数规模、发布时间等条件进行筛选,方便用户快速找到符合需求的模型。
用户反馈与社区讨论
LMArena不仅是一个评测工具,也是一个社区。用户可以在平台上分享自己的测试案例、讨论模型表现、提出改进建议。平台还会定期发布分析报告,解读排行榜变化背后的技术趋势。
使用方法
第一步:进入竞技场
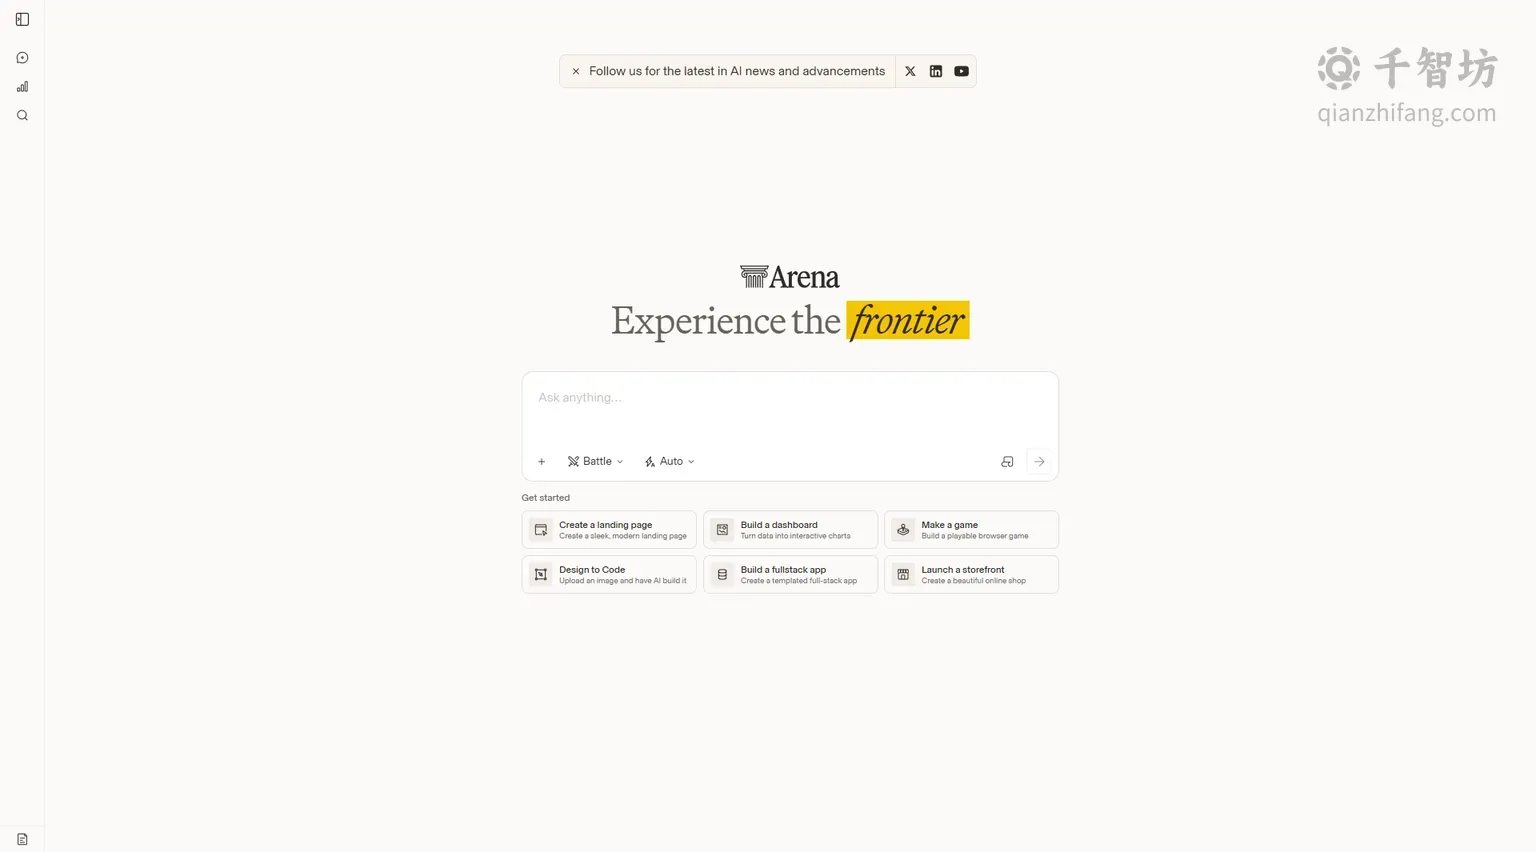
打开LMArena官网,点击“Arena”或“Chat”按钮,即可进入匿名对战界面。无需注册账号即可开始使用,但注册后可以保存对话记录和投票历史。
第二步:输入问题
在输入框中输入任何你想要测试的问题,可以是常识问答、逻辑推理、创意写作、代码生成等。系统会自动从模型池中随机抽取两个模型,分别生成回答。
第三步:评估与投票
仔细阅读两个模型的回答,判断哪个更好。你可以进行多轮对话,深入测试模型的理解能力和上下文连贯性。满意后,点击投票按钮。
第四步:查看结果
投票后,系统会显示两个模型的真实身份,并展示它们的当前排名和Elo评分。你可以继续发起新的对战,或者查看排行榜了解全局情况。
产品优势
- 客观公正:匿名盲测机制彻底消除了品牌偏见,投票结果完全基于回答质量。
- 数据量大:截至2024年,LMArena已收集超过百万次用户投票,样本量远超传统评测。
- 实时更新:排行榜随用户投票实时变化,能够快速反映新模型的表现。
- 完全免费:所有功能均免费开放,无需付费即可使用全部模型和查看排行榜。
- 社区驱动:用户既是评测者也是被评测者,形成了良性循环的生态系统。
应用场景
- AI研究者:通过排行榜了解最新模型的技术水平,为论文提供引用数据。
- 开发者:在选择API或开源模型时,参考LMArena的评测结果做出决策。
- 企业用户:评估不同模型在特定任务上的表现,为业务选型提供依据。
- 普通用户:体验最新AI模型,了解各模型的优缺点,找到最适合自己的助手。
技术特点
LMArena采用Elo评分系统,这是一种基于贝叶斯统计的排名算法,能够根据对战胜负关系动态调整每个模型的评分。与传统的静态基准测试不同,Elo评分会随着新投票的加入而不断更新,使得排行榜始终保持时效性。此外,平台还引入了“置信区间”概念,对于投票数较少的模型,其排名会显示较大的误差范围,提醒用户谨慎解读。
在模型接入方面,LMArena通过API与各大厂商的模型进行对接,确保用户能够实时体验到最新版本。平台还支持多模态输入,包括文本、图像等,使得评测范围覆盖了更广泛的AI能力。
总结
LMArena以其独特的匿名对战机制和开放的社区精神,为AI模型评测领域带来了一股清流。它不仅为研究者提供了可靠的参考数据,也为普通用户打开了一扇了解AI前沿的窗口。随着AI技术的飞速发展,LMArena的价值将愈发凸显,成为连接模型开发者与用户的重要桥梁。
核心功能
优缺点分析
适用人群
常见问题


