详细介绍
工具简介
OpenCompass(中文名“司南”)是由上海人工智能实验室推出的一款面向大模型领域的开源评测平台。它致力于为大型语言模型(LLM)的开源方与使用者提供一个公平、开放、可复现的基准测试环境。随着人工智能技术的飞速发展,各类大模型层出不穷,如何客观、全面地评估这些模型的能力,成为学术界和产业界共同关注的焦点。OpenCompass正是在这一背景下应运而生,它通过标准化的评测流程、丰富的评测数据集以及透明的榜单排名,帮助用户快速了解不同模型在各个维度上的表现。
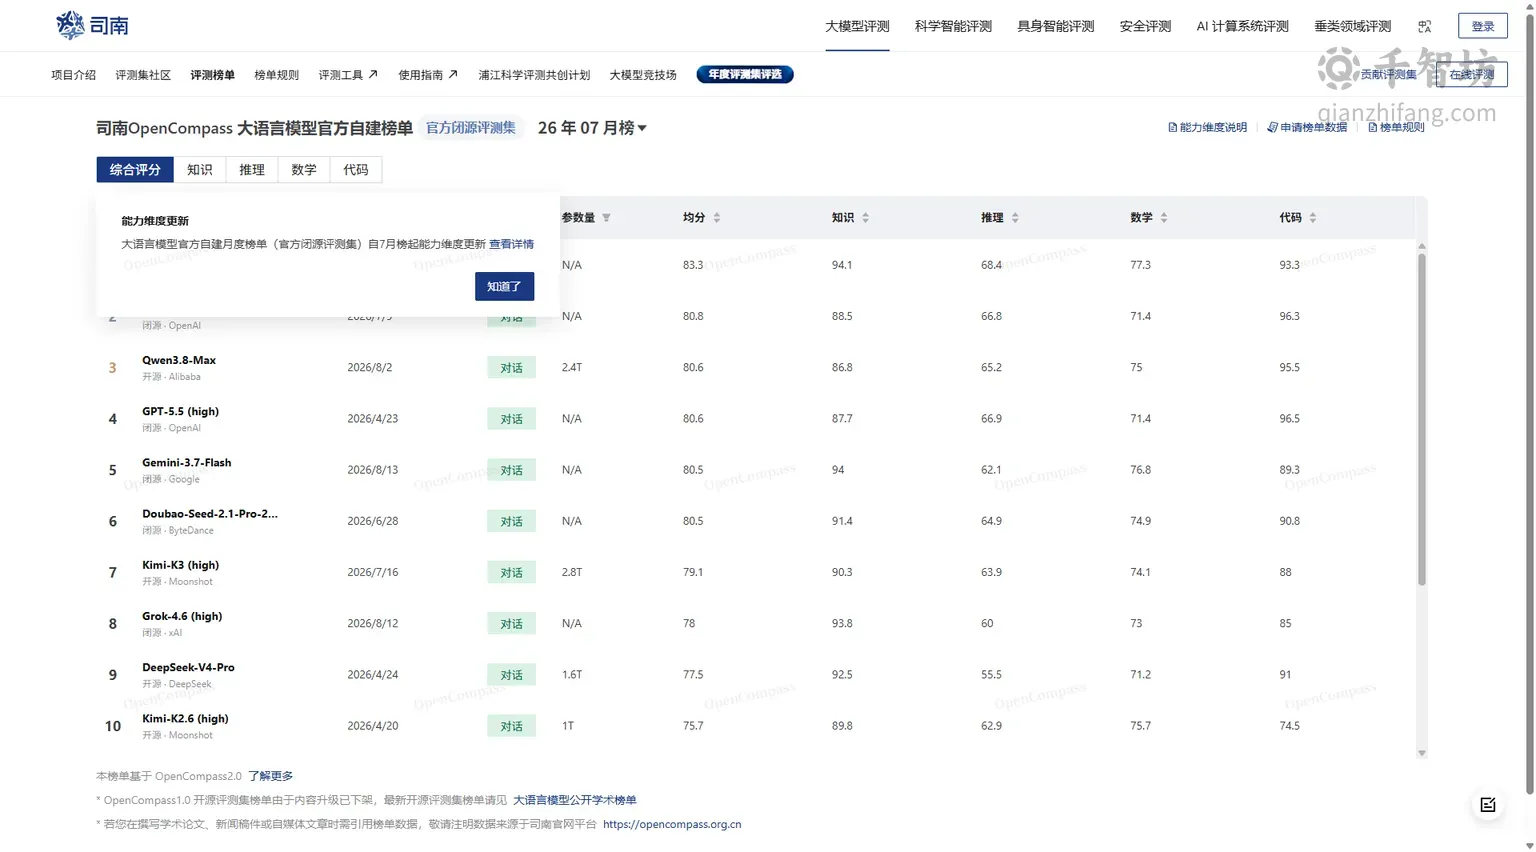
OpenCompass的官方网站提供了大模型评测榜单(Leaderboard),用户可以直观地查看各类模型在语言理解、知识问答、推理、代码生成、数学计算等任务上的得分和排名。同时,平台还提供了评测集社区、评测工具链以及详细的文档,方便开发者自行运行评测。作为一个开源项目,OpenCompass在GitHub上持续更新,吸引了大量研究机构和企业参与贡献,形成了活跃的生态。
主要功能
1. 大模型评测榜单
OpenCompass的核心功能之一是提供实时更新的评测榜单。榜单涵盖了国内外众多主流大模型,如GPT系列、Claude、文心一言、通义千问、智谱清言等。每个模型都会在多个维度的评测集上进行测试,最终以综合得分和细分得分的形式呈现。用户可以通过榜单快速对比不同模型的优劣,为模型选型提供数据支撑。
2. 丰富的评测数据集
平台集成了大量高质量的评测数据集,覆盖了语言理解、知识问答、逻辑推理、数学计算、代码生成、安全伦理等多个领域。这些数据集既有公开的学术基准,也有针对中文场景专门构建的评测集。OpenCompass还支持用户自定义评测集,满足特定场景下的评估需求。
3. 开源评测工具链
OpenCompass提供了一套完整的开源评测工具,支持分布式评测、自动化流程和可复现的实验配置。开发者可以通过简单的配置文件,指定待评测的模型和评测数据集,一键启动评测任务。工具链还支持多种推理后端,如HuggingFace、vLLM等,方便不同规模的模型进行评测。
4. 评测集社区
OpenCompass建立了评测集社区,鼓励研究者和开发者分享自己构建的评测集和评测结果。社区成员可以交流评测经验,讨论模型能力的改进方向,推动评测标准的不断完善。
5. 模型能力分析报告
除了榜单排名,OpenCompass还会定期发布模型能力分析报告,深入解读模型在不同任务上的表现差异、优势与短板。这些报告为模型研发者提供了改进方向,也为应用开发者提供了选型参考。
使用方法
使用OpenCompass进行模型评测通常分为以下几个步骤:
- 环境准备:在GitHub上克隆OpenCompass仓库,按照文档安装依赖环境。支持Python环境,建议使用conda创建虚拟环境。
- 配置评测任务:在配置文件中指定待评测的模型路径、评测数据集、推理后端等参数。OpenCompass提供了丰富的配置模板,用户可以根据需求修改。
- 启动评测:运行评测脚本,平台会自动加载模型和数据集,执行推理和评分。对于大规模模型,支持分布式评测以加速过程。
- 查看结果:评测完成后,结果会以表格和图表的形式展示,包括各项任务的得分和综合排名。用户可以将结果提交到官方榜单,与其它模型进行对比。
产品优势
| 优势 | 说明 |
|---|---|
| 开源开放 | 代码完全开源,评测流程透明,结果可复现,避免黑箱操作。 |
| 全面覆盖 | 评测数据集丰富,涵盖多语言、多任务、多维度,能够全面反映模型能力。 |
| 高效灵活 | 支持分布式评测和多种推理后端,评测速度快,配置灵活。 |
| 社区活跃 | 拥有活跃的开发者社区,持续更新评测集和榜单,紧跟模型发展。 |
| 权威认可 | 由上海人工智能实验室推出,在学术界和产业界具有较高认可度。 |
应用场景
- 模型研发:研发团队可以使用OpenCompass评估自研模型的能力,发现短板并针对性优化。
- 模型选型:企业在选择大模型时,可以参考OpenCompass榜单,结合自身业务需求选择最合适的模型。
- 学术研究:研究人员可以利用平台提供的评测集和工具,开展模型能力分析和对比实验。
- 教育教学:教师和学生可以通过OpenCompass了解大模型评测的基本方法和流程,学习模型评估知识。
总结
OpenCompass作为一款专业的大模型评测平台,凭借其开源、全面、高效的特点,已经成为大模型领域不可或缺的基础设施。无论是模型开发者、应用企业还是学术研究者,都能从中获得有价值的评测数据和分析报告。随着大模型技术的不断演进,OpenCompass也将持续更新评测标准和数据集,推动人工智能技术朝着更加透明、可靠的方向发展。
核心功能
优缺点分析
适用人群
常见问题


