详细介绍
工具简介
MMLU,全称Massive Multitask Language Understanding(大规模多任务语言理解),是由UC伯克利、哥伦比亚大学等机构的研究者(Hendrycks等人)于2020年提出的一项综合性语言模型评测基准。它并非一款传统意义上的软件工具或应用程序,而是一个用于评估大语言模型在广泛学科领域知识掌握程度的数据集与测试框架。在AI研究界,MMLU已经成为衡量模型智能水平最常被引用的标尺之一,几乎所有主流大模型在发布时都会公布其MMLU得分。
MMLU的核心设计理念是检验模型是否真正具备跨领域的通用知识理解能力,而不仅仅是擅长某一类任务。它包含约15,908道多选题,覆盖57个学科,从初等数学、美国历史、计算机科学、法律、医学到道德哲学、市场营销、专业会计等,难度横跨高中、大学乃至专业职业水平。这种广度使得MMLU能够较为全面地反映模型的知识储备与推理能力。
与许多单一任务的评测集不同,MMLU的题目全部采用四选一的选择题形式,模型需要在给定的选项中选择最合适的答案。评测指标为准确率(Accuracy),即模型答对题目的百分比。随机猜测的准确率约为25%,因此得分显著高于25%才意味着模型具备真实的理解能力。目前顶尖模型的MMLU得分已超过90%,而人类专家在部分学科上的准确率约为89.8%,这使MMLU成为衡量模型是否接近人类专家水平的重要参照。
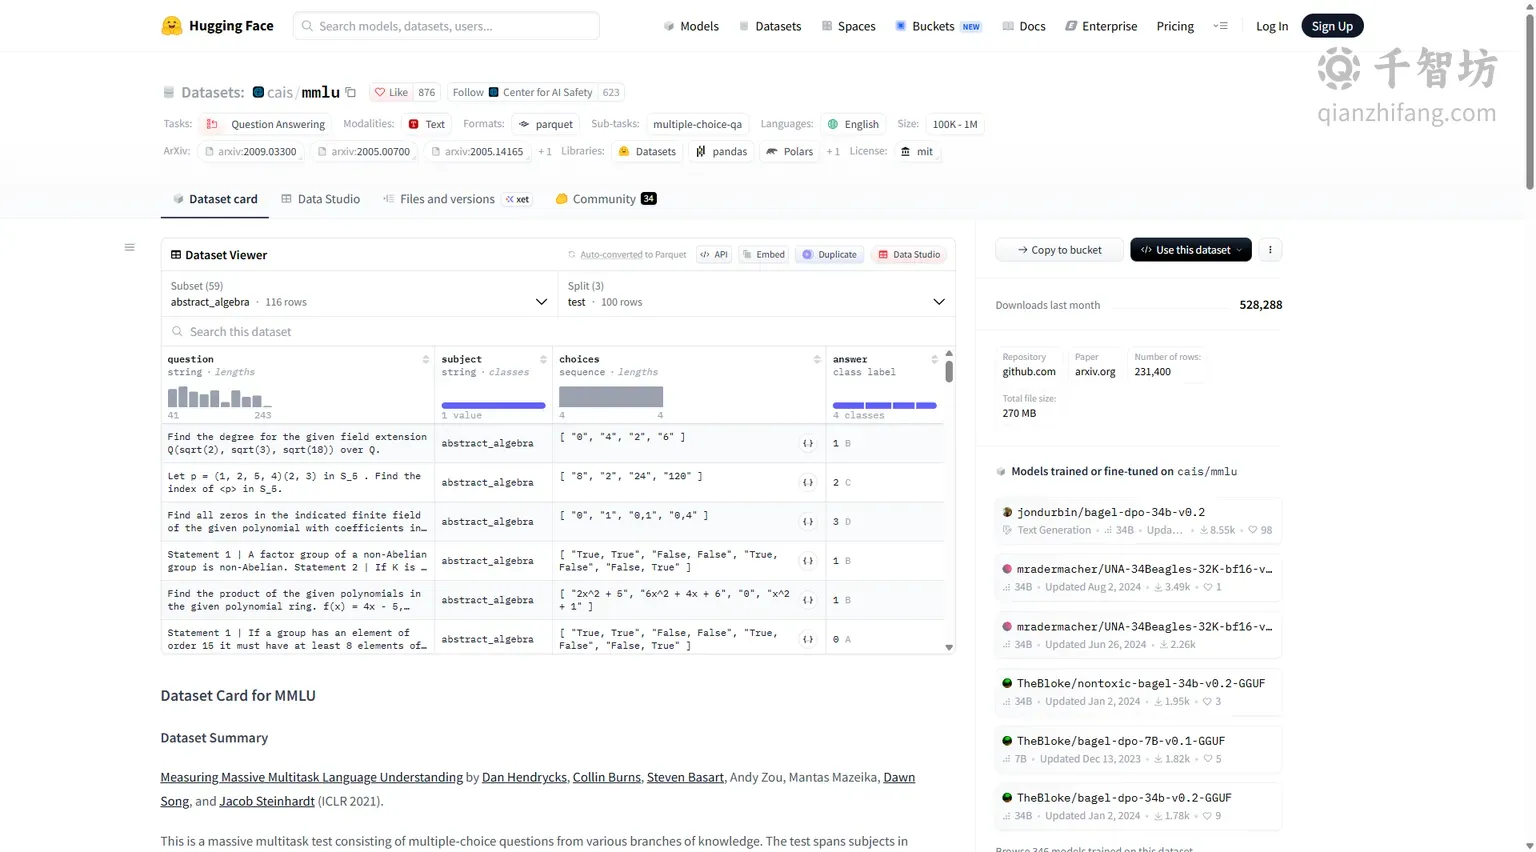
MMLU的数据集托管在Hugging Face平台(cais/mmlu),同时斯坦福大学的HELM(Holistic Evaluation of Language Models)评测框架也集成了MMLU,提供了标准化的评测流程和结果展示。研究者可以通过Papers with Code网站查看MMLU排行榜,了解各模型在该基准上的最新表现。
主要功能
MMLU作为评测基准,其功能主要体现在为AI研究社区提供标准化的模型能力评估手段。具体包括以下几个方面:
- 多学科知识评估:覆盖57个学科,包括STEM(物理、化学、数学、计算机科学)、人文(历史、哲学、法律)、社会科学(经济学、心理学、社会学)以及应用领域(医学、会计、市场营销)等,能够全面检验模型的知识广度。
- 标准化多选题测试:所有题目均为四选一形式,评测流程统一,便于不同模型之间进行公平比较。
- 难度分级:题目难度涵盖高中、大学和专业职业三个层次,可以区分模型在不同难度水平上的表现差异。
- 排行榜与结果追踪:通过Papers with Code和HELM等平台,实时追踪各模型在MMLU上的SOTA(State of the Art)表现。
- 数据集开放获取:数据集在Hugging Face上公开,研究者可以自由下载用于模型训练、微调或评测研究。
使用方法
研究者如何使用MMLU
- 获取数据集:访问Hugging Face的cais/mmlu数据集页面,下载完整数据集或通过datasets库加载。
- 准备评测环境:使用HELM等评测框架,或自行编写评测脚本,将模型接入MMLU测试流程。
- 运行评测:让模型对每道题进行作答,记录答案并与标准答案比对,计算准确率。
- 分析结果:按学科、难度等维度分析模型表现,识别模型的强项和弱项。
- 对比与报告:将结果与排行榜上的其他模型对比,撰写评测报告或论文。
普通用户如何理解MMLU
对于非研究者,MMLU得分可以作为选择AI模型的一个参考指标。通常得分越高的模型,在知识问答、考试解题、专业咨询等场景中的表现越可靠。用户可以在模型发布公告、技术报告或Papers with Code排行榜上查看MMLU得分。
产品优势
| 优势维度 | 具体说明 |
|---|---|
| 学科覆盖广 | 57个学科,远超一般评测集的覆盖范围,能全面反映模型的知识面。 |
| 社区认可度高 | 几乎所有主流大模型都将MMLU作为标准评测项,结果具有高度可比性。 |
| 难度分层合理 | 涵盖高中到专业水平,能区分不同能力层次的模型。 |
| 开放透明 | 数据集公开,评测方法透明,便于复现和验证。 |
| 持续更新 | 通过HELM等平台持续追踪最新模型表现,保持时效性。 |
应用场景
- 模型研发:研究团队在训练大模型时,用MMLU评估模型的知识掌握程度,指导训练策略调整。
- 模型选型:企业在选择AI模型时,参考MMLU得分判断模型是否满足业务对知识广度和准确性的要求。
- 学术研究:研究者利用MMLU分析模型的能力边界、偏见和局限性,推动AI可解释性和安全性研究。
- 教育培训:教育机构用MMLU题目作为测试集,评估AI辅导工具在学科知识上的可靠性。
- 公众科普:媒体和科普作者通过MMLU得分向公众解释AI模型的能力水平。
技术特点与局限
MMLU采用few-shot和zero-shot评测设置,模型在少量示例或零示例条件下作答,考验其泛化能力。然而,MMLU也存在局限:题目以英文为主,对非英语模型的评估可能存在偏差;部分题目可能存在数据泄露风险;且多选题形式无法完全反映模型在开放式生成任务中的表现。因此,研究者常将MMLU与其他基准(如BIG-bench、HELM等)结合使用,以获得更全面的评估。
核心功能
优缺点分析
适用人群
常见问题


