详细介绍
工具简介
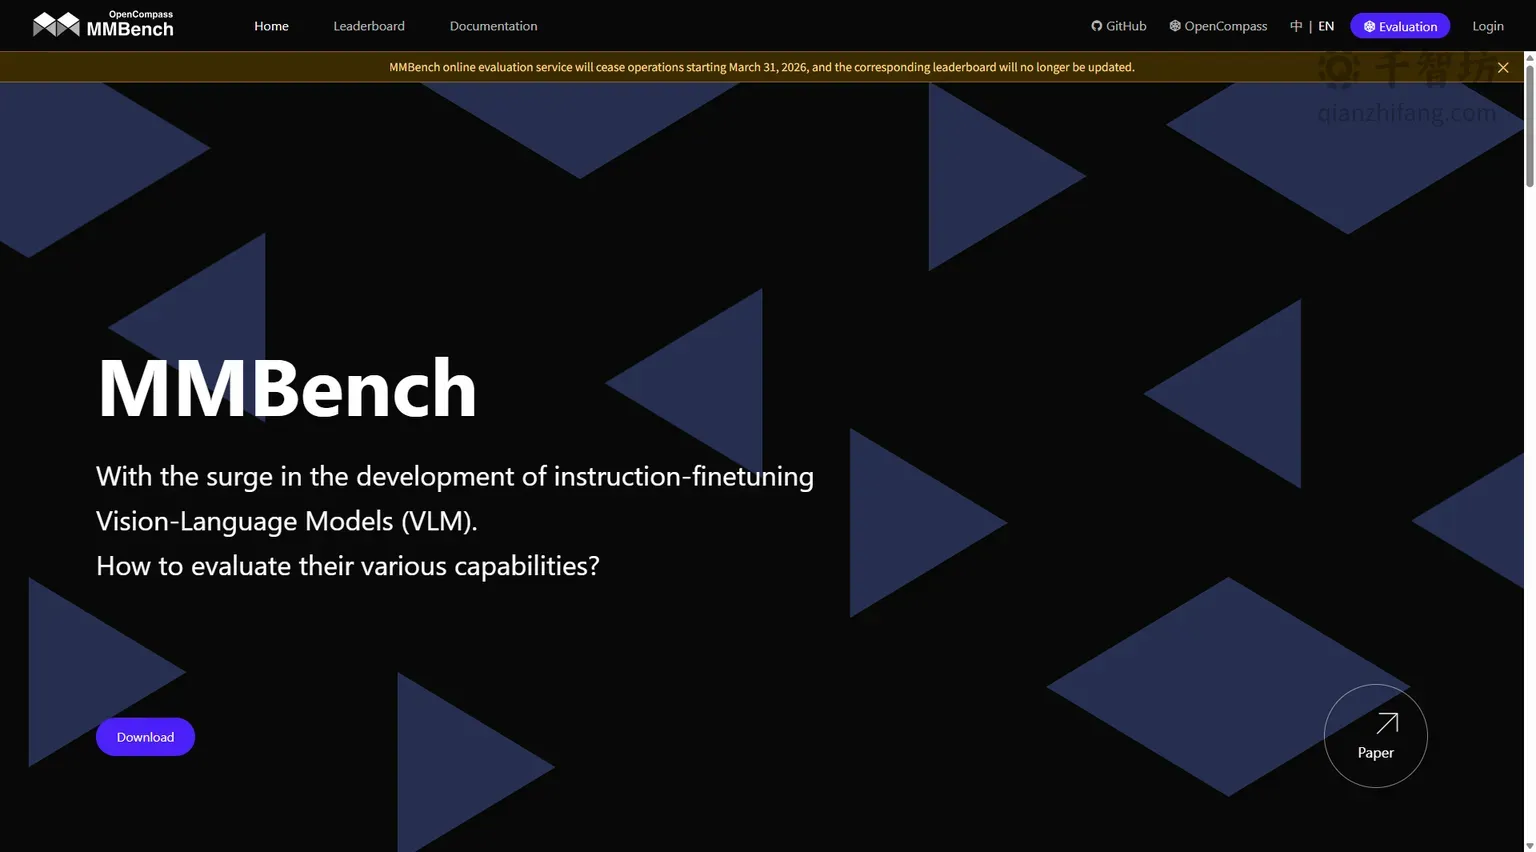
MMBench 是由 OpenCompass 团队推出的一款面向多模态大模型(Multimodal Large Language Models, MLLM)的综合性评测基准。在人工智能技术飞速发展的今天,多模态大模型已经能够同时处理文本、图像甚至视频等多种信息形式,但如何客观、全面地衡量这些模型的真实能力,一直是学术界和工业界共同关注的难题。MMBench 正是在这样的背景下应运而生,它通过构建一套系统化、多维度的评测体系,为研究人员和开发者提供了一个公平、可复现的模型能力对比平台。
与传统的单一任务评测不同,MMBench 的设计理念强调能力维度的细分与题目质量的把控。它不仅仅关注模型能否识别图片中的物体,更深入到逻辑推理、空间关系理解、属性判断、知识应用等多个层面,力求还原真实世界中多模态理解的复杂性。该基准的官网入口为 https://mmbench.opencompass.org.cn,用户可以通过 Web 端访问并查看最新的评测榜单、模型排名以及详细的评测报告。
MMBench 的核心价值在于其标准化的评测流程。它采用统一的提示词模板和答案匹配策略,尽可能减少因评测方式不同而带来的结果偏差。同时,MMBench 引入了 CircularEval 等创新评测策略,通过循环变换选项位置来检验模型回答的稳定性,从而有效识别模型是否存在“选项猜测”或“位置偏好”等问题。这种严谨的设计使得 MMBench 的评测结果具有较高的可信度和参考价值。
主要功能
1. 多维度能力评测体系
MMBench 将多模态理解能力拆解为多个细粒度维度,包括但不限于:物体识别、属性判断、空间关系理解、动作识别、场景理解、逻辑推理、常识知识等。每个维度下都配备了相应类型的题目,覆盖从基础感知到高级认知的完整链条。这种设计使得评测结果不仅是一个总分,更是一份详尽的“能力画像”,帮助开发者精准定位模型的强项与短板。
2. 丰富的题库与多样化的题目形式
MMBench 构建了规模庞大的题目库,题目形式以多项选择题为主,同时包含部分开放性问题。题目内容涵盖日常生活场景、科学知识、文化艺术、图表数据等多种领域,确保评测的广泛性和代表性。所有题目均经过人工审核与筛选,保证了较高的质量与准确性。此外,MMBench 还提供了不同难度等级的题目划分,便于分析模型在不同复杂度任务上的表现差异。
3. CircularEval 循环评测策略
为了克服传统多项选择题评测中模型可能存在的“位置偏见”问题,MMBench 提出了 CircularEval 评测策略。该策略会将同一道题目的选项顺序进行多次循环变换,要求模型在每次变换后都给出正确答案。只有当模型在所有变换下都能稳定回答正确时,才判定其真正掌握了该题。这一机制显著提升了评测的鲁棒性,能够更真实地反映模型的理解能力而非投机取巧。
4. 公开榜单与模型排名
MMBench 官网提供了实时的公开榜单,展示了众多主流多模态大模型的评测成绩。用户可以根据总分、各能力维度得分、模型参数量等条件进行筛选和排序,快速了解当前领域内各模型的相对位置。榜单的透明性和开放性促进了模型开发者之间的良性竞争,也为用户选择合适模型提供了数据支撑。
5. 详细的评测报告与分析工具
除了排名之外,MMBench 还为每个参评模型提供详细的评测报告,包括各维度得分雷达图、典型错误案例分析、与基线模型的对比等。这些分析工具帮助研究人员深入理解模型的行为模式,发现潜在的改进方向。对于企业用户而言,这些报告也是评估模型是否适合特定业务场景的重要参考。
6. 开放的评测接口与社区贡献机制
MMBench 支持开发者提交自己的模型进行评测,并提供了标准化的提交接口和文档说明。同时,社区成员也可以参与题目的贡献与审核,共同推动评测基准的迭代更新。这种开放协作的模式使得 MMBench 能够持续进化,紧跟多模态技术的最新进展。
使用方法
使用 MMBench 进行模型评测通常包含以下几个步骤:
- 访问官网:打开 https://mmbench.opencompass.org.cn,浏览榜单和文档。
- 准备模型:确保待评测的多模态模型能够接收图像和文本输入,并输出文本答案。
- 下载评测工具:根据官方文档指引,获取 MMBench 的评测脚本或 API 接口。
- 运行评测:在本地或云端环境中运行评测程序,模型将自动回答题库中的问题。
- 提交结果:将模型输出按照指定格式提交至官网,系统会自动计算得分并更新排名。
- 查看报告:在榜单页面查看模型的详细评测报告,分析各维度表现。
产品优势
| 优势维度 | 具体说明 |
|---|---|
| 评测维度全面 | 覆盖感知、推理、知识等多个层面,避免单一指标片面性。 |
| 评测策略严谨 | CircularEval 有效消除位置偏见,提升结果可信度。 |
| 榜单公开透明 | 所有评测结果公开可查,促进公平竞争。 |
| 社区生态活跃 | 开放贡献机制,持续更新题库和评测方法。 |
应用场景
- 学术研究:研究人员可利用 MMBench 对比不同多模态模型的性能,验证新算法的有效性。
- 模型选型:企业在构建多模态应用时,可参考 MMBench 榜单选择最适合业务需求的模型。
- 模型迭代:开发者可通过评测报告发现模型弱点,有针对性地优化训练数据和模型结构。
- 教学评估:教师和学生可将 MMBench 作为学习多模态AI的实践工具,直观理解模型能力边界。
综上所述,MMBench 作为 OpenCompass 生态中的重要组成部分,为多模态大模型的评测提供了科学、系统、开放的解决方案。无论您是AI研究者、工程师还是技术爱好者,MMBench 都值得深入了解和持续关注。
核心功能
优缺点分析
适用人群
常见问题


