
详细介绍
工具简介
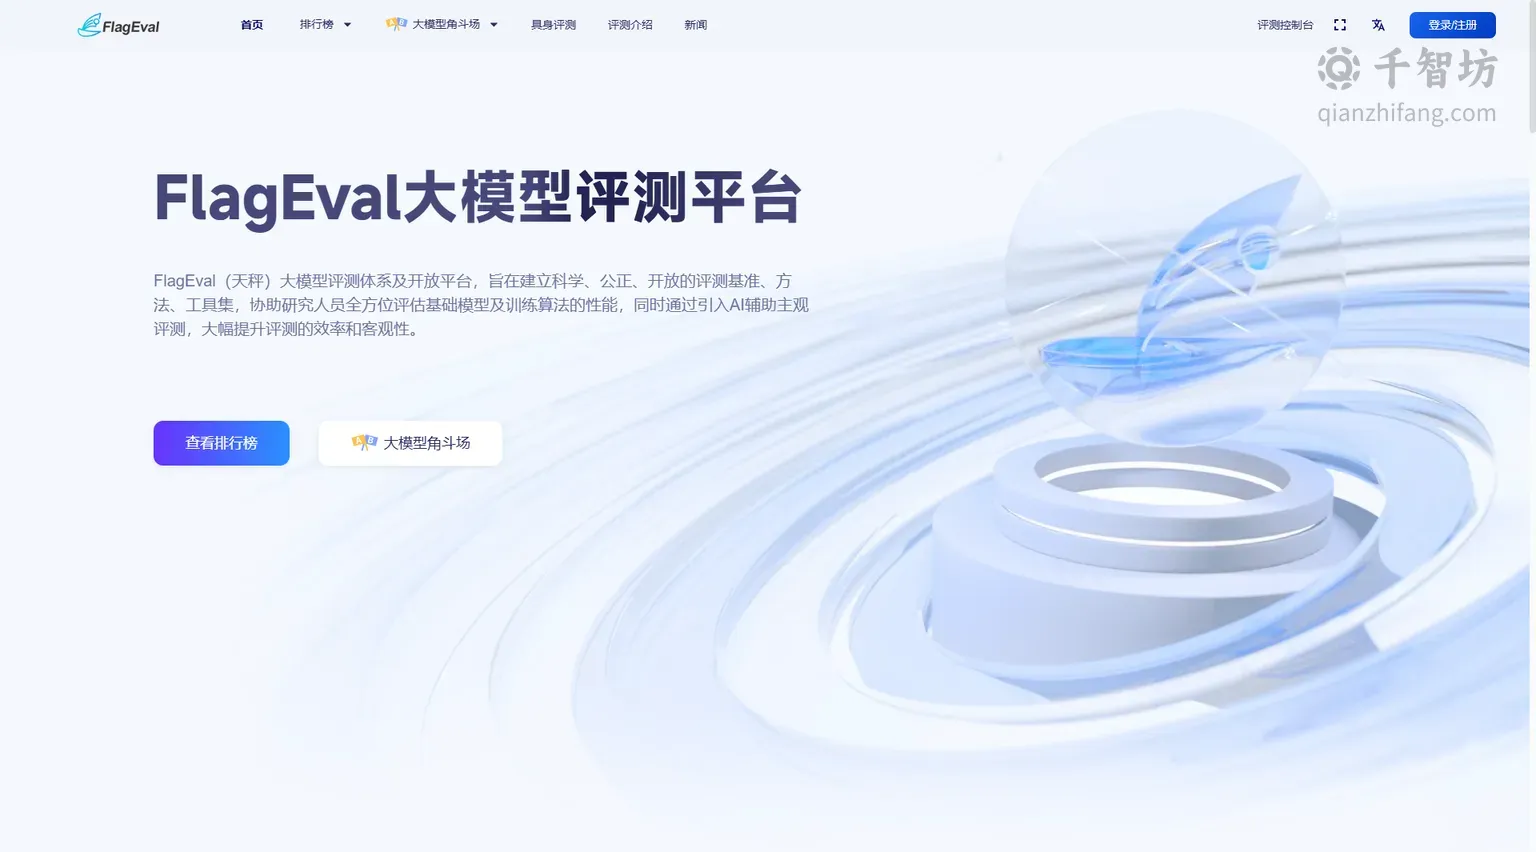
FlagEval(中文名称“悟道·天演”)是由北京智源人工智能研究院(BAAI)主导推出的一款专业AI大模型评测平台与开源评测工具。它立足于当前人工智能领域大模型百花齐放、迭代迅速的背景,致力于为学术界、产业界以及广大AI开发者提供一个科学、公正、全面、开放的模型能力评估体系。与市面上常见的AI应用工具不同,FlagEval并非直接面向终端用户提供内容生成或图像创作服务,而是扮演着“AI模型裁判员”和“能力标尺”的关键角色,通过系统化的评测基准、多样化的评测方法和可视化的榜单结果,帮助用户深入了解各类大模型在语言、视觉、语音等多模态任务中的真实表现。
在AI大模型竞争日益激烈的今天,模型能力的宣传往往参差不齐,缺乏统一、透明的衡量标准。FlagEval的出现正是为了解决这一痛点。它依托北京智源研究院在人工智能领域的深厚研究积累,构建了一套覆盖多模态、多任务、多维度的评测框架。该平台不仅关注模型在传统自然语言处理任务(如文本分类、情感分析、机器翻译、阅读理解、文本摘要等)上的表现,还深入评估模型在复杂推理、代码生成、数学解题、知识问答、安全伦理等高阶能力上的水平。同时,FlagEval也涵盖了图像识别、图文匹配、视觉问答等多模态任务,力求全方位刻画一个AI模型的综合能力画像。
主要功能
1. 多维度的模型评测榜单
FlagEval平台的核心功能之一是提供实时更新、分类清晰的模型评测榜单。平台汇集了国内外众多知名大模型,包括但不限于智源悟道系列、ChatGPT、GPT-4、Claude、文心一言、通义千问、星火认知大模型等。榜单按照不同的评测维度进行划分,例如:
- 语言模型评测榜:聚焦文本理解与生成能力,涵盖知识问答、逻辑推理、代码编程、数学计算、安全合规等子维度。
- 多模态模型评测榜:评估模型在图像描述、视觉问答、图文检索等跨模态任务上的表现。
- 语音模型评测榜:针对语音识别、语音合成等任务进行专项评估。
每个榜单都会展示模型的综合得分、各子项得分以及排名变化趋势,用户可以通过交互式图表直观地对比不同模型之间的优势与短板。这种透明化的排名机制,极大地促进了模型研发者之间的良性竞争和技术交流。
2. 丰富的评测数据集与基准
为了确保评测结果的科学性和权威性,FlagEval构建了庞大且多样化的评测数据集。这些数据集来源于公开学术基准、行业真实场景数据以及智源研究院自研的高质量测试集。平台不仅采用了如MMLU、C-Eval、GSM8K、HumanEval等国际通用基准,还针对中文语境和特定领域(如法律、医疗、金融)开发了定制化评测集。通过静态基准测试与动态对抗测试相结合的方式,FlagEval能够有效避免模型“刷榜”或过拟合的问题,更真实地反映模型在实际应用中的泛化能力。
3. 自动化评测工具与开源框架
FlagEval不仅仅是一个在线榜单,它还提供了一套开源的自动化评测工具链。开发者和研究机构可以下载FlagEval的开源评测框架,在本地或私有云环境中对自有模型进行快速、标准化的评估。该工具链支持主流的深度学习框架和模型接口,具备高度可扩展性,允许用户自定义评测任务、添加私有数据集,并生成详细的评测报告。这大大降低了模型评测的技术门槛,使得中小型团队也能享受到专业级的评测服务。
4. 主观评测与人类反馈机制
除了客观的自动化指标,FlagEval还引入了主观评测模块。平台通过组织人类评估者对模型生成的文本、图像等内容进行质量打分,收集关于流畅度、相关性、有用性、无害性等方面的主观反馈。这种“人机结合”的评测方式,弥补了纯自动化指标在评估创造性、逻辑连贯性和价值观对齐方面的不足,使得评测结果更加贴近人类的真实感知。
5. 模型能力分析与诊断报告
针对每一个被评测的模型,FlagEval会生成详细的能力诊断报告。报告不仅包含总分和排名,还会通过雷达图、柱状图等形式展示模型在各项能力上的强弱分布。例如,某个模型可能在文本生成上表现优异,但在数学推理上存在明显短板。这些细粒度的分析数据,为模型开发者指明了优化方向,也为企业选型提供了有力的数据支撑。
使用方法
使用FlagEval平台非常简单,用户无需安装任何客户端,直接通过浏览器访问官网即可。具体操作步骤如下:
- 访问官网:在浏览器中输入FlagEval官方网址,进入平台首页。
- 浏览榜单:在导航栏中选择感兴趣的评测榜单(如语言模型榜、多模态榜),查看各模型的实时排名和得分。
- 筛选与对比:利用平台提供的筛选工具,按照模型类型、参数规模、发布时间等条件过滤结果,并可将多个模型加入对比列表,生成直观的对比图表。
- 查看详情:点击任意模型名称,进入详情页查看该模型的各项能力得分、评测样本示例以及历史排名变化。
- 下载工具:对于有本地评测需求的用户,可以在平台的“开源工具”或“下载”页面获取FlagEval评测框架的源代码和文档。
- 提交模型:模型研发团队可以通过平台提供的提交通道,申请将自研模型纳入FlagEval的评测范围,经过审核后即可参与榜单排名。
产品优势
| 优势维度 | 具体说明 |
|---|---|
| 权威性 | 由北京智源研究院这一国家级AI研究机构主导,评测标准和流程严谨,结果具有很高的公信力。 |
| 全面性 | 覆盖语言、视觉、语音等多模态,兼顾客观指标与主观评价,评测维度丰富。 |
| 开放性 | 评测工具开源,榜单透明,鼓励社区贡献数据集和评测方法,推动行业标准统一。 |
| 动态性 | 评测数据集和榜单持续更新,紧跟大模型技术发展趋势,及时反映最新模型的能力变化。 |
应用场景
- 学术研究:研究人员可利用FlagEval的基准和工具,验证新模型算法的有效性,并与SOTA模型进行公平对比。
- 企业选型:企业在引入AI大模型时,可参考FlagEval的评测报告,根据自身业务需求选择性价比最高、能力最匹配的模型。
- 模型开发:模型开发者通过诊断报告发现短板,有针对性地进行数据增强、架构调整或训练策略优化。
- 行业标准制定:FlagEval的评测实践为AI大模型行业的标准化、规范化发展提供了重要参考。
总而言之,FlagEval是一个集评测、分析、开源工具于一体的综合性AI大模型评测平台。它不直接生产内容,而是通过建立科学的“度量衡”,推动整个AI生态朝着更加透明、健康、高效的方向演进。对于任何关注大模型能力、致力于AI技术研发与应用的人来说,FlagEval都是一个不可或缺的重要资源。
核心功能
优缺点分析
适用人群
常见问题


