详细介绍
工具简介
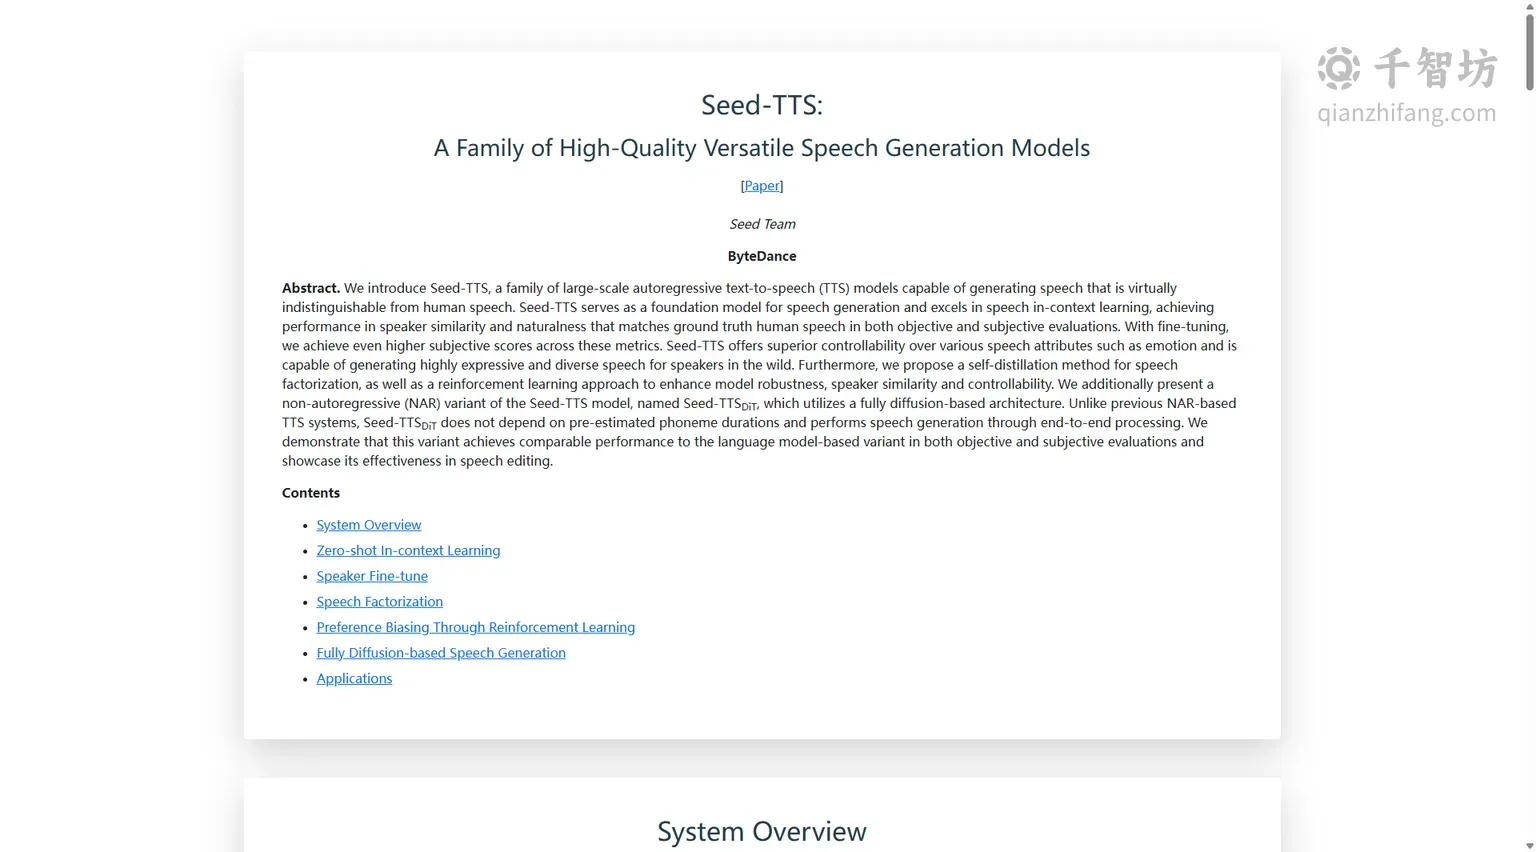
Seed-TTS 是由 字节跳动 Seed 团队研发并推出的一款大规模自回归文本转语音(Text-to-Speech,简称 TTS)模型家族。该模型的技术报告发布在 arXiv 平台(论文编号 2406.02430),并在字节跳动语音技术官方页面上提供了详尽的技术说明与音频样例展示。Seed-TTS 的核心目标是生成与真人语音几乎无法区分的合成语音,它被定位为一个通用的语音生成基础模型(Foundation Model),在语音上下文学习(In-context Learning)方面表现尤为突出。
根据官方技术报告的描述,Seed-TTS 在说话人相似度(Speaker Similarity)和自然度(Naturalness)这两项关键指标上,无论客观评测还是主观评测,都已经达到了与真实人类语音相当的水平。而经过针对特定说话人的微调(Fine-tuning)之后,其主观评分还能进一步提升。这意味着 Seed-TTS 不仅能模仿音色,还能在情感、语调、节奏等维度上实现高度可控的语音合成。
Seed-TTS 并非单一的模型,而是一个模型家族,包含基于语言模型的自回归版本以及名为 Seed-TTSDiT 的非自回归(NAR)全扩散架构版本。后者不依赖预先估算的音素时长,采用端到端处理方式完成语音生成,并且在语音编辑等任务上展现出独特优势。这种双架构并行的设计思路,使得 Seed-TTS 在灵活性、可控性和生成质量之间取得了良好的平衡。
技术架构与工作原理
Seed-TTS 的推理流程可以拆解为四个关键环节,每个环节都采用了专门设计的神经网络组件:
- 语音分词器(Speech Tokenizer):从参考语音中学习离散的语音 token,将连续的音频信号转换为模型可以处理的符号序列。这一步是模型理解音色、语调等声学特征的基础。
- 自回归语言模型:根据条件文本和参考语音 token,逐步生成目标语音的 token 序列。这一环节借鉴了大语言模型的思路,把语音生成建模为序列预测问题。
- 扩散 Transformer 模型:将语言模型生成的离散 token 转换为连续的语音表示,采用从粗到细(coarse-to-fine)的生成方式,逐步细化声学细节。
- 声学声码器(Vocoder):从扩散模型的输出中合成最终的高质量波形音频,完成从文本到可听语音的完整转换。
除了上述基础流程,Seed-TTS 还引入了两项重要的技术创新。其一是自蒸馏方法(Self-distillation),用于语音因子分解(Speech Factorization),能够将语音中的内容、音色、情感等要素进行解耦,从而实现更精细的控制。其二是强化学习(Reinforcement Learning)方法,用于提升模型的鲁棒性、说话人相似度和可控性,让模型在面对多样化输入时表现更加稳定。
主要功能
零样本上下文学习(Zero-shot In-context Learning)
用户只需提供一段简短的参考语音,Seed-TTS 就能在没有额外训练的情况下,模仿该说话人的音色生成新的语音内容。官方展示的样例中,模型不仅能完成同语种生成,还能实现跨语种生成——例如用中文参考语音去合成英文语音,依然保持较高的音色相似度。这一能力对于多语言内容创作、配音本地化等场景极具价值。
说话人微调(Speaker Fine-tune)
如果用户希望获得更高的一致性和表现力,可以对特定说话人进行微调。官方报告指出,微调后的模型在主观评分上能够超越零样本模式,生成更贴合目标说话人特征的语音,适用于虚拟主播、有声书录制、品牌专属语音等长期稳定的应用场景。
语音因子分解(Speech Factorization)
借助自蒸馏方法,Seed-TTS 可以将语音中的说话人音色、语言内容、情感风格等要素分离开来。这意味着用户可以组合不同的因子,例如用 A 的音色、B 的情感风格来朗读 C 的文本,为语音创作提供了极大的自由度。
强化学习偏好偏置(Preference Biasing Through RL)
通过强化学习,模型可以根据人类偏好进行优化,在鲁棒性、相似度和可控性方面持续提升。这使得 Seed-TTS 在面对噪声输入、口音差异、复杂文本时依然能保持稳定的输出质量。
全扩散语音生成(Seed-TTSDiT)
Seed-TTSDiT 是 Seed-TTS 家族中的非自回归变体,采用完全基于扩散的架构。与以往的非自回归 TTS 系统不同,它不需要预先估计音素时长,而是通过端到端方式直接生成语音。官方表示,该变体在客观和主观评测中都能达到与语言模型版本相当的性能,并且在语音编辑任务中表现出色。
情感与风格控制
Seed-TTS 对情感、语调等语音属性具备优越的可控性,能够为不同说话人生成高度富有表现力和多样化的语音。无论是欢快、悲伤、严肃还是轻松的语调,都可以通过条件控制来实现。
多样化应用支持
官方技术报告专门设置了应用样例章节,展示了 Seed-TTS 在语音编辑、跨语种合成、个性化语音生成等实际场景中的表现,验证了其作为通用语音生成基础模型的广泛适用性。
使用方法与适用场景
目前 Seed-TTS 主要以技术研究和模型展示的形式呈现,用户可以通过官方技术报告页面查看系统概览、零样本学习样例、说话人微调样例、语音因子分解样例、强化学习样例、全扩散生成样例以及应用样例。对于希望深入了解或复现该技术的开发者和研究人员,可以参考其 arXiv 论文获取完整的模型细节和实验数据。
在实际应用层面,Seed-TTS 的潜在场景包括:有声内容制作(有声书、播客、新闻播报)、虚拟数字人配音、游戏与动画角色语音、跨语种视频本地化、个性化语音助手以及语音编辑与修复等。其零样本克隆能力尤其适合需要快速生成特定音色语音的创作者,而微调能力则适合对音质和一致性有长期要求的商业项目。
产品优势与局限
Seed-TTS 的最大优势在于其生成质量已经逼近真人水平,在说话人相似度和自然度上达到了业界领先水准。其次,模型家族提供了自回归和全扩散两种架构选择,兼顾了生成质量与编辑灵活性。第三,零样本学习能力大幅降低了语音克隆的使用门槛,无需大量训练数据即可获得不错的效果。第四,情感控制和语音因子分解为创意表达提供了丰富的操作空间。
不过,作为一项前沿研究项目,Seed-TTS 目前尚未公开明确的商业化定价和面向普通用户的产品入口,普通用户较难直接上手体验。此外,高质量的语音克隆技术也伴随着伦理与安全方面的考量,如何防止滥用是行业共同面临的挑战。
核心功能
优缺点分析
适用人群
常见问题


