详细介绍
工具简介
AnyVoice 是一款功能全面的一站式 AI 语音工作室,致力于让声音克隆与语音生成变得前所未有的简单和高效。其核心能力在于仅需 15 秒的清晰音频样本,即可构建出一个高度逼真的数字声音副本,精准还原说话者的音色、口音、节奏乃至个性特征。这一技术突破大幅降低了声音克隆的门槛,让个人创作者、企业团队都能轻松拥有专属的 AI 声音资产。
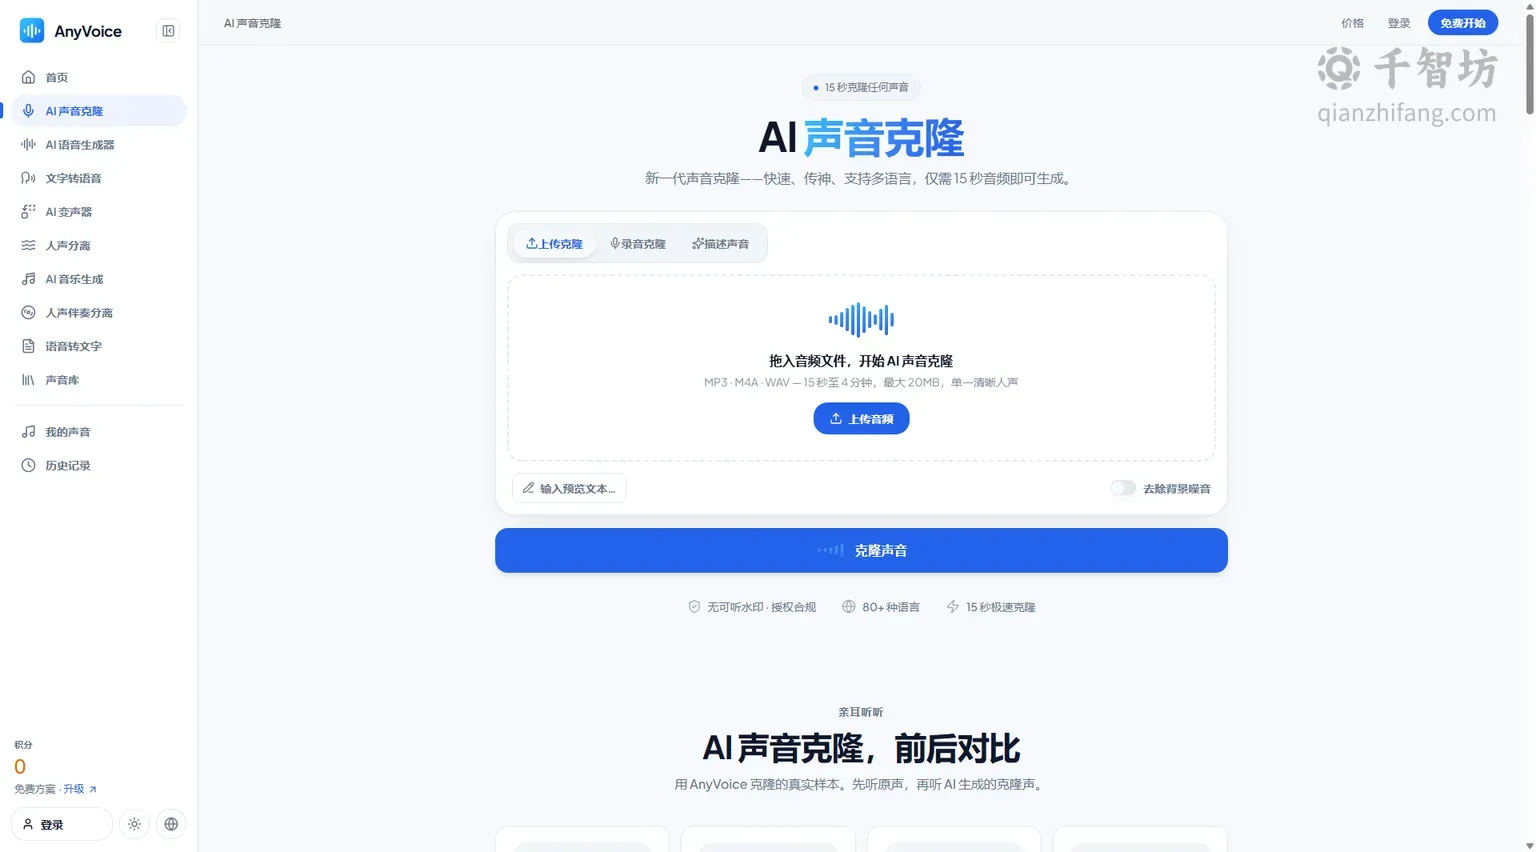
与传统的文字转语音(TTS)工具不同,AnyVoice 并非从预设的机械音库中选择声音,而是基于用户提供的真实声音样本进行深度学习建模,生成的声音具有极强的辨识度和自然感。用户只需上传或现场录制一段 15 秒至 4 分钟的单一清晰人声(支持 MP3、M4A、WAV 格式,最大 20MB),系统便能在几秒内完成声音克隆,随后输入任意文本即可生成对应语音。更令人瞩目的是,克隆出的同一个声音可以流畅表达80 多种语言和口音,真正实现“一个声音,畅说世界”。
AnyVoice 的产品矩阵远不止于声音克隆。围绕语音创作的全流程,平台还提供了 AI 语音生成器、文字转语音、AI 变声器、人声分离、AI 音乐生成、人声伴奏分离、语音转文字等一系列配套工具,构成了从声音采集、克隆、编辑到输出的完整闭环。无论是制作有声书、视频配音、播客本地化,还是构建语音客服、游戏角色台词,AnyVoice 都能提供高效可靠的解决方案。
主要功能
AI 声音克隆
这是 AnyVoice 的核心功能。用户通过上传音频文件或直接在浏览器中录制样本,提供至少 15 秒的清晰单人语音,系统便会自动学习样本的音色、口音与个性,在数秒内构建出专属的声音模型。克隆过程支持去除背景噪音,确保样本质量。生成的声音无可听水印,且默认遵循授权合规原则,保障声音使用的合法性与安全性。
AI 语音生成器
克隆声音后,用户只需选择声音、粘贴文稿,即可在几秒内生成自然流畅的语音。同一个声音可复用于视频、播客、本地化内容等多种场景,无需逐句重新录制。该功能支持在线播放和即时下载,极大提升了内容产出的效率。
多语言语音合成
AnyVoice 支持 80 多种语言和口音的自然语音生成,涵盖英语、西班牙语、法语、德语、意大利语、葡萄牙语、荷兰语、波兰语、俄语、乌克兰语、土耳其语等主流语言。一个克隆声音即可为不同地区的受众本地化播客、视频或课程,无需重新录制,帮助创作者轻松触达全球市场。
AI 变声器
除了克隆自己的声音,AnyVoice 还提供 AI 变声功能,用户可以将音频转换为不同的声音风格,适用于娱乐创作、角色配音、隐私保护等场景。变声过程同样追求自然传神,避免机械感。
人声分离与人声伴奏分离
平台内置人声分离工具,可将音频中的人声与背景音乐、环境音效分离,便于后期编辑或重新混音。人声伴奏分离功能则专门针对音乐制作场景,帮助用户提取纯净人声或伴奏轨道,为翻唱、混音、卡拉OK 制作等提供便利。
AI 音乐生成
AnyVoice 还拓展至音乐创作领域,提供 AI 音乐生成功能,用户可以通过简单操作生成原创音乐片段,为视频配乐、播客片头、广告背景等场景快速提供素材。
语音转文字
平台支持语音转文字功能,可将音频内容快速转换为文本,适用于会议记录、采访整理、字幕制作等场景,进一步完善了语音内容的处理链条。
使用方法
AnyVoice 的使用流程设计得极为简洁,主要分为三步:
- 上传或录制样本:提供至少 15 秒清晰的单人音频,可直接在浏览器中录制,或上传 MP3、M4A、WAV 格式文件(15 秒至 4 分钟,最大 20MB)。建议选择安静环境下的单一清晰人声,并可使用“去除背景噪音”选项优化样本质量。
- 克隆声音:点击克隆按钮后,AnyVoice 会自动学习样本的音色、口音与个性,在几秒内构建出专属声音模型。用户可以在“我的声音”中管理已克隆的声音资产。
- 生成语音:输入任意文本,选择目标语言,即可生成 80+ 种语言的自然语音,支持在线播放或即刻下载。生成记录可在“历史记录”中查看和管理。
此外,用户还可以通过“描述声音”的方式创建声音,或从声音库中挑选现成的声音模型直接使用。平台提供免费方案,用户注册登录后即可开始体验,并可根据需求升级套餐。
产品优势
| 对比维度 | AnyVoice | 传统 TTS 工具 |
|---|---|---|
| 声音来源 | 基于 15 秒样本克隆真实声音,高度还原音色与个性 | 预设音库,声音机械、缺乏辨识度 |
| 语言支持 | 一个克隆声音可表达 80+ 种语言和口音 | 通常每种语言需单独选择发音人 |
| 克隆速度 | 15 秒极速克隆,几秒内完成建模 | 不支持个性化克隆或流程复杂 |
| 水印与合规 | 无可听水印,默认授权优先,合规保障 | 部分工具添加水印或授权不明 |
| 功能完整性 | 克隆、TTS、变声、分离、音乐生成、语音转文字一站式 | 功能单一,需多工具配合 |
AnyVoice 的另一大优势在于其默认授权优先的设计理念。平台强调声音使用的合规性,帮助用户在创作过程中规避声音滥用的法律风险。同时,克隆出的声音可以“同一个声音,处处复用”,一次克隆即可贯穿有声书、视频配音、本地化、语音客服、营销推广、游戏应用等多种场景,显著降低重复录音的时间与成本。
应用场景
- 有声书制作:用自己的声音朗读整本书,从第一章到最后一章保持音色一致,无需反复进录音棚。
- 视频配音:批量为 YouTube 和短视频配音,改稿后几分钟即可重新生成,大幅提升内容迭代效率。
- 内容本地化:克隆一次即可说 80+ 种语言,无需重录便能触达全球受众,适合播客、课程、营销素材的出海。
- 语音客服:为智能助手和电话线路打造亲切、贴合话术、全天在线的品牌声音。
- 营销推广:几分钟而非几天就能产出广告口播、促销和讲解音频,快速测试多个版本,优化投放效果。
- 游戏与应用:按需生成角色台词和应用内旁白,自由迭代,无需预约配音演员。
综上所述,AnyVoice 凭借极速克隆、多语言支持、功能全面和合规优先的特点,正在成为内容创作者、企业和开发者不可或缺的 AI 语音创作平台。
核心功能
优缺点分析
适用人群
常见问题


