
详细介绍
工具简介
免费在线OCR是一款基于浏览器的在线文字识别(OCR)与文档转换工具,用户无需安装任何客户端软件,只需打开网页即可上传文件、选择识别语言与输出格式,快速将扫描件、图片或PDF中的文字内容提取为可编辑的电子文档。该工具由独立站点运营,界面提供简体中文、繁体中文、英语、日语、韩语、法语、德语、俄语、西班牙语等数十种界面语言切换,方便不同地区的用户使用。
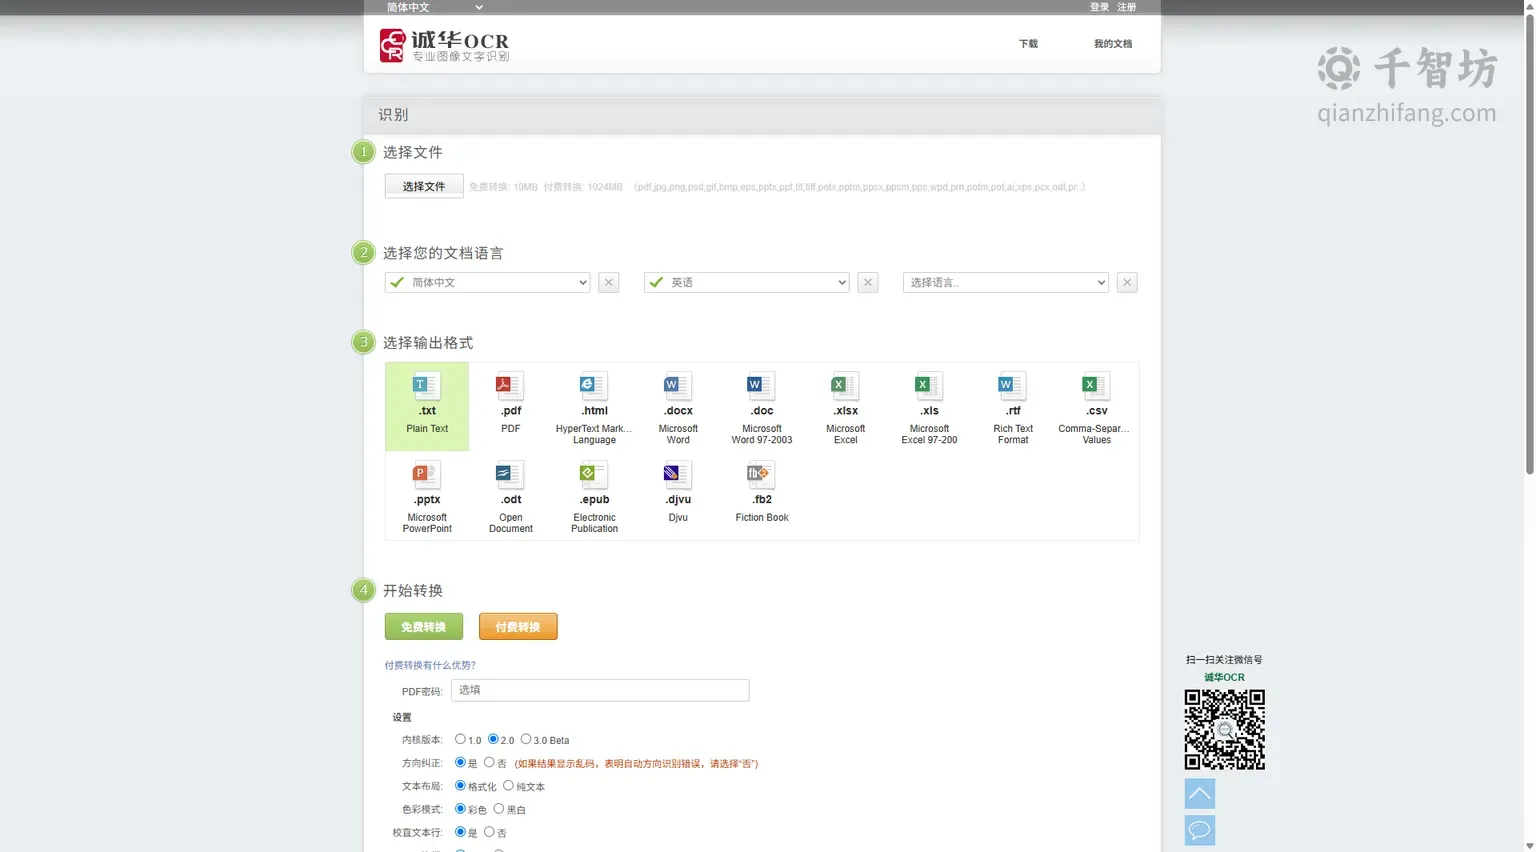
从产品定位来看,免费在线OCR主打“免费+多格式+多语言”的组合能力。它并不局限于单一的图片转文字场景,而是把OCR识别与文档格式转换结合在一起,形成一条从“上传原始文件”到“下载目标格式”的完整处理链路。用户上传文件后,可以在同一页面内完成文档语言选择、输出格式选择、识别内核版本切换、方向纠正、文本布局、色彩模式、文本行校直、换行保留等多项参数设置,再点击开始转换,等待系统返回识别结果。
主要功能
多格式文件上传与识别
免费在线OCR支持的上传格式相当丰富,涵盖常见的办公文档与图像格式,包括PDF、JPG、PNG、PSD、GIF、BMP、EPS、PPTX、PPT、TIF、TIFF、POTX、PPTM、PPSX、PPSM、PPS、WPD、PRN、POTM、POT、AI、XPS、PCX、ODT、PR等数十种扩展名。这意味着用户不必事先用其他软件把文件转成图片,直接上传原始文档即可进入识别流程,减少了中间环节和格式转换带来的画质损失。
免费与付费转换额度
工具采用免费与付费并行的额度机制:免费转换单文件上限为10MB,而付费转换单文件上限可达1024MB。对于日常的合同扫描件、发票照片、课件截图、几页到几十页的PDF文档,10MB的免费额度通常已经够用;当用户需要处理超大体积的PDF或高分辨率图片时,才需要考虑付费通道。这种设计让轻度用户零成本使用,重度用户按需升级。
多语言识别支持
在识别语言方面,免费在线OCR提供了非常细致的选项。用户最多可以依次选择三种文档语言,候选列表包括简体中文、繁体中文、英语、法语、德语、日语、韩语、俄语、瑞典语、波兰语、葡萄牙语、西班牙语、芬兰语、斯洛伐克语、阿拉伯语、泰语、越南语、挪威语、荷兰语、马来语、印尼语、意大利语、捷克语、丹麦语、希腊语、加泰罗尼亚语等自然语言,同时还支持数字、简单的数学式、简单的化学式等特殊内容类型,以及C/C++、Basic、Java、Pascal、Fortran、COBOL等编程语言代码的识别。对于需要处理多语种混排文档或代码截图的用户来说,这一能力相当实用。
多样化输出格式
识别完成后,用户可以选择将结果导出为多种格式,包括.txt纯文本、.pdf、.html网页、.docx与.doc(Microsoft Word)、.xlsx与.xls(Microsoft Excel)、.rtf富文本、.csv逗号分隔值、.pptx(Microsoft PowerPoint)、.odt开放文档、.epub电子出版物、.djvu、.fb2等。输出格式覆盖了办公文档、电子书、网页和结构化数据等主要场景,用户可以把OCR结果直接用于后续编辑、排版或数据分析,而不必再做二次格式转换。
识别参数精细调节
为了提升识别准确率,工具在“设置”区域提供了多项可调参数:内核版本可在1.0、2.0、3.0 Beta之间切换,用户可针对不同文档类型尝试不同引擎;方向纠正可开启或关闭,官方提示如果结果出现乱码,说明自动方向识别有误,此时应选择“否”;文本布局支持“格式化”与“纯文本”两种模式;色彩模式可选彩色或黑白;校直文本行可对倾斜扫描的文本行进行校正;换行可选择保留或取消。此外还提供PDF密码输入框,方便处理加密PDF文件。
批量处理与文档管理
页面支持一次选择多个文件进行批量识别,结果以表格形式列出文件名、结果、页数、扣费和操作等字段,用户可以在“我的文档”中查看历史记录,并通过“批量下载”将多个结果打包为ZIP压缩包下载。对于需要定期处理大量扫描件的用户,这一流程可以显著减少重复操作。
使用方法
- 打开官网,在首页点击“选择文件”上传需要识别的文档或图片,注意免费通道单文件不超过10MB。
- 在“选择您的文档语言”区域依次设置最多三种识别语言,若文档含代码或数学公式,可选择对应的特殊类型。
- 在“选择输出格式”区域点选目标格式,如TXT、DOCX、XLSX、PDF等。
- 展开“设置”面板,根据文档情况调整内核版本、方向纠正、文本布局、色彩模式、校直文本行和换行等参数;加密PDF需填写密码。
- 点击“开始转换”,等待系统处理,完成后在结果表格中查看页数与扣费信息。
- 在“我的文档”中预览或批量下载识别结果。
产品优势
与同类在线OCR工具相比,免费在线OCR的优势主要体现在三个方面:一是格式覆盖面广,上传端支持数十种文档与图像格式,输出端支持十余种目标格式,减少了用户在不同工具之间来回切换的成本;二是语言与内容类型丰富,不仅覆盖主流自然语言,还支持数学式、化学式和多种编程语言代码的识别;三是参数可调性强,方向纠正、文本布局、校直文本行等选项让用户能够针对扫描质量较差的文档进行针对性优化,而不是只能被动接受默认结果。
应用场景
- 办公文档数字化:将纸质合同、发票、报表的扫描件转为可编辑的Word或Excel文件。
- 学习资料整理:把课件截图、教材照片识别为TXT或DOCX,方便检索和笔记整理。
- 多语种资料处理:识别日文、韩文、俄文、阿拉伯文等外文文档,辅助翻译与资料归档。
- 代码与公式提取:从技术文档截图中提取C/C++、Java等代码或简单数学式、化学式。
- 电子书制作:将扫描版PDF转为EPUB、FB2、DJVU等电子书格式。
核心功能
优缺点分析
适用人群
常见问题


