详细介绍
工具简介
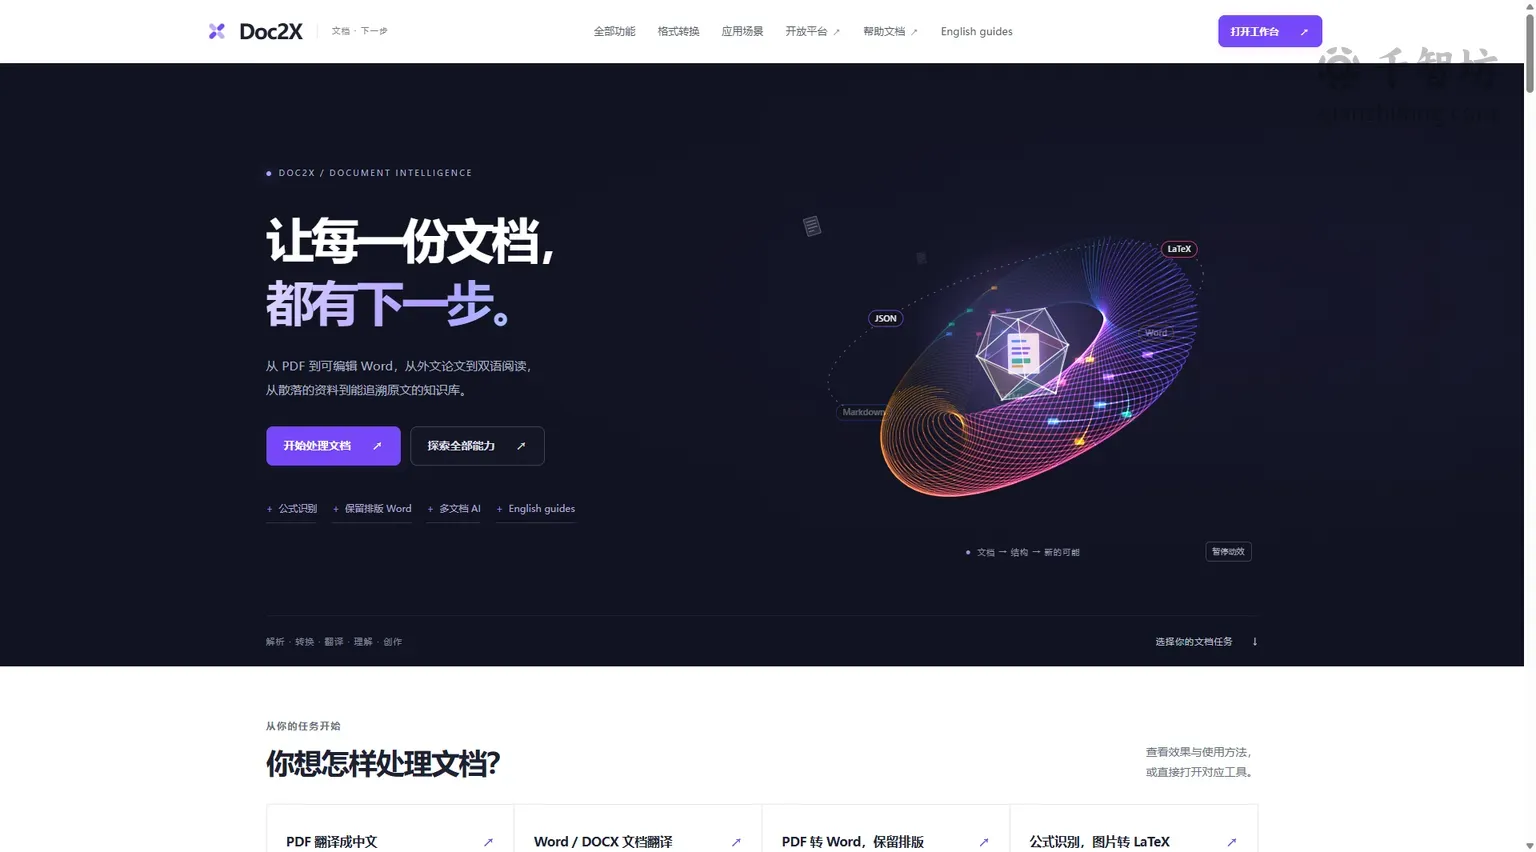
Doc2X(Doc to X)是由武汉智识无垠科技有限公司于2024年4月推出的一款AI驱动的文档智能处理工具,官网域名为noedgeai.com。顾名思义,Doc2X的核心理念是「让每一份文档都有下一步」——它致力于将静态的、难以编辑的文档(尤其是PDF和图片)转化为结构化、可编辑、可翻译、可检索的多种格式,从而打通文档从「阅读」到「再利用」的完整链路。无论是学术论文、扫描合同、技术手册还是外文资料,Doc2X都能借助OCR识别、版面分析与大语言模型能力,帮助用户快速完成解析、转换、翻译与理解。
与传统OCR工具仅做「文字提取」不同,Doc2X强调保留原始排版结构。它能够识别文档中的分栏、表格、公式、图片、页眉页脚等复杂元素,并在输出Word、Markdown、LaTeX等格式时尽可能还原版式,这对于学术写作、技术文档整理和知识库建设具有重要价值。同时,Doc2X还提供双语对照翻译、多文档AI知识库、扫描件矫正增强等进阶能力,形成了一个覆盖「解析—转换—翻译—理解—创作」全流程的文档处理生态。
主要功能
格式转换与解析
Doc2X最核心的能力是文档格式转换。用户可以将PDF上传后转换为可编辑的Word(DOCX)文档,系统会智能识别扫描件、分栏排版与数学公式,并尽量保留原有版式,减少二次排版的工作量。此外,Doc2X还支持PDF转Markdown,保留内容层级结构,非常适合导入笔记软件或构建知识库;以及论文PDF转LaTeX,提取正文与公式,可直接衔接Overleaf等LaTeX写作工程,为科研人员节省大量公式录入时间。
公式与表格识别
针对学术与技术场景,Doc2X提供专业的公式识别功能,用户只需截图或粘贴公式图片,即可转换为LaTeX代码,核对后复制到编辑器中即可使用。同时,图片表格转Excel功能可以识别合并表头、行列结构与单位信息,核对后导出XLSX文件,大幅提升数据整理效率。
文档翻译
Doc2X支持PDF全文翻译与Word(DOCX)文档翻译,提供双语对照与保留原版排版的选项。用户可以先核对Office预览,再翻译正文与图表,确保专业术语与格式的准确性。这一功能特别适合阅读外文论文、技术标准与商业资料。
扫描件矫正与增强
对于歪斜、有阴影或书页弯曲的扫描件,Doc2X提供扫描增强功能,先对图像进行矫正与增强处理,再继续解析或翻译,从而显著提升后续OCR识别的准确率。
多文档AI知识库
Doc2X支持将散落的资料整合为可追溯原文的知识库,结合AI能力实现多文档问答与信息检索,帮助用户从海量文档中快速定位关键内容。
在线实用工具
除核心文档处理外,Doc2X还提供一系列在线小工具,包括PPTX图片压缩、JSON格式化与校验、PDF拆分、PDF合并、PDF压缩等,满足日常文件整理需求。
使用方法
Doc2X的使用流程非常直观,主要分为以下几步:
- 选择任务:打开官网或在线工作台,根据需求选择「PDF翻译成中文」「PDF转Word」「公式识别」「图片表格转Excel」「PDF转Markdown」等任务入口。
- 上传文件:选择本地文件或直接粘贴图片/公式截图,系统自动开始解析。
- 核对结果:在在线编辑器中检查识别出的文字、公式、表格与排版,必要时手动修正。
- 导出或继续处理:确认无误后下载Word、Markdown、LaTeX、XLSX等格式,或直接进入翻译、知识库等下一步流程。
此外,Doc2X还提供桌面客户端与浏览器插件,用户可在下载中心获取,连接桌面文档、网页阅读与批量处理流程,进一步提升工作效率。开发者则可以通过开放平台调用文档解析、翻译与图像处理API,将能力集成到自有系统中。
产品优势
| 对比维度 | Doc2X | 传统OCR工具 |
|---|---|---|
| 排版保留 | 支持分栏、表格、公式、图片的版式还原 | 通常仅提取纯文本,版式丢失 |
| 公式处理 | 图片转LaTeX,PDF转LaTeX衔接Overleaf | 多数不支持公式结构化输出 |
| 翻译能力 | 双语对照、保留原版排版 | 需另配翻译工具,格式易乱 |
| 知识管理 | 多文档AI知识库,可追溯原文 | 无 |
总体来看,Doc2X的优势在于一体化与结构化:它不是单一功能的工具,而是把解析、转换、翻译、理解串联成工作流,减少用户在多个工具间来回切换的成本。同时,其对学术场景的深度适配(公式、LaTeX、论文翻译)使其在同类产品中具有差异化竞争力。
应用场景
- 学术科研:将外文论文翻译为中文双语对照,提取公式转LaTeX,快速复现实验或撰写综述。
- 技术文档整理:把PDF手册转为Markdown导入知识库,便于团队检索与维护。
- 办公数据处理:将图片表格转为Excel,减少手工录入;拆分合并PDF满足归档需求。
- 扫描件数字化:对老旧合同、书籍扫描件进行矫正增强后再识别,提升数字化质量。
- 开发集成:通过开放平台API批量处理文档,构建企业级文档流水线。
核心功能
优缺点分析
适用人群
常见问题


