
详细介绍
工具简介
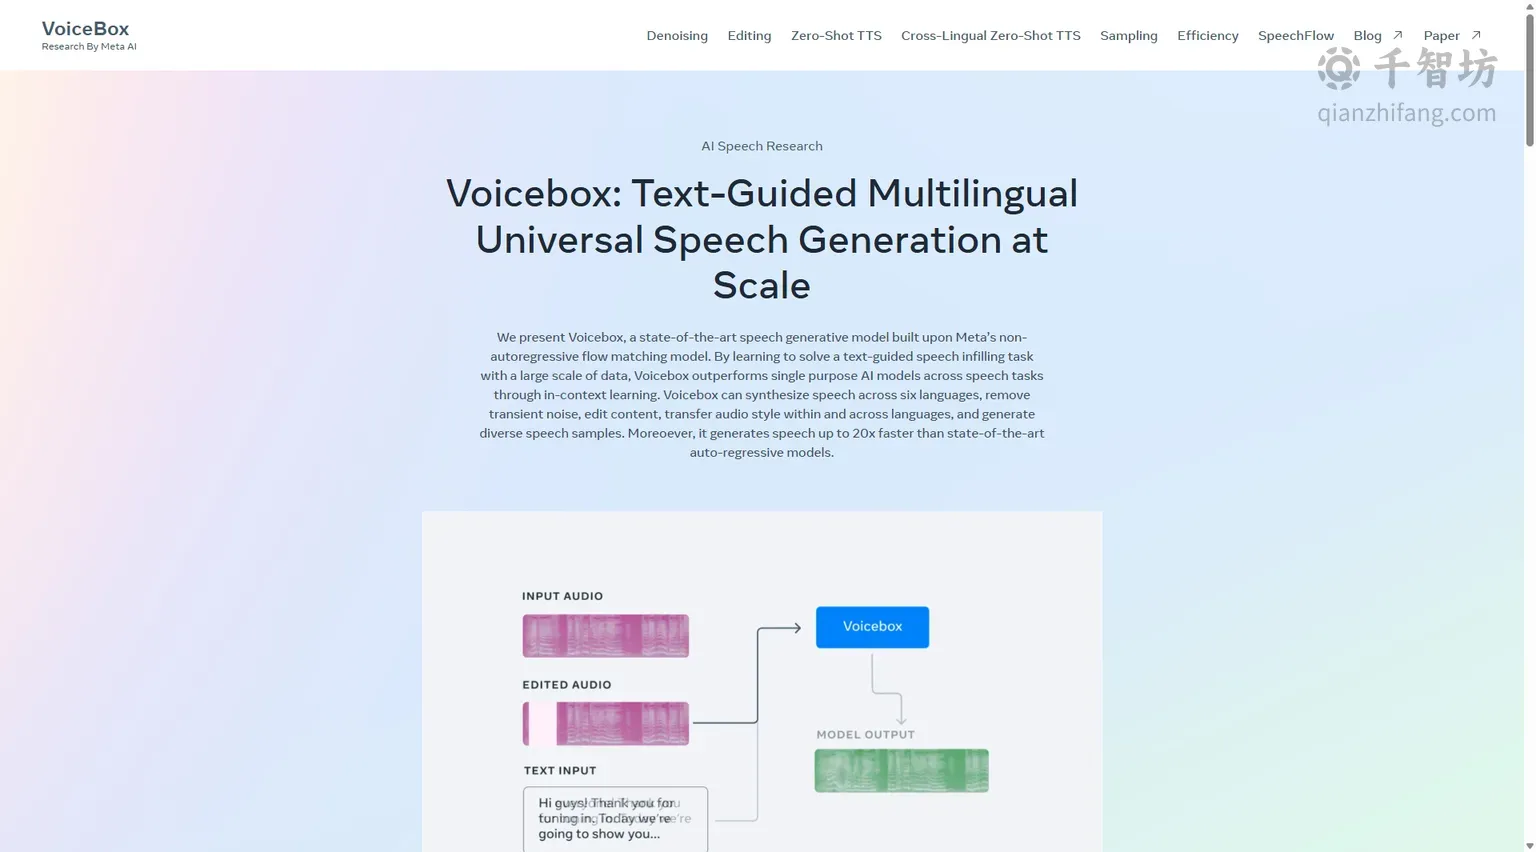
Voicebox 是由 Meta AI 研究团队开发的一款前沿语音生成模型,代表了语音合成领域的重要技术突破。与传统的自回归语音模型不同,Voicebox 采用非自回归流匹配(flow-matching)架构,通过在大规模数据上学习文本引导的语音填充任务,实现了多种语音处理能力。研究团队分别训练了两个版本:一个仅针对英语的模型使用了 60,000 小时的音频数据,另一个多语言版本则覆盖英语、法语、德语、西班牙语、波兰语和葡萄牙语六种语言,训练数据量为 50,000 小时。
Voicebox 的核心创新在于其能够根据过去和未来的上下文进行条件化处理,这使其比自回归模型更加灵活。通过上下文学习(in-context learning),Voicebox 可以执行许多未经明确训练的任务,包括零样本文本到语音合成、跨语言风格转换、瞬态噪声去除、内容编辑以及多样化语音样本生成。尤其值得一提的是,Voicebox 生成语音的速度比当前最先进的自回归模型快 20 倍,这在实时语音处理场景中具有显著优势。
主要功能
瞬态噪声去除
在真实录音场景中,语音经常会被门铃声、狗叫声、咳嗽声等瞬态噪声打断,传统做法往往需要重新录制。Voicebox 提供了一种类似“魔术橡皮擦”的降噪能力:它能够识别并重新生成被噪声污染的语音片段,从而在不重录的情况下恢复干净的语音。这一功能对于播客制作、采访录音、在线会议记录等场景尤为实用,能够大幅节省后期处理的时间和成本。
内容编辑
当说话者说错单词或需要修改某段内容时,传统方式需要重新录制整段音频。Voicebox 的内容编辑功能允许用户直接修正错误单词,模型会根据上下文自动重新生成对应的语音片段,保持整体语音的自然流畅。这意味着音频编辑可以像编辑文本一样简单,极大提升了音频内容制作的效率。
零样本文本到语音合成
Voicebox 具备强大的零样本 TTS 能力。用户只需提供一段参考音频和要合成的文本,模型便能通过上下文学习生成与参考音频在音色、背景噪声和说话风格上高度一致的语音。这意味着无需针对特定说话人进行额外训练,即可快速克隆其声音特征,为个性化语音合成开辟了新的可能性。
跨语言风格转换
Voicebox 不仅支持单语言内的风格转换,还能实现跨语言的语音风格迁移。例如,用户可以提供一段英语音频作为风格参考,让模型生成法语或西班牙语的语音,同时保持原说话者的音色和风格特征。这一功能对于多语言内容本地化、国际化配音等应用具有重要价值。
多样化语音样本生成
得益于流匹配模型的特性,Voicebox 能够生成多样化的语音样本。在给定相同文本和上下文的情况下,模型可以产生不同语调、节奏和风格的语音输出,为内容创作者提供了丰富的选择空间,也便于进行语音数据增强等研究应用。
高效推理
Voicebox 的非自回归架构使其在推理速度上具有显著优势,比自回归模型快 20 倍。这意味着在实际部署中,Voicebox 能够以更低的计算成本实现更快的响应速度,更适合实时语音交互和大规模语音生成任务。
技术原理
Voicebox 基于流匹配(flow matching)技术构建,这是一种用于训练连续归一化流的方法。模型被训练用于解决文本引导的语音填充任务:给定音频上下文和对应文本,模型需要填充缺失的语音片段。由于模型可以同时利用过去和未来的上下文信息,它在处理语音编辑、降噪等任务时具有天然优势。与自回归模型逐帧生成的方式不同,Voicebox 通过流匹配直接学习从噪声到语音的变换过程,从而实现并行生成,大幅提升效率。
应用场景
- 音频后期制作:去除录音中的瞬态噪声,修正说错的单词,无需重新录制。
- 个性化语音合成:通过少量参考音频克隆说话人音色,生成定制化语音内容。
- 多语言内容本地化:将一种语言的语音风格迁移到另一种语言,实现跨语言配音。
- 语音助手与交互系统:利用高效推理能力实现低延迟的语音交互体验。
- 学术研究:为语音生成、语音编辑等研究提供强大的基线模型。
产品优势
相比传统语音合成方案,Voicebox 的核心优势体现在以下几个方面:首先,多任务统一框架——一个模型即可完成降噪、编辑、TTS、风格转换等多种任务,无需针对每个任务单独训练模型;其次,上下文学习能力——通过参考音频即可实现零样本声音克隆,泛化能力强;再次,生成效率高——非自回归架构带来 20 倍的推理速度提升;最后,多语言支持——覆盖六种主要语言,满足国际化应用需求。
使用方法
目前 Voicebox 主要作为研究项目发布,用户可以通过 Meta 官方页面查看各项功能的演示示例,包括降噪、编辑、零样本 TTS、跨语言 TTS、多样化采样和效率对比等。研究团队同时提供了技术论文和博客文章,供研究者和开发者深入了解模型细节。需要注意的是,Voicebox 目前尚未作为商业产品对外开放使用,主要面向研究社区。
核心功能
优缺点分析
适用人群
常见问题


