
详细介绍
工具简介
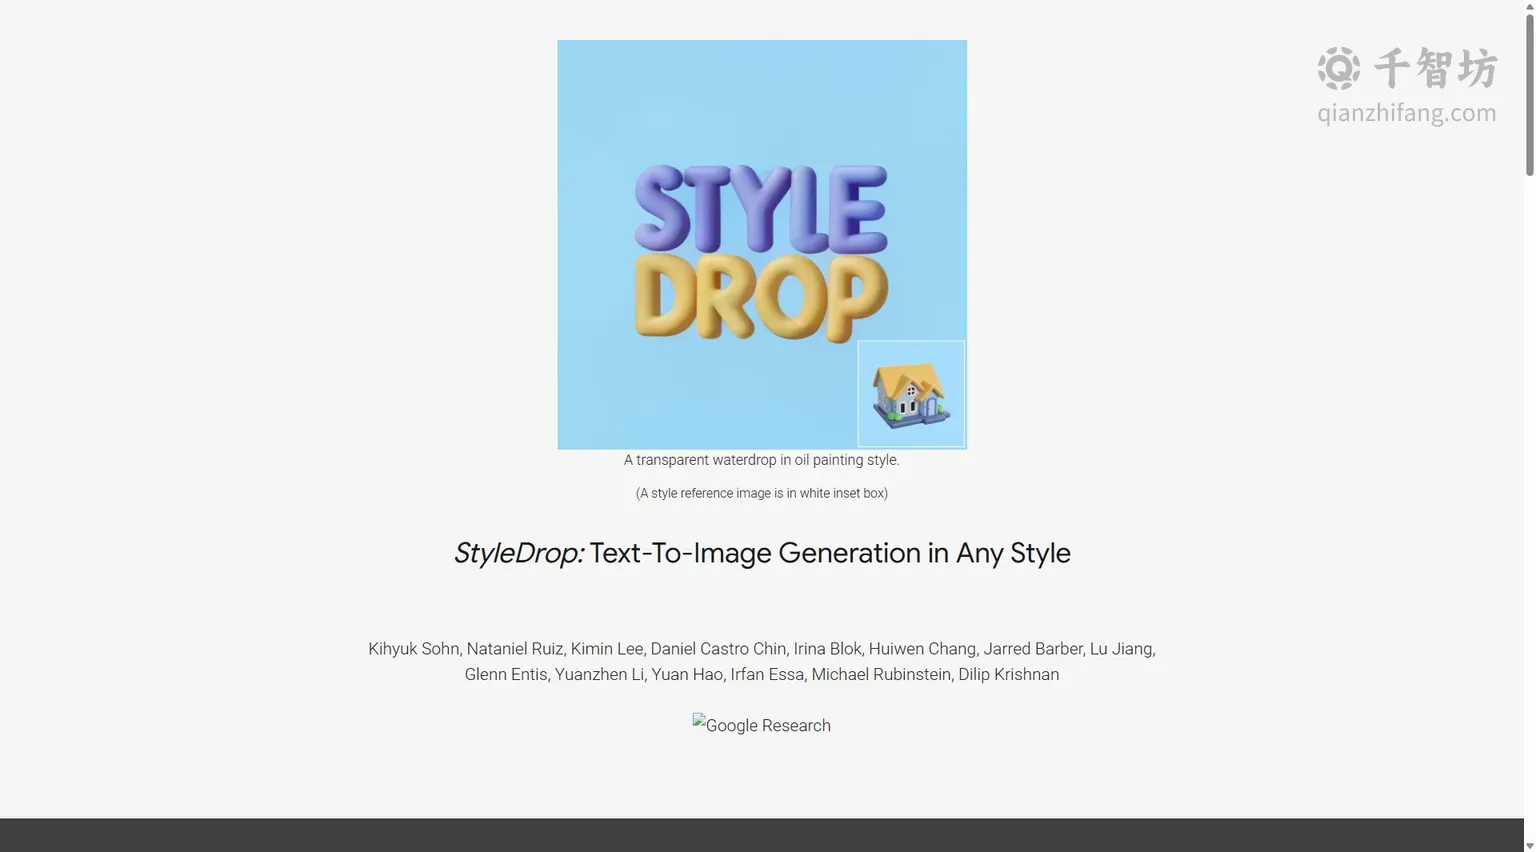
StyleDrop是由谷歌研究团队(Google Research)推出的一款文本到图像生成工具,其核心目标只有一个:让用户能够按照任意指定的风格生成图像。与市面上许多强调“生成什么内容”的AI绘画工具不同,StyleDrop把重点放在了“用什么风格呈现”上——只要给出一张参考图片,它就能学习这张图片的风格特征,并在此基础上生成全新的、风格高度一致的作品。
StyleDrop的背后依托于谷歌自研的Muse文本到图像生成视觉变换器(Vision Transformer)。Muse本身是一个强大的图像生成模型,而StyleDrop则是在其之上构建的一套风格微调机制。官方研究论文(arXiv:2306.00983)显示,StyleDrop能够捕捉用户提供风格的细微之处,包括色彩方案、阴影处理、设计图案、局部效果以及全局效果等,从而生成忠实于参考风格的图像。
值得一提的是,StyleDrop的效率非常高。它通过微调极少量可训练的网络参数来学习新风格,这部分参数不到模型总参数量的1%,因此训练成本低、速度快。更令人惊讶的是,用户只需要提供单张参考图像,StyleDrop就能完成风格学习并生成令人印象深刻的结果,这大大降低了风格定制的门槛。
技术原理与核心机制
基于Muse的风格微调
StyleDrop的工作流程可以概括为“风格学习”与“内容生成”两个阶段。在风格学习阶段,模型接收一张风格参考图,并可能附带一段自然语言的风格描述(例如“in melting golden 3d rendering style”),然后通过微调少量参数来拟合该风格。在生成阶段,用户输入文本提示描述想要的内容,StyleDrop会将风格描述附加到内容描述之后,从而生成既符合文本内容、又符合参考风格的图像。
迭代反馈提升质量
StyleDrop还引入了迭代训练机制:通过人工反馈或自动化反馈,对生成结果进行多轮优化,逐步提升模型对目标风格的表现力。这种“训练—生成—反馈—再训练”的闭环,使得最终输出质量显著优于一次性生成的结果。
与DreamBooth、LoRA、Textual Inversion的对比
在风格化文本到图像生成这一任务上,谷歌进行了广泛的研究对比。结果表明,在Muse模型上运行的StyleDrop,其效果明显优于在Imagen或Stable Diffusion上运行的DreamBooth、Textual Inversion等方法。这意味着在风格复刻的准确度和图像质量上,StyleDrop展现出了领先性。
主要功能
单图风格化文本到图像生成
这是StyleDrop最核心的能力。用户只需提供一张参考图,再输入一段文本提示,StyleDrop就能生成任意内容但风格与参考图一致的高质量图像。例如给出一张水彩画参考图,输入“watercolor painting”相关的提示,即可得到同风格的水彩作品。
风格化字符与Logo渲染
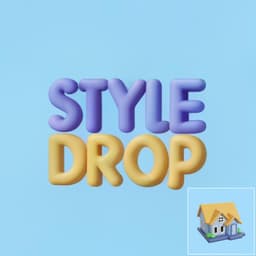
StyleDrop可以生成由单张参考图描述的一致风格的字母图像。官方展示了用3D渲染风格生成“StyleDrop”字样的Logo案例,说明该工具在字体设计、Logo设计、品牌视觉等场景中具有实用价值。
与DreamBooth结合生成“我的主题+我的风格”
StyleDrop可以与DreamBooth组合使用:DreamBooth负责学习特定主体(例如某个人物、宠物或物品),StyleDrop负责学习特定风格,两者结合即可生成“我的主题在‘我的风格’中”的图像,实现高度个性化的创作。
快速风格原型设计
由于StyleDrop易于训练,用户可以快速尝试不同的风格想法,进行风格原型设计和协作。这对于设计师在早期创意阶段快速验证风格方向非常有帮助。
使用方法
根据官方信息,使用StyleDrop的基本步骤如下:
- 提供风格参考图像:选择一张能够代表目标风格的图片,这是风格学习的基础。
- 提供文本提示:描述你想要生成的内容,StyleDrop将据此生成图像。
- 训练与生成:StyleDrop基于参考图和文本提示,通过Muse视觉变换器进行训练,并输出符合指定风格的图像。
- 迭代优化:根据生成结果提供反馈,模型可进一步迭代训练以提升质量。
需要注意的是,StyleDrop目前主要以研究项目形式呈现,官网提供了论文链接和效果展示,尚未像消费级产品那样提供完整的在线编辑界面。
产品优势
- 风格捕捉精准:能够还原色彩、阴影、图案、局部与全局效果等细节。
- 数据需求极低:仅需单张参考图即可学习风格,远低于许多同类方法的数据要求。
- 参数效率高:微调参数不到总量1%,训练快速且成本可控。
- 效果领先:官方研究显示其优于DreamBooth、Textual Inversion等主流方法。
- 灵活性强:支持与DreamBooth组合,实现主体与风格的双重定制。
应用场景
- 品牌视觉设计:基于品牌参考图生成统一风格的Logo、字母和宣传素材。
- 插画与艺术创作:复刻水彩、油画、线稿、卡通等多种绘画风格。
- 个性化内容生产:结合DreamBooth生成个人专属风格的主题图像。
- 设计风格探索:快速原型化不同风格方案,辅助设计决策。
核心功能
优缺点分析
适用人群
常见问题


