
详细介绍
工具简介
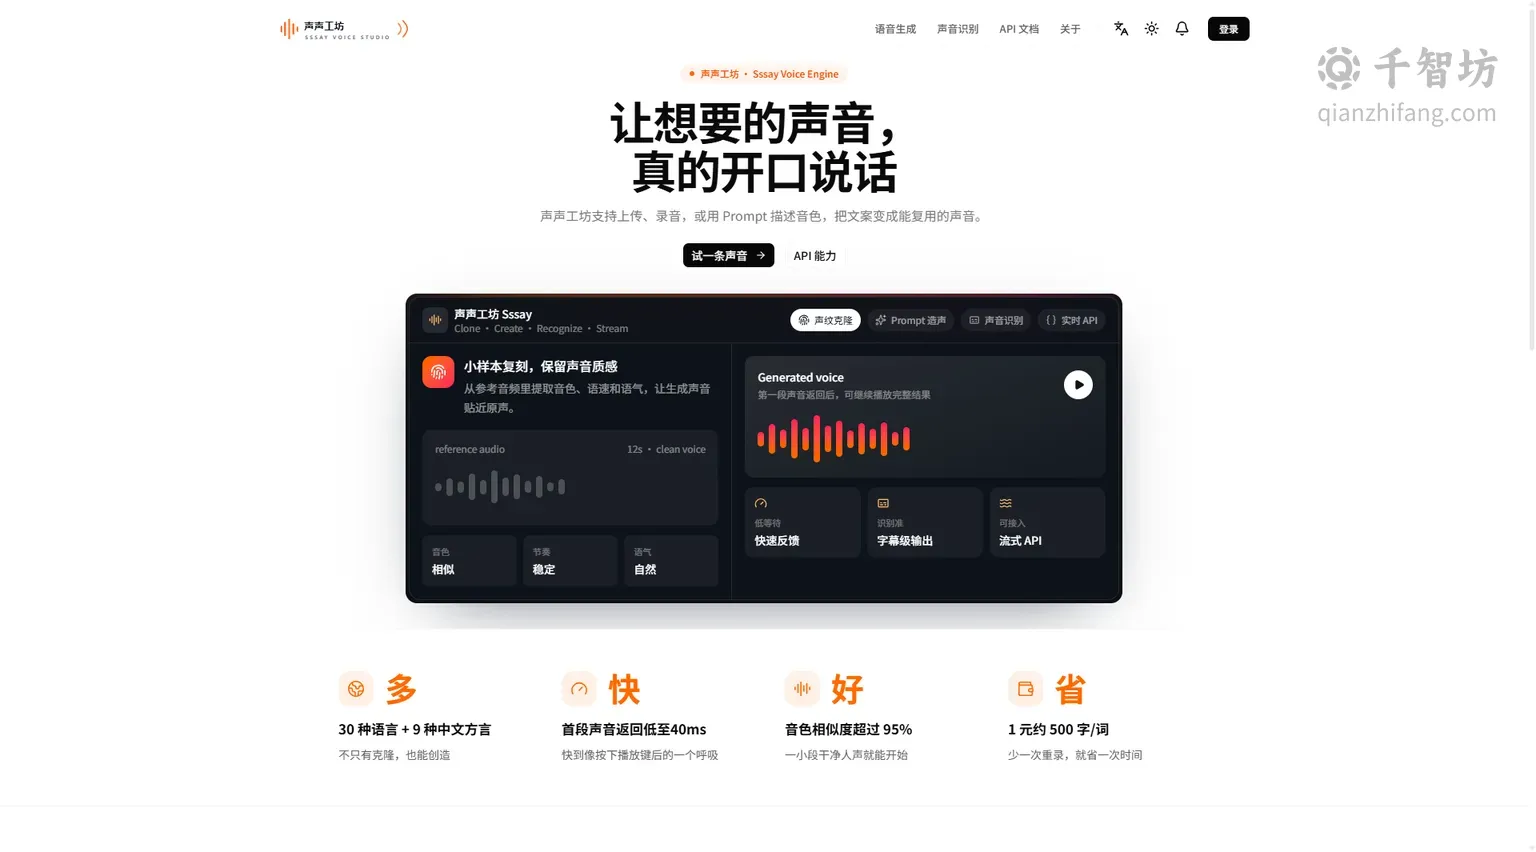
声声工坊(Sssay)是一款主打轻量化与高效率的AI语音合成(TTS)工具,围绕中文声音生产场景构建了一套完整的能力矩阵。与市面上许多功能庞杂、上手门槛较高的语音平台不同,声声工坊将核心体验聚焦在“快”与“准”两个字上——用户只需上传或现场录制5-15秒的参考音频,即可快速生成音色高度相近的专属声音模型,并通过云端长期保存、反复调用,无需漫长的训练等待,也不必具备任何音频处理专业知识。
从产品定位来看,声声工坊并非单纯的“文字转语音”工具,而是覆盖了声音克隆、语音生成、声音识别、字幕输出、API集成等多个环节的声音生产工作流。它支持通过Prompt(提示词)创建全新音色,也支持用简短的方言或风格提示快速切换口音与情绪,配合流式与非流式两种TTS模式,能够满足从个人创作到企业级集成的不同需求。网页端即开即用,电脑或手机浏览器访问官网注册登录后即可开始创作,同时提供OpenAI风格的标准化API接口,方便开发者将配音能力嵌入自有产品。
在计费方式上,声声工坊采用按字/词统一计算的额度体系,用户无需为不同的功能模块分别付费,降低了理解成本。整体而言,声声工坊试图解决的是传统配音流程中“找配音员贵、自己录音难、后期对轴烦”的三大痛点,把声音生产压缩成几步可复用的标准化操作。
主要功能
极速语音克隆
声音克隆是声声工坊最具代表性的能力。用户只需准备一段5-15秒的干净人声音频——可以是本地上传,也可以直接在网页端录制——系统便能据此生成音色相近的专属声音。整个训练过程耗时短,生成后的音色会保存在云端,后续可随时调用,不必每次重新训练。这一机制特别适合需要固定“个人声音IP”的创作者,例如短视频博主、播客主播或企业品牌代言声音,一次克隆即可长期复用,保证内容声音的一致性。
文字转语音TTS
在音色准备就绪后,用户输入文字即可一键生成自然人声配音。声声工坊允许对语速、停顿等参数进行调节,并支持通过提示词切换开心、沉稳等情绪风格,让同一段文案呈现出不同的语气质感。无论是短视频旁白、有声书朗读还是课程讲解,都可以根据内容基调灵活调整,避免机械朗读的单调感。
多方言语音生成
方言能力是声声工坊在中文场景下的一大亮点。用户无需重新训练模型,只需通过简短的提示词即可在四川话、粤语等方言音色之间自由切换,一键改变地域口音。这对于面向本地受众的短视频科普、地方文旅宣传、区域化营销内容而言非常实用,能够显著提升内容的亲切感与代入感。
自动生成字幕
语音生成完成后,声声工坊可自动对音频进行识别,输出带时间轴的SRT、VTT字幕文件。剪辑软件可直接导入这些字幕文件,省去手动打轴、逐句对齐的繁琐步骤。对于需要批量产出视频的创作者来说,这一功能将配音与字幕两个后期环节合二为一,大幅压缩了制作周期。
标准化API接口
声声工坊提供标准化开发接口,同时支持流式实时语音与批量非流式生成两种调用模式。开发者可以将其嵌入小程序、智能设备、剪辑工具等自有产品中,快速获得配音能力。OpenAI风格的接口设计也降低了接入学习成本,便于已有相关技术栈的团队迁移与集成。
使用方法
声声工坊的使用流程非常轻量,整体可分为以下几个步骤:
- 访问与注册:在电脑或手机浏览器中打开声声工坊官网,完成注册登录。
- 准备音色:上传一段5-15秒的参考音频,或直接在线录制;也可以通过Prompt创建新音色。
- 输入文本:在生成界面输入需要配音的文字内容,按需调节语速与停顿。
- 设置风格:通过提示词指定情绪(如开心、沉稳)或方言(如四川话、粤语)。
- 生成与导出:选择流式或非流式模式生成语音,并可同步导出SRT/VTT字幕文件。
对于开发者,则可前往API文档页面查阅接口说明,按OpenAI风格规范完成对接,实现流式实时语音或批量生成。
产品优势
相比传统配音与部分同类工具,声声工坊的优势主要体现在效率与集成度上。首先是克隆门槛低,5-15秒的样本要求远低于许多需要数分钟素材的方案,且训练速度快、音色可云端长期保存。其次是功能链条完整,从音色克隆、文字转语音、方言切换,到字幕导出与API接入,用户不必在多个工具之间来回切换。再次是中文场景适配度高,方言与情绪提示词的设计贴合本土内容创作需求。最后是计费口径统一,按字/词计算额度,便于用户预估成本。
| 对比维度 | 声声工坊 | 传统配音方式 |
|---|---|---|
| 音色准备 | 5-15秒样本极速克隆 | 需专业录音与后期 |
| 方言支持 | 提示词一键切换 | 需另找方言配音员 |
| 字幕产出 | 自动生成SRT/VTT | 手动打轴对齐 |
| 批量生产 | API批量非流式生成 | 逐条录制成本高 |
应用场景
- 短视频配音:产出解说、带货类视频旁白,自带字幕,降低后期剪辑工作量。
- 有声读物制作:复刻专属音色朗读文稿,批量生成小说、电台节目音频。
- 教学课件配音:生成网课讲解、题库朗读语音,音色平稳适配教学素材。
- 商用语音播报:制作门店导览、客服提示音,稳定音色满足企业播报需求。
- 语音集成开发:调用API接入小程序、智能设备,实现实时语音交互。
- 方言内容创作:切换多地方言音色,制作贴合本地受众的科普内容。
核心功能
优缺点分析
适用人群
常见问题


