
详细介绍
工具简介
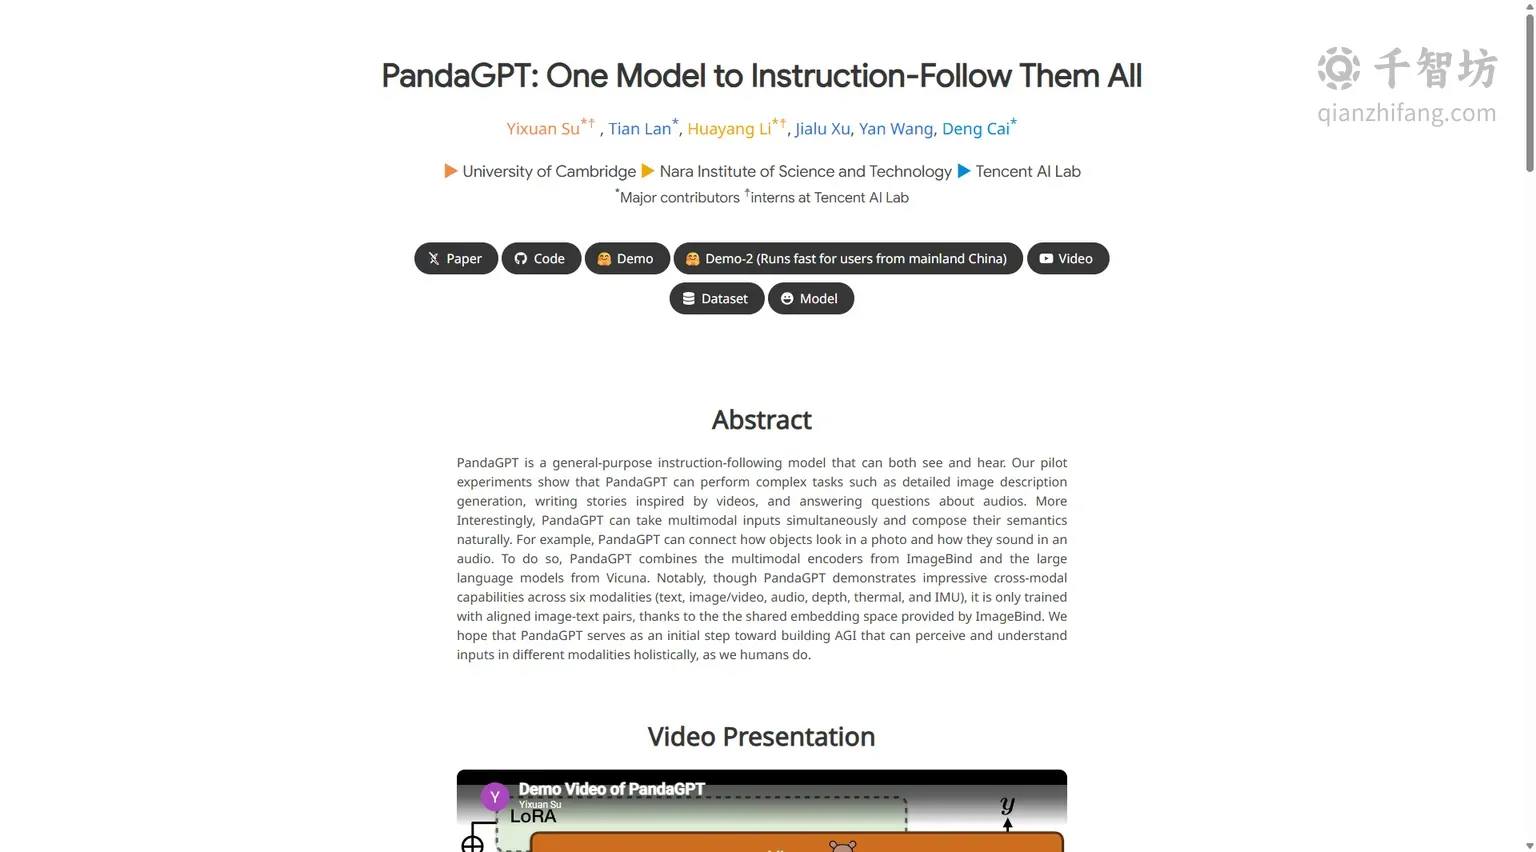
PandaGPT 是一款由剑桥大学、奈良先端科学技术大学院大学(NAIST)以及腾讯 AI Lab 的研究人员共同提出并开源的通用指令遵循模型。该项目在 2023 年 5 月发布论文,同年 6 月正式公开代码与在线演示,迅速成为多模态人工智能领域备受关注的焦点。PandaGPT 的核心定位是“一个模型,遵循所有模态的指令”(One Model to Instruction-Follow Them All),它首次实现了在六种不同模态——文本、图像/视频、音频、深度(3D)、热成像(红外辐射)以及惯性测量单元(IMU)——上执行指令遵循任务的能力。
与传统的多模态模型不同,PandaGPT 并非针对每一种模态单独训练一个专用网络,而是通过巧妙的架构设计,将多模态编码器与大语言模型进行融合。具体而言,它采用了 ImageBind 提供的多模态编码器来提取不同模态的特征,并将这些特征映射到统一表示空间,再通过一个线性投影矩阵连接到 Vicuna 大语言模型的输入空间。同时,研究团队在 Vicuna 的注意力模块上附加了 LoRA 权重,以实现参数高效微调。值得注意的是,尽管 PandaGPT 展现出跨六种模态的惊人能力,但其训练数据仅使用了对齐的图像-文本对(约 16 万条来自 LLaVA 和 Mini-GPT4 的图像-语言指令遵循数据),这得益于 ImageBind 本身提供的共享嵌入空间,使得模型能够“举一反三”地将视觉-语言对齐能力泛化到音频、深度、热成像等其他模态。
PandaGPT 的出现为通用人工智能(AGI)的探索提供了一条极具启发性的路径。它能够同时接受多个模态的输入,并自然地组合不同模态的语义信息。例如,它可以关联照片中物体的外观与音频中该物体发出的声音,实现真正的跨模态理解。这种能力使得 PandaGPT 在详细的图像描述生成、视频启发的故事创作、音频问答以及多轮对话等复杂任务上表现出色。目前,用户可以通过官方提供的在线演示(Demo)直接体验 PandaGPT 的多模态交互能力,项目代码和论文也已全面开源,方便研究者和开发者进行二次开发与实验。
主要功能
跨六模态的指令遵循
PandaGPT 最核心的功能是能够理解并遵循来自六种不同模态的指令。这六种模态包括:文本(自然语言指令)、图像/视频(视觉内容)、音频(声音信号)、深度(3D 空间信息)、热成像(红外辐射数据)以及IMU(惯性测量单元,用于感知运动姿态)。模型可以单独处理任一模态的输入,也可以同时接收多个模态的组合输入,并生成连贯、合理的文本回复。这种统一的多模态处理能力,使得 PandaGPT 在跨模态任务上具备传统单模态模型无法比拟的灵活性。
多模态语义组合与推理
PandaGPT 不仅能识别单一模态的内容,还能将不同模态的语义信息进行自然组合。例如,当同时输入一张图片和一段音频时,模型可以判断图片中的物体与音频中的声音是否匹配,或者根据图片内容生成与之相关的音频描述。这种多模态算术和跨模态推理能力,让 PandaGPT 能够执行更复杂的理解任务,如视觉推理、听觉推理以及图像+音频的联合推理。官方演示中展示了模型如何将照片中物体的视觉特征与音频中对应的声音特征关联起来,体现了其在多模态语义融合方面的强大潜力。
图像与视频的深度理解
在视觉模态方面,PandaGPT 支持对图像和视频进行深入理解。对于图像,它可以生成详细的图像描述,回答关于图像内容的各种问题,并支持基于图像的多轮问答。对于视频,PandaGPT 能够分析视频中的动态场景,生成受视频内容启发的创意故事,或者回答与视频情节相关的问题。这种能力使得 PandaGPT 在内容创作、视频分析、智能客服等场景中具有广泛的应用前景。
音频理解与问答
PandaGPT 具备音频理解能力,可以回答关于音频内容的问题,例如识别音频中的声音类型、描述音频所表达的情感或场景。结合视觉输入,模型还能实现图像与音频的联合理解,比如根据一张图片和一段音频判断两者是否描述同一场景。这种跨模态的音频理解能力,为智能助手、无障碍辅助、多媒体检索等应用提供了新的技术手段。
创意性写作与故事生成
基于多模态输入,PandaGPT 可以执行创意性写作任务。例如,给定一张图片或一段视频,模型能够编写出与之相关的故事、诗歌或描述性文字。这种“受图像/视频启发的创意性写作”功能,展示了模型在理解视觉内容的基础上进行创造性语言生成的能力,可应用于广告文案、内容营销、教育娱乐等领域。
多轮对话与交互
PandaGPT 支持多轮对话,用户可以在对话中逐步深入提问,模型能够结合上下文和多模态输入给出连贯的回答。例如,用户可以先用图片提问,再根据模型的回答继续追问细节,模型能够保持对话的连贯性和一致性。这种交互方式更贴近人类自然的交流习惯,提升了用户体验。
使用方法
PandaGPT 目前主要通过在线演示(Demo)供用户体验,同时也开源了代码和模型,供研究人员和开发者本地部署。以下是基本的使用步骤:
- 访问在线演示:用户可以通过官方主页(https://panda-gpt.github.io)找到演示链接,或直接访问腾讯 AI Lab 提供的在线体验页面。官方提供了两个 Demo 入口,其中 Demo-2 针对中国大陆用户进行了访问速度优化。
- 上传多模态输入:在演示界面中,用户可以上传图像、视频或音频文件,也可以在文本框中输入自然语言指令。部分演示支持同时上传多种模态的内容。
- 输入指令并获取回复:用户以自然语言形式提出问题或指令,例如“请描述这张图片的内容”“根据这段视频写一个故事”“这段音频里是什么声音”等。模型会分析输入的多模态信息并生成文本回复。
- 多轮交互:用户可以根据模型的回复继续追问,进行多轮对话,逐步深入探索多模态内容。
- 本地部署(开发者):开发者可以从 GitHub 获取开源代码,按照项目文档配置环境、下载模型权重,并在本地运行 PandaGPT。项目基于 ImageBind 和 Vicuna 构建,需要相应的计算资源支持。
产品优势
| 对比维度 | PandaGPT | 传统单模态模型 |
|---|---|---|
| 支持模态数量 | 六种(文本、图像/视频、音频、深度、热成像、IMU) | 通常仅支持一种或两种模态 |
| 多模态语义组合 | 支持同时输入多个模态并自然组合语义 | 难以实现跨模态语义融合 |
| 训练数据效率 | 仅用图像-文本对训练即可泛化到六种模态 | 每种模态需单独标注数据 |
| 开源程度 | 代码、论文、模型全面开源 | 多为闭源或部分开源 |
PandaGPT 的核心优势在于其统一的多模态架构和高效的训练策略。通过利用 ImageBind 的共享嵌入空间,模型在仅使用图像-文本对齐数据训练的情况下,就能将指令遵循能力泛化到音频、深度、热成像和 IMU 等模态,这大大降低了多模态模型对标注数据的依赖。此外,PandaGPT 完全开源,研究者和开发者可以自由使用、修改和扩展,为多模态 AI 的研究与应用提供了坚实的基础。其在线演示也让普通用户能够零门槛体验跨模态 AI 的能力。
应用场景
- 基于图片的问答与多轮对话:用户上传图片后,可以就图片内容进行提问,模型能够给出详细回答,并支持多轮追问,适用于教育、客服、无障碍辅助等场景。
- 基于视频的问答与内容分析:对视频内容进行理解并回答相关问题,可用于视频内容审核、智能剪辑辅助、视频摘要生成等。
- 创意性写作:根据图像或视频激发灵感,生成故事、文案、诗歌等创意内容,服务于广告、媒体、娱乐行业。
- 视觉与听觉推理:结合图像和音频进行联合推理,例如判断场景与声音是否匹配,可用于多媒体检索、智能监控等。
- 多模态教育与研究:作为开源多模态模型,PandaGPT 是研究跨模态学习、指令遵循、AGI 路径的理想实验平台,也可用于高校教学演示。
核心功能
优缺点分析
适用人群
常见问题


