
详细介绍
工具简介
OpenBayes(中文名:贝式计算)是一款面向人工智能与高性能计算(AI + HPC)场景打造的一站式机器学习平台,由贝式计算团队研发运营。它的核心理念是「让计算更简单」,致力于帮助算法工程师、数据科学家、科研人员以及企业团队摆脱繁琐的环境配置与运维负担,把精力真正集中在业务逻辑与模型创新上。与市面上许多轻量级的「沙盒式」在线 Notebook 工具不同,OpenBayes 从设计之初就定位为「生产就绪」的企业级平台,既适合个人开发者做小型实验,也能支撑企业级的大规模训练与部署需求。
平台底层基于容器与 Kubernetes 构建资源调度体系,拥有天河级别的超算集群,其 GPU 集群架构专为矩阵计算进行优化。用户无需手动安装驱动、配置 CUDA 环境,即可在秒级启动的容器中获得完整的交互式机器学习体验。OpenBayes 同时整合了算力容器、数据仓库、自动化建模、模型部署、公共资源库以及企业私有化部署等多个模块,形成从数据管理、模型训练到在线推理的完整 MLOps 闭环。
主要功能
Gear 算力容器
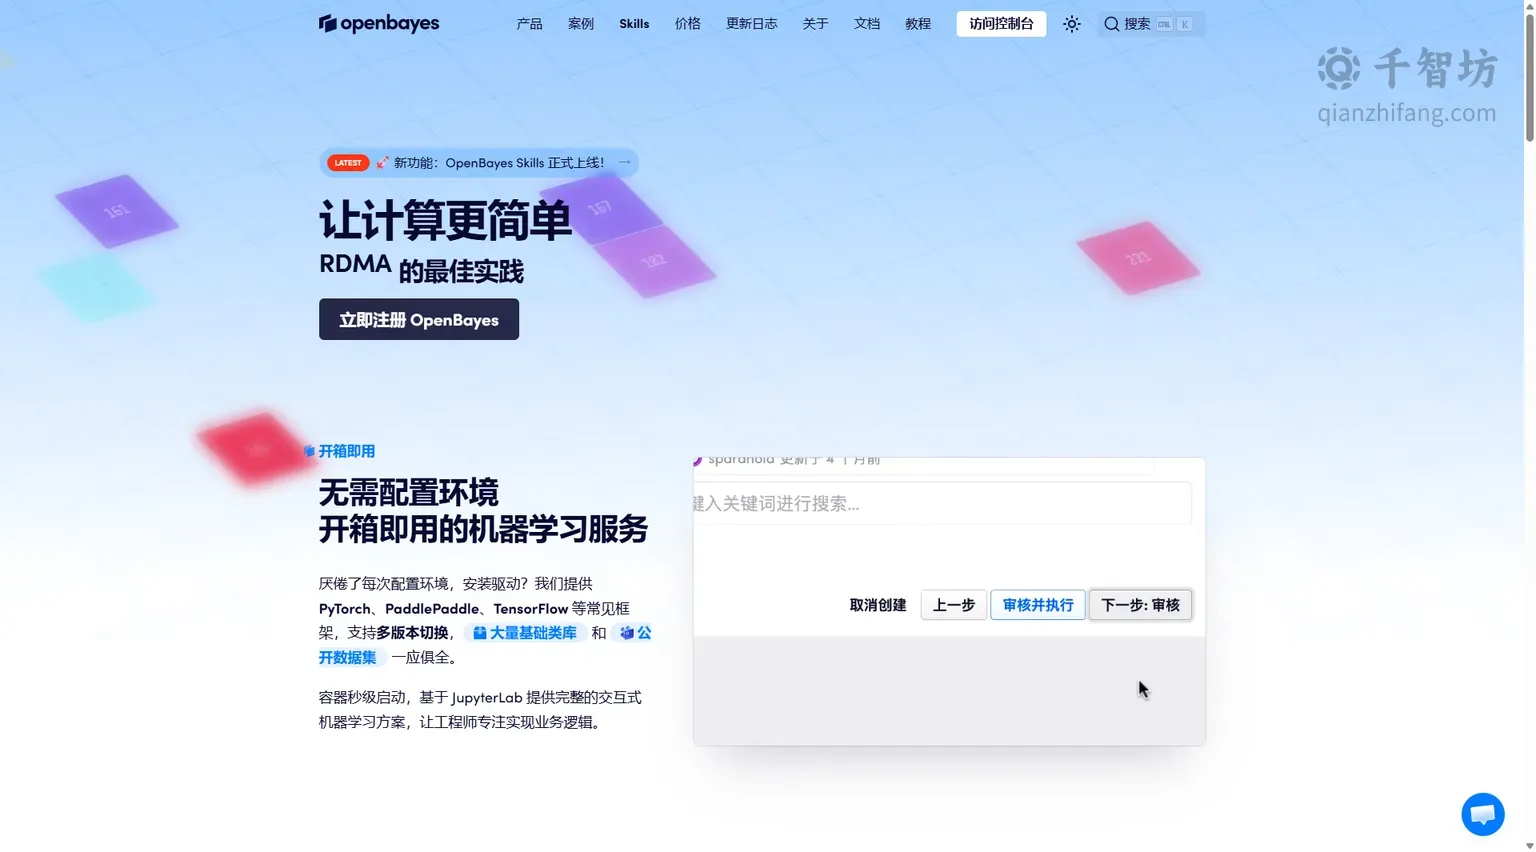
Gear 算力容器是 OpenBayes 的核心产品之一,提供开箱即用的 GPU 容器服务。平台预置了 PyTorch、PaddlePaddle、TensorFlow 等主流深度学习框架,并支持多版本自由切换,同时内置大量基础类库与公开数据集,用户无需再为环境依赖问题耗费时间。容器可实现秒级启动,并基于 JupyterLab 提供完整的交互式编程环境,让工程师专注于业务逻辑实现。对于进阶用户,平台还提供 CLI 命令行工具、超参数自动调参、SSH 登录等功能,配置完成后可连接 PyCharm、VS Code 进行远程调试,真正实现「云编程」。
Data Warehouse 数据仓库
数据仓库模块用于模型及数据集的存储与管理,可存放任意类型的数据,包括代码、训练模型文件、数据集等。相比一些在线平台每次挂载数据集都要忍受漫长等待,OpenBayes 支持数据秒级绑定,并支持 TB 级的数据管理能力以及断点续传功能,大幅提升大文件上传与管理的效率。用户可以在此基础上创建数据集,实现版本化、结构化的数据资产管理。
Automation 自动化建模
Automation 模块提供 AutoML 自动建模服务,帮助用户减少机器学习过程中反复试错的时间。结合超参数自动调参能力,平台可以自动搜索较优的模型配置,降低对调参经验的依赖,让新手也能较快得到可用的模型结果,同时为资深工程师节省大量重复劳动。
Serving 模型部署
Serving 模块负责模型部署及在线推理服务,帮助用户将训练完成的模型快速转化为可对外提供服务的 API 或推理端点,打通从实验到生产的最后一公里,配合平台的弹性可扩展架构,可随时适应业务量的变化。
Open Resources 公共资源
平台提供公共数据集、教程与预训练模型等开放资源。OpenBayes 人工智能实验室作为中国领先的人工智能研究机构,拥有大量独家数据集及天河级别超算集群,这些资源对平台用户开放,可显著降低研究与开发的前期准备成本。
Enterprise 私有部署
针对企业客户,OpenBayes 提供完整的私有化部署方案。无论是物理集群还是混合云环境,均可通过弹性可扩展架构实现算力算法按需供给,以较低成本获得较高性能的计算服务,满足企业对数据安全与合规的严格要求。
使用方法
使用 OpenBayes 的流程相对直观:首先访问官网注册账号并进入控制台;随后可在 Gear 算力容器中选择所需的框架与版本,秒级启动一个 JupyterLab 环境开始编写与调试代码;训练所需的数据可提前上传至 Data Warehouse 数据仓库,并在容器中秒级绑定挂载;模型训练完成后,可通过 Serving 模块部署为在线推理服务,或使用 Automation 模块进行自动建模与调参。对于习惯本地开发的用户,还可通过 CLI 工具或 SSH 连接 PyCharm、VS Code 进行远程开发调试。
产品优势
| 对比维度 | OpenBayes 的表现 |
|---|---|
| 环境配置 | 预置主流框架与类库,无需手动装驱动,容器秒级启动 |
| 数据管理 | 秒级绑定,支持 TB 级存储与断点续传 |
| 扩展能力 | 基于容器与 Kubernetes 调度,弹性可扩展,适配企业级需求 |
| 开发方式 | 支持 JupyterLab、CLI、SSH 远程调试,兼容 PyCharm / VS Code |
| 部署形态 | 支持公有云使用与企业私有化部署 |
总体而言,OpenBayes 在「易用性」与「生产就绪」之间取得了较好的平衡:既降低了新手入门机器学习的门槛,又提供了足以支撑企业级应用的调度、存储与部署能力。
应用场景
- 医疗影像建模:结合多模态数据辅助诊疗,利用平台算力与数据管理能力处理医学影像数据。
- 遥感数据分析:服务于智能化天基卫星观测网等场景,处理大规模遥感数据。
- 智慧港务系统:构建码头调度智能决策中枢,将 AI 模型应用于实际业务决策。
- 科研与教学:研究人员可利用公共数据集与预训练模型快速开展实验。
- 企业 AI 落地:通过私有化部署满足数据合规要求,支撑企业内部的模型训练与推理服务。
核心功能
优缺点分析
适用人群
常见问题


