
详细介绍
工具简介
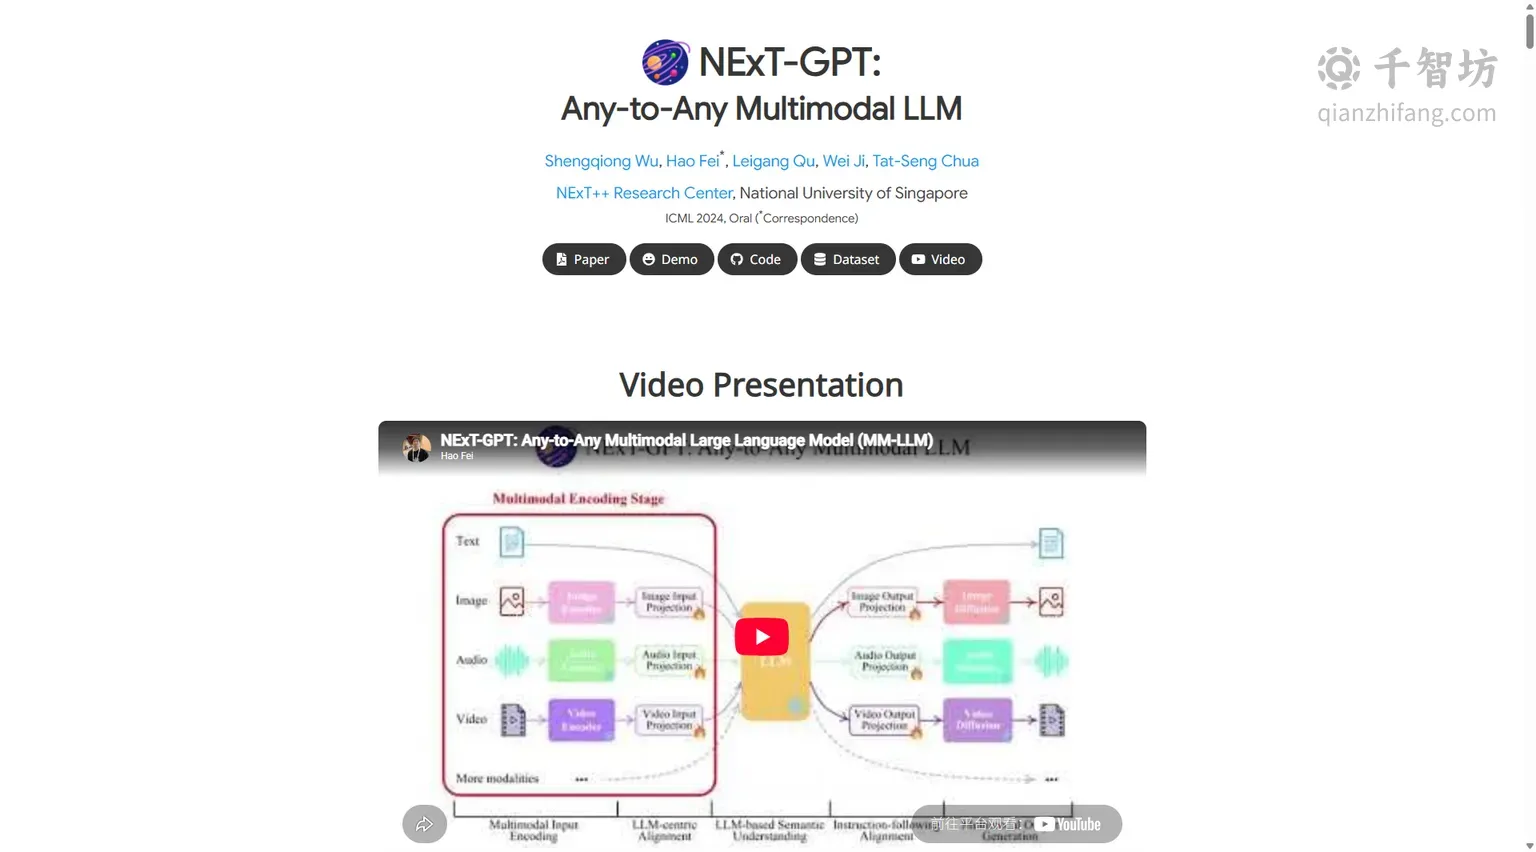
NExT-GPT是由新加坡国立大学NExT++研究中心的华人团队(Shengqiong Wu、Hao Fei、Leigang Qu、Wei Ji、Tat-Seng Chua)研发的一款端到端通用任意模态到任意模态(Any-to-Any)多模态大语言模型。该项目在ICML 2024上被接收为Oral论文,是首个实现从任一模态输入到任一模态输出的开源多模态系统,标志着向通用人工智能目标迈出的重要一步。
传统多模态大模型大多局限于输入侧的多模态理解,即只能接受文本、图像等输入,但输出往往仅限于文本。NExT-GPT打破了这一限制,它能够接受文本、图像、视频、音频中任意组合的输入,并生成文本、图像、视频、音频中任意组合的输出。例如,用户可以输入一段文字描述,要求生成一张图片和一段语音;也可以输入一张图片,要求生成一段视频和文字说明。这种自由组合的能力充分模拟了人类通过多种感官感知世界并进行表达的方式。
从技术架构上看,NExT-GPT并没有从零创新算法,而是“站在巨人的肩膀上”,通过组合优化现有各类开源模块实现全能目标。模型包含三个层次:第一层使用多模态编码器(如ImageBind)对输入进行编码;第二层使用大语言模型(Vicuna)进行复杂推理;第三层使用扩散解码器生成各种模态输出。特别值得一提的是,NExT-GPT仅需微调约1%的参数(特定投影层),即可实现模态特征表达的端到端对齐训练,大大降低了训练成本,也便于未来扩展更多模态。
此外,研究团队还提出了模态切换指令微调(MosIT)方法,并手工构建了高质量的MosIT数据集,使模型具备复杂的跨模态语义理解和内容生成能力。NExT-GPT的出现为构建通用多模态AI智能体提供了宝贵的借鉴,后续工作可考虑扩展更多模态、使用更大规模语言模型基座以及改进多模态生成策略等。
主要功能
任意模态输入理解
NExT-GPT支持文本、图像、视频、音频等多种模态的任意组合输入。通过ImageBind等统一高性能编码器,将不同模态的输入映射到语言模型可理解的特征空间,实现跨模态的语义理解。用户可以用文字描述需求,也可以上传图片或视频让模型分析,甚至同时提供多种模态信息。
任意模态输出生成
模型能够根据用户请求,生成文本、图像、视频、音频中任意组合的输出。例如,输入一段文字,模型可以同时生成配图和配音;输入一张图片,模型可以生成描述文字和一段相关视频。这种任意到任意的输出能力是NExT-GPT的核心突破。
跨模态语义推理
以大语言模型Vicuna为核心推理引擎,NExT-GPT能够对多模态输入进行深层次的语义理解和逻辑推理,并输出文本响应以及各模态的信号令牌,指导解码器生成相应内容。模型具备复杂的跨模态语义理解能力,能够处理需要综合多种信息才能回答的问题。
模态切换指令微调(MosIT)
研究团队提出的MosIT方法以及手工构建的高质量数据集,使模型能够根据指令灵活切换输入输出模态。通过指令微调,NExT-GPT学会了在复杂场景下理解用户意图,并选择恰当的模态组合进行响应,提升了交互的自然性和准确性。
低成本高效训练
NExT-GPT仅需微调约1%的参数(特定投影层),即可实现端到端的多模态对齐训练。这得益于对现有预训练编码器和解码器的充分利用,不仅降低了训练成本,也为后续扩展更多模态提供了便利。
开源可扩展架构
项目代码、数据集和论文均已开源,研究者和开发者可以基于NExT-GPT进行二次开发,扩展新的模态或改进生成策略。模块化的设计使得替换更强的语言模型基座或更优的解码器变得容易。
使用方法
NExT-GPT目前主要面向研究者和开发者,可通过以下步骤使用:
- 访问项目官网:前往 https://next-gpt.github.io 了解项目详情,获取论文、代码和演示视频。
- 获取代码与模型:从GitHub仓库(https://github.com/NExT-GPT/NExT-GPT)克隆代码,并按照说明下载预训练模型权重和数据集。
- 环境配置:根据项目文档安装依赖环境,包括PyTorch、ImageBind、Vicuna等相关库。
- 运行演示:使用提供的演示脚本,输入文本、图像等模态,体验任意到任意的生成效果。
- 自定义微调:研究者可使用MosIT数据集对模型进行指令微调,或扩展新的模态适配器。
产品优势
| 对比维度 | NExT-GPT | 传统多模态模型 |
|---|---|---|
| 输入模态 | 文本、图像、视频、音频任意组合 | 通常仅文本或文本+图像 |
| 输出模态 | 文本、图像、视频、音频任意组合 | 通常仅文本 |
| 训练成本 | 仅微调1%参数 | 需大量参数调整 |
| 扩展性 | 模块化设计,易于扩展新模态 | 扩展困难 |
NExT-GPT的核心优势在于其真正的任意到任意多模态能力,而非固定模式的输入输出。它通过组合现有高性能模块,以极低的训练成本实现了通用多模态理解与生成,为多模态AI研究提供了新的范式。
应用场景
- 内容创作:根据文字脚本自动生成配图、视频和配音,提升创作效率。
- 智能助手:理解用户的多模态指令,并以多种模态回应,如语音+文字+图片。
- 教育培训:将文本教材转换为图文并茂的视频课程,或根据图片生成讲解语音。
- 无障碍服务:为视障用户将图像转换为语音描述,为听障用户将语音转换为文字和图像。
- 学术研究:作为多模态大模型的研究基线,推动任意模态AI的发展。
核心功能
优缺点分析
适用人群
常见问题


