
详细介绍
工具简介
MVSEP(全称 Music and Voice Separation)是一款专注于AI音频源分离的在线工具,用户只需将音频文件拖拽上传,即可借助深度学习模型将一首完整的歌曲拆解为人声、鼓、贝斯、钢琴、吉他、弦乐、管乐、打击乐等多个独立音轨。与传统的均衡器或中置声道消除等物理方法不同,MVSEP 依托 Roformer、SCNet、HyperACE 等多种神经网络模型,能够在复杂混音中实现更干净、更精准的分离效果,因此被大量音乐制作人、翻唱爱好者、视频创作者和音频工程师用于制作伴奏、提取采样或进行后期混音。
MVSEP 的核心价值在于把过去需要专业录音棚设备和昂贵软件才能完成的“分轨”工作,变成了浏览器里几步即可完成的在线操作。网站界面提供了清晰的分离类型选择区,包括 Featured(精选)、Vocals(人声)、Drums(鼓)、Bass(贝斯)、Piano(钢琴)、Guitar(吉他)、Wind(管乐)、Strings(弦乐)、Super Resolution(超分辨率)、Percussion(打击乐)、Keys(键盘)、MIDI 等分类,用户可以根据目标音轨直接进入对应模型,而不必在众多算法中盲目尝试。每个模型旁边还会显示月使用量、用户评分等参考数据,帮助新手快速判断哪个算法更受欢迎、效果更稳定。
主要功能
多类型音轨分离
MVSEP 最基础也最常用的功能是人声与伴奏分离。用户上传歌曲后,选择 Vocals 分类下的模型,即可得到一条干净的人声轨和一条伴奏轨。对于需要制作卡拉OK伴奏、翻唱视频或二次创作的用户来说,这一功能可以省去大量手动剪辑和降噪的时间。除人声外,平台还支持将鼓、贝斯、钢琴、吉他、弦乐、管乐、打击乐等乐器分别提取出来,方便制作人进行采样重组、Remix 或单独调整某一乐器的音量与音色。
丰富的预设方案
MVSEP 提供了一系列经过调优的预设(Presets),每个预设都标注了算法数量、基础模型数量、月使用量和用户评分。例如 Phase-corrected instrumental (Deux) 采用 MelBand Roformer 分离音轨,再通过频谱反相重建伴奏,保留原始混音的相位信息,单模型即可完成,无需二次分离;Ensemble vocals + instrumental (124-bands weighted) 则是三个模型的加权集成,其中 BS Roformer 124-bands 被计算两次,SCNet 与 MelBand Roformer 共同参与,分别输出人声和伴奏两条音轨,用最强模型主导、其余模型抑制伪影;Karaoke pack (keep backing vocals) 会去掉主唱但保留和声,并额外输出一条独立主唱轨,非常适合制作卡拉OK版本。这些预设把复杂的模型组合逻辑封装成一键操作,显著降低了使用门槛。
相位校正与去混响
在音频分离中,相位问题常常导致伴奏听起来“发虚”或瞬态模糊。MVSEP 的相位校正预设通过频谱反相重建伴奏,使结果保留原始混音的相位,从而获得比模型直接输出更干净的瞬态响应。此外,平台还提供 Dry acapella (de-reverbed) 等去混响预设,先提取人声再去除房间混响,得到干燥、贴耳的清唱素材,适用于采样包制作或人声后期处理。
主唱与和声分离
对于需要精细处理人声的用户,MVSEP 提供两阶段分离方案:先提取出整体人声,再将人声拆分为主唱(Lead)与和声(Backing)。官方说明指出,对已经干净的人声进行二次拆分,效果远好于直接对整首混音使用卡拉OK模型,因此这一预设特别适合需要单独调整和声比例或制作纯主唱版本的用户。
超分辨率与 MIDI 转换
除了分轨,MVSEP 还设有 Super Resolution(超分辨率) 分类,可用于提升音频质量;MIDI 分类则面向需要将音频转换为 MIDI 数据的用户,方便在数字音频工作站中进行编曲或二次创作。这些扩展功能让 MVSEP 不仅是分离工具,也逐步成为音频处理的一站式工作台。
使用方法
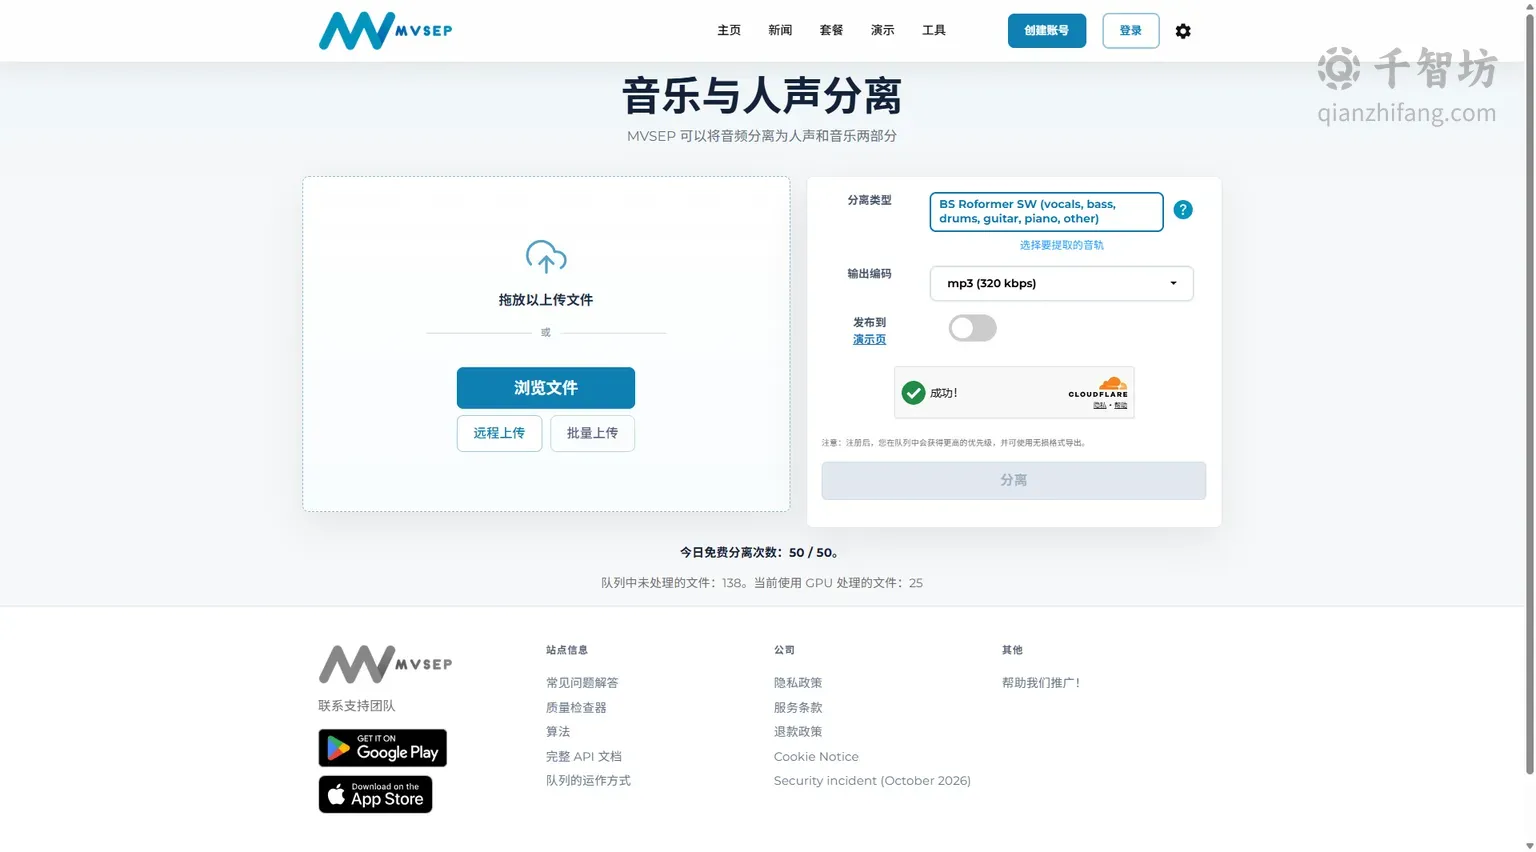
MVSEP 的使用流程非常直接:打开官网后,将音频文件拖拽到上传区域,或点击选择文件上传;系统会提示“Drag & Drop to Upload File / Release to Upload File”,上传过程中可随时停止。上传完成后,在分离类型中选择目标类别(如 Vocals、Drums、Bass),再挑选具体模型或预设,确认后等待处理完成即可下载分离结果。网站会对非音频文件给出“This is not an Audio File! Aborted”的错误提示,因此上传前需确认文件格式为常见音频格式。部分高级预设标注了 [Premium only],需要订阅高级版才能使用,而基础模型和部分官方预设则对普通用户开放。
产品优势
MVSEP 的优势首先体现在模型丰富且持续更新。平台集成了 Roformer、SCNet、HyperACE 等多种前沿分离模型,并通过集成学习、相位校正、两阶段分离等策略不断优化输出质量。其次是透明度高:每个预设都公开月使用量、评分和算法构成,用户可以根据社区反馈选择方案,而不是盲目试错。第三是在线即用,无需安装本地软件,也不依赖高性能显卡,对设备配置要求低。最后,平台同时覆盖人声、乐器、MIDI、超分辨率等多种需求,适合从普通爱好者到专业制作人的不同层次用户。
应用场景
- 翻唱与卡拉OK制作:提取伴奏、保留和声,快速制作演唱用音轨。
- 音乐制作与Remix:单独提取鼓、贝斯、钢琴等乐器,用于采样、重编曲或混音练习。
- 视频与播客后期:分离人声与背景音乐,便于替换配乐或进行降噪处理。
- 音频研究与教学:通过分轨结果分析混音结构,辅助音乐制作教学。
- 采样包与音效制作:获取干燥清唱、单独乐器音色,用于构建个人音色库。
总体而言,MVSEP 是一款功能全面、信息透明、上手门槛低的 AI 音轨分离工具,尤其适合需要频繁处理人声与伴奏分离的用户。虽然部分高级预设需要付费,但免费可用的模型和预设已经能够覆盖大多数日常需求,是音频分离领域值得关注的在线工具之一。
核心功能
优缺点分析
适用人群
常见问题


