
详细介绍
工具简介
MiniGPT-4 是由阿卜杜拉国王科技大学(KAUST)视觉计算实验室(Vision-CAIR)的研究团队 Deyao Zhu、Jun Chen、Xiaoqian Shen、Xiang Li 与 Mohamed Elhoseiny 等人联合 UCLA 及微软研究院共同推出的一款开源多模态大语言模型。该项目在 CVPR 2023 上发表,旨在探索 GPT-4 强大跨模态生成能力背后的关键因素。研究团队认为,GPT-4 之所以能够直接从手写文本生成网站、识别图片中的幽默元素,核心原因在于其使用了更先进的大型语言模型。为了验证这一假设,他们构建了 MiniGPT-4,将冻结的视觉编码器与冻结的 Vicuna 大语言模型通过一个线性投影层对齐,从而以极低的计算成本复现了 GPT-4 的诸多多模态能力。
MiniGPT-4 的架构由三部分组成:一个预训练的 ViT 视觉编码器配合 Q-Former、一个单一的线性投影层,以及先进的 Vicuna 大语言模型。整个训练过程仅需训练线性层,用于将视觉特征与 Vicuna 的语义空间对齐,使用的对齐图文对约 500 万。这种设计使得模型在计算上非常高效,同时保留了强大的视觉理解与语言生成能力。研究团队发现,仅在原始图文对上进行预训练会产生不连贯、重复、句子碎片化等不自然的语言输出;为此他们在第二阶段精心构建了高质量、良好对齐的数据集,并采用对话模板进行微调,这一步骤对提升模型的生成可靠性和整体可用性起到了关键作用。
主要功能
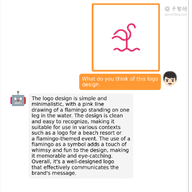
MiniGPT-4 具备丰富的图像理解与对话能力,能够完成多种贴近真实场景的任务。根据官方演示与用户实测,其核心功能包括:
- 图像内容解释:对上传的照片进行详细描述,识别画面中的物体、场景、人物动作及整体氛围,生成连贯自然的图像说明文字。
- 问题发现与解决建议:例如识别出照片中枯萎的植物,并给出具体的养护与处理方案,体现模型对图像中异常状态的推理能力。
- 创意写作:根据给定照片创作诗歌、故事等文学作品,将视觉元素转化为富有情感与想象力的文字。
- 草图转代码:尝试将手绘草图转换为 HTML/JS 代码,虽然实测效果有限,但展示了类似 GPT-4 从手写文本生成网站的潜力。
- 广告文案生成:为给定照片撰写广告文案,适用于商品展示与营销场景。
- 食谱与购物清单:根据食物照片生成对应的食谱和购物清单,帮助用户规划烹饪。
- 艺术解读:对艺术作品进行解释与分析,帮助用户理解画作的内涵与表现手法。
使用方法
MiniGPT-4 提供了多种体验方式,普通用户无需本地部署即可快速上手。最便捷的方式是通过 Hugging Face Spaces 上的在线演示(https://huggingface.co/spaces/Vision-CAIR/minigpt4)直接上传图片并进行对话。对于希望深入研究或二次开发的用户,可以访问项目官网(https://minigpt-4.github.io)获取论文、代码、数据集与模型权重。GitHub 仓库 Vision-CAIR/MiniGPT-4 提供了完整的开源代码,支持 Vicuna V0 和 Llama 2 两种版本的大语言模型权重。开发者可以按照官方文档配置环境、下载模型权重并进行本地推理或微调。项目还提供了 Gradio 演示界面,方便用户搭建自己的交互式应用。整体而言,MiniGPT-4 的使用门槛较低,在线演示适合快速体验,开源代码则适合学术研究与工程实践。
产品优势
MiniGPT-4 的核心优势体现在以下几个方面:
- 计算效率极高:仅训练一个线性投影层,使用约 500 万对齐图文对,大幅降低了训练成本,使得中小团队也能复现多模态能力。
- 开源开放:代码、模型、数据集全部开源,支持 Vicuna 和 Llama 2 多种基座模型,便于学术研究与商业探索。
- 能力接近 GPT-4:在图像描述生成、手写草图转网站等任务上展现出与 GPT-4 相似的多模态生成能力,同时还涌现出写诗、讲故事、烹饪教学等新能力。
- 两阶段训练策略:通过高质量对齐数据集的第二阶段微调,显著提升了生成语言的连贯性与可靠性,解决了原始预训练输出不自然的问题。
| 对比维度 | MiniGPT-4 | GPT-4 |
|---|---|---|
| 开源性 | 完全开源 | 闭源 |
| 训练成本 | 仅训练线性层,成本低 | 训练成本极高 |
| 图像理解能力 | 具备详细描述、问题解决等能力 | 多模态能力更全面 |
| 使用门槛 | 在线演示免费体验,可本地部署 | 需订阅付费 |
应用场景
MiniGPT-4 可应用于多个领域:在教育场景中,教师可以用它解释科学图片、辅助艺术鉴赏;在内容创作领域,创作者可借助它根据照片生成诗歌、故事和广告文案;在智能家居与园艺场景中,用户可上传植物照片获取养护建议;在电商与营销场景中,商家可为商品图片自动生成宣传文案;在开发场景中,研究者可基于开源代码探索多模态模型的微调与部署。此外,MiniGPT-4 也适合作为多模态大模型的教学案例,帮助学习者理解视觉编码器与大语言模型的对齐原理。
总结
作为一款开源的多模态视觉语言模型,MiniGPT-4 以极低的训练成本实现了接近 GPT-4 的图像理解与对话能力,为学术研究、产品原型开发和普通用户体验多模态 AI 提供了高性价比的选择。尽管在代码生成等任务上仍有局限,但其开源特性和高效架构使其成为多模态 AI 领域的重要参考项目。
核心功能
优缺点分析
适用人群
常见问题


