
详细介绍
工具简介
Meta ImageBind 是 Meta 公司(原 Facebook)于 2023 年 5 月发布的一款开源人工智能研究模型,其核心使命是探索多模态数据的统一表征学习。与市面上常见的单一模态生成工具不同,ImageBind 的目标是让机器像人类一样,同时、全面、直接地从多种不同形式的信息中学习。它能够将六种类型的数据流——视觉(图像与视频)、文本、音频、深度信息、热力(红外图像)以及由惯性测量单元(IMU)产生的运动读数——整合到同一个多维索引空间中,也就是人工智能领域所说的“嵌入空间”。这一研究项目虽然尚未直接面向消费者提供商业化产品,但它展示了未来生成式人工智能系统创造沉浸式、多感官体验的巨大可能性。
从技术发展脉络来看,近年来生成式 AI 的爆发很大程度上依赖于跨模态对齐技术。例如 DALL-E、Stable Diffusion、Midjourney 等图像生成器,本质上都是在训练阶段将文本描述与视觉数据建立关联,从而能够根据文字提示生成图像。ImageBind 将这一思路推向了新的高度:它不再局限于文本与图像两种模态,而是首次尝试将六种截然不同的数据形式绑定在同一个语义空间中。Meta 在官方博客中指出,这项研究“让机器更接近于人类同时、全面、直接地从多种不同信息形式中学习的能力”,并认为未来模型还可以继续接入触觉、语音、气味乃至大脑功能磁共振成像信号等更多感官输入流。
值得注意的是,Meta 选择将 ImageBind 的底层模型完全开源,这在当时人工智能领域日益封闭的竞争格局中显得尤为引人注目。其竞争对手 OpenAI 和谷歌在模型开放程度上趋于保守,而 Meta 通过开源代码、论文和演示页面,邀请全球研究者共同验证和拓展这一多模态绑定框架。对于学术界和产业界而言,ImageBind 不仅是一个技术演示,更是一个可复现、可扩展的研究基座。
主要功能
跨模态检索与匹配
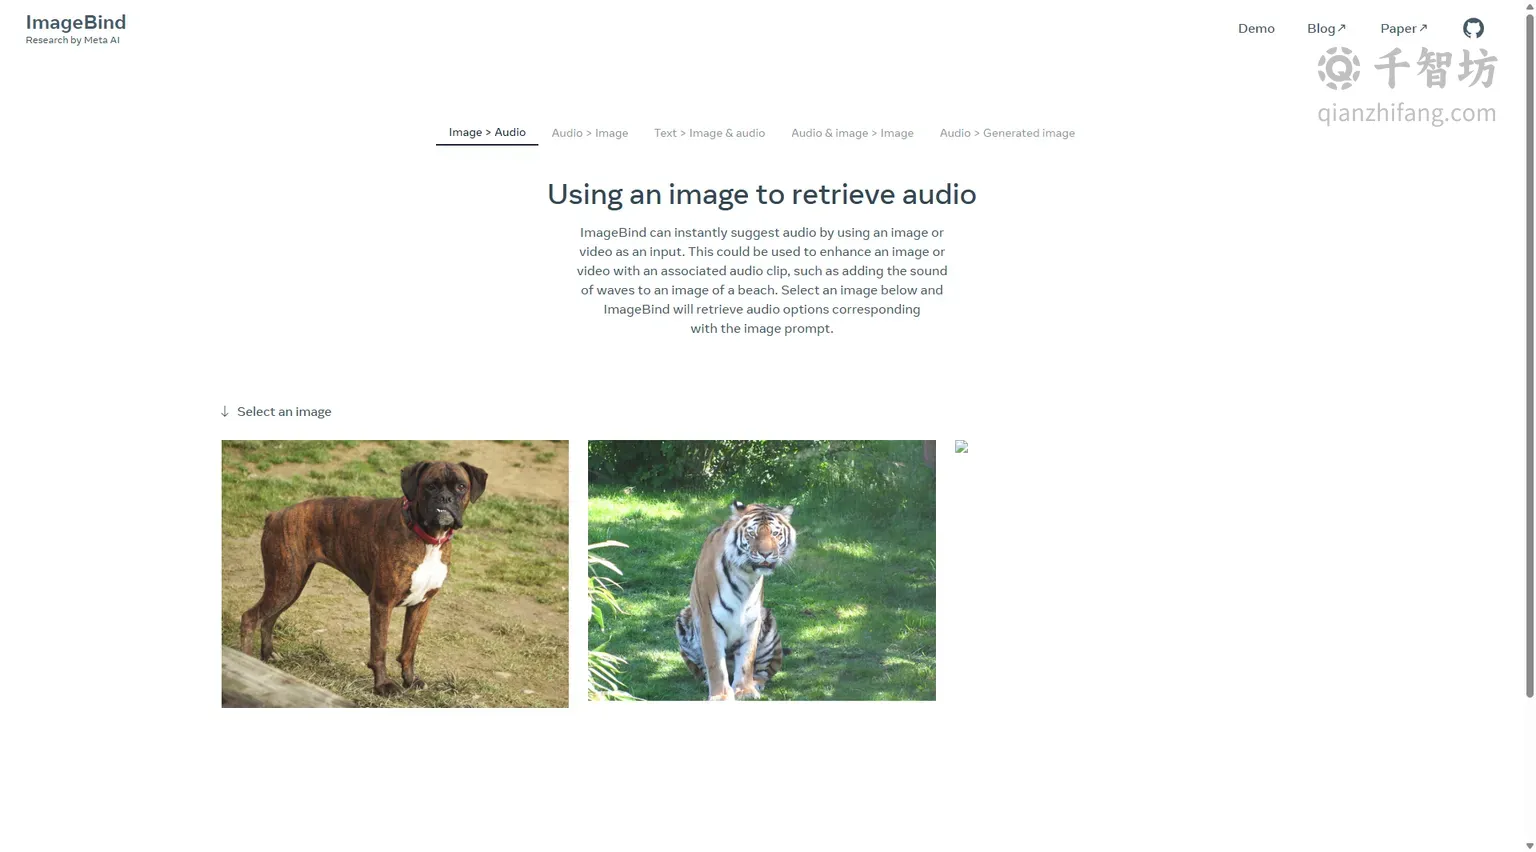
ImageBind 最直观的能力是跨模态检索。在官方演示页面中,用户可以选择一张图片,模型会即时推荐与该图像语义相匹配的音频选项。例如,选择一张海滩照片,系统能够检索出海浪声等与画面氛围一致的音频片段;选择一张狗的照片,则可能匹配到犬吠或相关环境音。这种“以图搜音”的能力无需额外的文本描述,完全依赖模型在嵌入空间中对视觉与音频语义的对齐理解。反过来,音频也可以作为输入来检索图像,文本则可以同时检索图像与音频的组合结果,形成灵活的多向检索链路。
多模态嵌入空间构建
ImageBind 的技术核心是构建一个统一的嵌入空间,将六种模态的数据映射到同一向量表示体系中。这意味着不同模态的数据在语义相近时,其向量距离也会更近。该模型并非为每一种模态单独训练一个编码器再拼接,而是通过图像作为“桥梁”模态,利用图像与文本、音频、深度、热力、IMU 数据之间的自然配对关系,将其他模态对齐到图像嵌入空间。这种设计使得模型即使在缺乏某些模态配对数据的情况下,也能实现跨模态的语义关联,为后续的多模态生成与理解任务奠定基础。
音频生成与图像增强
基于跨模态对齐能力,ImageBind 可以用于为图像或视频自动匹配合适的音频片段,从而增强内容的沉浸感。例如,为一段无声的风景视频配上风声、鸟鸣或水流声,为一张城市街景图配上交通噪声。这一功能在视频后期制作、游戏场景构建、虚拟现实内容开发等场景中具有潜在应用价值。演示页面中提供的“Audio & image > Image”和“Audio > Generated image”等示例,进一步展示了模型在音频与图像联合条件下进行内容生成的可能性。
多模态组合查询
ImageBind 支持将多种模态组合作为查询条件。例如,用户可以同时提供一张图像和一段音频,让模型检索或生成与两者语义都相符的新图像。这种组合查询能力打破了传统单模态检索的局限,使得搜索和生成过程更加贴近人类的多感官认知方式。在演示中,模型展示了“Text > Image & audio”以及“Audio & image > Image”等任务形式,体现了嵌入空间在多模态联合推理上的灵活性。
开源研究与可扩展架构
Meta 不仅发布了 ImageBind 的研究论文,还公开了 GitHub 代码仓库和模型权重,供研究社区下载使用。开发者可以基于现有框架尝试接入新的模态数据,或针对特定下游任务进行微调。官方论文详细阐述了模型架构、训练策略和评估方法,为后续研究提供了完整的技术参考。这种开源策略降低了多模态 AI 研究的门槛,也使得 ImageBind 成为许多学术论文和工程项目的基础组件。
使用方法
在线演示体验
普通用户可以通过 Meta 官方提供的演示页面(imagebind.metademolab.com/demo)直接体验跨模态检索功能。在演示界面中,用户从预设图片中选择一张,模型便会展示与之匹配的音频结果;页面还提供了音频检索图像、文本检索图像与音频等不同任务标签,方便用户直观感受多模态对齐的效果。该演示无需注册账号,也无需付费,适合快速了解模型能力。
开发者接入
对于研究人员和开发者,使用 ImageBind 的完整路径包括:访问官方博客了解研究背景,下载论文掌握技术细节,从 GitHub 获取开源代码和预训练模型,然后在本地或云端环境中进行推理和微调。GitHub 仓库提供了环境配置说明和示例脚本,开发者可以按照文档加载模型、输入不同模态数据并提取嵌入向量,进而构建自己的跨模态应用。
产品优势
- 模态覆盖广泛:ImageBind 是较早将六种模态统一到同一嵌入空间的开源模型,涵盖视觉、文本、音频、深度、热力和运动读数,覆盖面远超同期多数多模态模型。
- 开源开放:代码、论文和模型权重全部公开,研究者和开发者可以自由复现、修改和扩展,有利于技术民主化和社区创新。
- 零样本跨模态能力:借助图像作为桥梁模态,模型在部分模态配对数据稀缺的情况下仍能实现跨模态检索,展现出较强的泛化潜力。
- 面向未来感官计算:其架构设计预留了接入更多感官模态的空间,为虚拟现实、沉浸式内容生成等前沿方向提供了研究基础。
应用场景
- 学术研究:作为多模态表征学习的基准模型,用于探索跨模态对齐、嵌入空间几何性质等课题。
- 内容创作辅助:为图像和视频自动匹配环境音效,提升影视、游戏、短视频内容的沉浸感。
- 虚拟现实与元宇宙:未来可结合 IMU 运动数据与视听内容,构建多感官虚拟环境,例如模拟海上航行时的视觉、听觉与甲板晃动感。
- 智能检索系统:构建以图搜音、以音搜图、文本联合检索等多模态搜索引擎。
- 无障碍技术:为视障或听障用户提供跨模态的信息转换与提示服务。
核心功能
优缺点分析
适用人群
常见问题


