
Makefun

Makefun

免费增值Web
访问官网

Makefun是集成Seedream、FLUX、Veo、Kling等前沿模型的AI创作平台,支持文生图、视频生成、换脸与数字人视频制作。

Makefun访问官网

详细介绍

工具简介

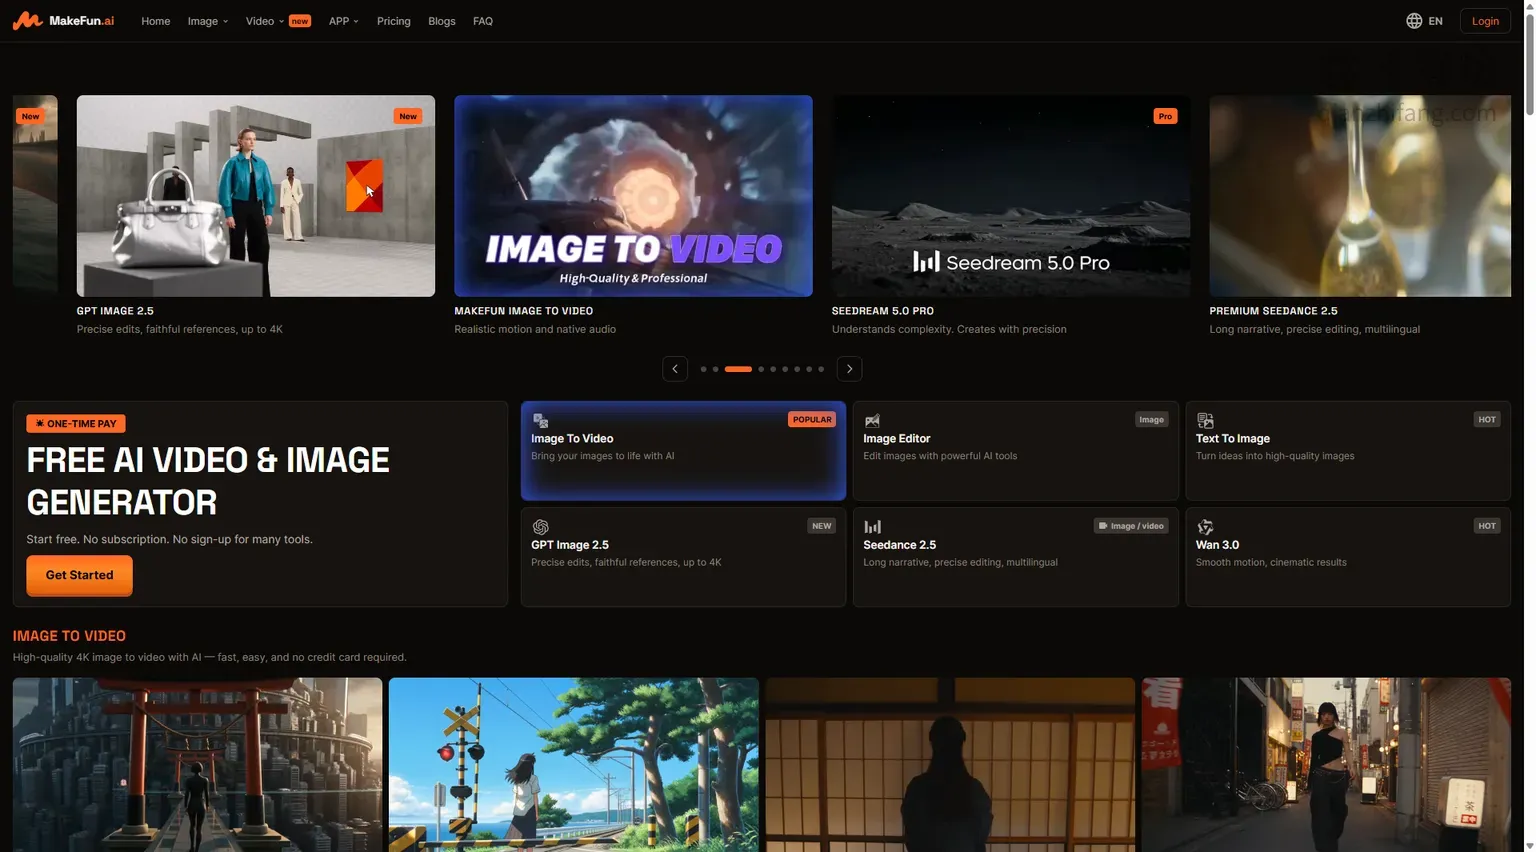
Makefun(官网 makefun.ai)是一款面向创作者的综合性AI图像与视频生成平台。它并非只依赖单一模型,而是将当前业内多款主流生成模型聚合到同一个工作台中,用户无需在多个网站之间来回切换,即可在同一个界面内调用不同厂商的生成能力。根据官网导航与百度百科的信息,Makefun 集成了包括 Wan 2.6(阿里)、Veo 3.1(Google)、Nano Banana Pro、Seedream 5.5、GPT Image 2.5、FLUX.2、Kling 4.0、Sora 2、Seedance 2.5 等在内的前沿生成模型,图像输出最高支持 4K 分辨率,视频生成则覆盖从几秒短片到 30 秒长镜头的多种规格。

从产品定位看,Makefun 同时承担了「AI 图像工作室」和「AI 视频工作室」两个角色。图像侧提供文生图、图生图、换脸、换装、头像替换、无损放大等能力;视频侧则覆盖文生视频、图生视频、关键帧控制、角色动画、对口型、说话照片等玩法。此外,平台还提供AI 数字人(AI Avatar)与声音克隆功能,可用于制作口播视频、多说话人对话视频等营销与教学内容。官网中文版将其描述为「免费 AI 数字人音视频平台」,强调图片转视频、AI 换脸、声音克隆、数字人分身等一站式能力。


主要功能

图像生成与编辑

Makefun 的图像模块覆盖了从「生成」到「精修」的完整链路。文生图功能允许用户用自然语言描述画面,由 Seedream、FLUX、GPT Image、Z-Image 等模型生成高质量图片;其中 Seedream 5.5 主打稳定的多轮编辑能力,官方标注最多可支持 100 层图层式修改,适合需要反复调整细节的创作场景;GPT Image 2.5 强调精准编辑与参考图还原,输出上限达 4K;FLUX.2 则偏向精确、高画质的图像生成。除纯生成外,平台还提供换脸(Face Swap,支持照片与视频一键替换)、换装(Cloth Swap)、头像替换(Head Swap)等实用工具,以及可将图片放大并锐化至 16K 的 Upscale 功能。

视频生成与动态化

视频是 Makefun 的另一条主线。平台提供文生视频与图生视频两种入口,其中图生视频被标注为「免费且无内容审查限制」,对希望快速把静态图变成动态短片的用户较为友好。模型层面,Kling 4.0 支持关键帧控制与稳定角色,最长可生成 30 秒视频;Veo 3.1 代表生成式视频的新一代能力;MiniMax H3 支持原生声音的视频生成;Wan 3.0 / Wan 2.6 系列主打电影感画面;Sora 2 为 OpenAI 的新一代视频模型;Seedance 2.5 / 2.0 定位专业多模态视频创作。此外还有 Character Animation(V2V)AI 舞蹈生成、Character Swap(Viggle)角色替换并保留动作与身份一致性、Talking Video 对口型、Talking Photo 让照片开口说话等细分玩法。

数字人与声音

在数字人方向,Makefun 提供 AI Avatar 功能,可生成逼真的多说话人口播视频;Product Avatar 能让虚拟模特手持用户的产品出镜,适合电商展示;Voice Clone 则可生成逼真的声音复刻。结合文字或上传音频,用户可以选择数字人形象、声音、背景、画面比例与字幕,在线生成可复用的 talking avatar 视频。


使用方法

Makefun 以 Web 端为主要使用形态,整体流程较为直观:

  1. 选择功能入口:在首页按「Image」「Video」「APP」等分类进入对应工具,例如文生图、图生视频、换脸或数字人视频。
  2. 选择模型:同一功能下往往提供多个模型可选,用户可根据画质、速度、时长或编辑精度需求挑选,例如图像选 Seedream 5.5 做多轮编辑,视频选 Kling 4.0 做关键帧控制。
  3. 输入提示词或素材:填写画面描述,或上传参考图、视频、音频;数字人视频还可选择形象、声音与字幕样式。
  4. 生成与调整:提交后等待生成结果,部分模型支持多轮编辑与局部重绘,可反复微调。
  5. 下载与复用:结果可下载保存,数字人模板可复用,便于批量产出内容。

需要注意的是,官网提示结果数据仅保留有限时间,用户应及时保存生成内容。


产品优势

对比维度Makefun 的表现
模型覆盖聚合 Seedream、FLUX、GPT Image、Veo、Kling、Sora、Wan、Seedance 等多家模型,一个平台完成多模型调用
输出规格图像最高 4K,放大可达 16K;视频最长 30 秒,部分模型支持原生音频
功能广度覆盖文生图、图生图、换脸换装、文生视频、图生视频、数字人、声音克隆
上手门槛Web 端操作,中文界面,提供免费额度入口,适合非专业用户

总体而言,Makefun 的核心竞争力在于「聚合」与「一站式」:用户不必分别注册多个模型厂商的服务,就能在同一工作流中完成从图片到视频、从换脸到数字人的多种任务,对于内容创作者和小型团队而言可以显著降低工具切换成本。


应用场景

  • 社交媒体内容创作:快速生成配图、短视频、动态封面,适配不同平台比例。
  • 电商与产品展示:用 Product Avatar 让虚拟模特展示商品,用换装功能测试服装效果。
  • 营销口播视频:通过 AI Avatar 与声音克隆批量制作多语言、多形象的口播广告。
  • 创意与娱乐:换脸、AI 舞蹈、说话照片等玩法适合短视频娱乐内容。
  • 设计与素材生产:用多轮编辑与 4K/16K 放大处理海报、插画等设计素材。

核心功能

1
多模型文生图与图像编辑
集成 Seedream 5.5、GPT Image 2.5、FLUX.2、Z-Image 等模型,支持文生图与多轮精修。Seedream 5.5 最多支持 100 层图层式编辑,GPT Image 2.5 可输出 4K 并精准还原参考图,适合需要反复打磨的视觉创作。
2
AI 换脸、换装与头像替换
提供 Face Swap、Cloth Swap、Head Swap 三类工具。换脸支持照片与视频一键替换,换装可在任意图片中更改服装,头像替换则保留本人特征更换造型,适合娱乐内容与电商试穿场景。
3
文生视频与图生视频
覆盖 Veo 3.1、Kling 4.0、Sora 2、Wan 3.0、Seedance 2.5 等视频模型。Kling 4.0 支持关键帧控制与稳定角色,最长 30 秒;图生视频入口免费且限制较少,可快速把静态图转为动态短片。
4
AI 数字人与口播视频
AI Avatar 可生成逼真的多说话人视频,用户选择数字人形象、声音、背景、比例与字幕,输入文字或上传音频即可生成可复用的 talking avatar 口播视频,适合营销与教学。
5
声音克隆与对口型
Voice Clone 生成逼真声音复刻,Talking Video 将视频与音频合成精准唇形同步,Talking Photo 让静态照片开口说话,可用于虚拟主播、配音与趣味内容制作。
6
角色动画与动作迁移
Character Animation(V2V)可将动作迁移到角色上生成 AI 舞蹈视频;Character Swap(Viggle)在替换角色的同时保留原始动作、身份与一致性,适合短视频娱乐与二创。
7
图像无损放大
Upscale 功能可将图片放大并锐化至最高 16K,在提升分辨率的同时尽量保持细节清晰,适合印刷、大屏展示与高清素材输出。
8
产品数字人展示
Product Avatar 基于 Flux Kontext 等能力,生成逼真虚拟模特手持用户产品的展示画面,无需真实拍摄即可产出商品图与展示视频,降低电商视觉制作成本。

优缺点分析

优点
+模型聚合度高,一个平台即可调用 Seedream、FLUX、Veo、Kling、Sora、Wan 等多家主流模型,减少多平台切换与重复注册成本
+功能覆盖全面,从文生图、换脸换装到文生视频、数字人、声音克隆形成完整创作链路,图像最高 4K、放大可达 16K
+提供免费入口与中文界面,Web 端即开即用,对非专业用户友好,适合快速试错和批量内容生产
缺点
-官网未明确公示价格体系与各模型的额度消耗规则,用户在实际使用前较难预估成本
-生成结果数据仅保留有限时间,若未及时下载可能丢失,对需要长期存档的用户不够便利
-部分高级能力(如 30 秒长视频、4K 输出)依赖特定模型,不同模型之间的效果与限制差异较大,需要用户自行摸索选择

适用人群

社交媒体与短视频内容创作者,需要快速产出配图、短片与娱乐化内容电商卖家与品牌营销人员,需要商品展示图、虚拟模特与多语言口播视频中小设计团队与自由设计师,需要多模型对比与高清放大等素材处理能力教育与培训从业者,需要制作数字人讲解视频与口播课程AI 爱好者与尝鲜用户,希望低成本体验多家前沿生成模型

常见问题

Q: Makefun 是免费的吗?
Makefun 官网中文版将其定位为「免费 AI 数字人音视频平台」,并提供免费入口,部分功能如图生视频标注为免费且限制较少。但平台同时集成了大量商用级模型(如 Veo 3.1、Kling 4.0、Sora 2 等),这类高规格生成通常会有额度或付费限制。目前官网未完整公示价格体系,建议在使用具体功能前查看对应页面的额度说明,或先以免费额度体验再决定是否深入使用。
Q: Makefun 支持哪些生成模型?
根据官网与百度百科信息,Makefun 集成了多家厂商的模型。图像侧包括 Seedream 5.5、Seedream 5.0 Pro、GPT Image 2.5、GPT Image 1.5、FLUX.2、Nano Banana Pro、Z-Image 等;视频侧包括 Kling 4.0、Veo 3.1、Sora 2、Wan 3.0、Wan 2.6、MiniMax H3、Seedance 2.5、Seedance 2.0、Grok Imagine 等。不同模型在画质、时长、音频支持和编辑能力上各有侧重,用户可按需选择。
Q: 生成的内容可以商用吗?
能否商用取决于具体模型的授权条款以及用户所在地区的法律规定,Makefun 作为聚合平台本身并不统一授予商用权利。部分第三方模型对商业用途有单独限制,涉及人物肖像的换脸、数字人功能还需注意肖像权与人格权问题。建议在商业使用前查阅对应模型的服务条款,并避免将换脸、声音克隆用于未经授权的真实人物,以降低法律风险。
Q: Makefun 有手机 App 吗?
目前 Makefun 主要以 Web 端形式提供服务,官网导航中的「APP」分类实际指向的是平台内的数字人、放大、产品数字人等应用功能,而非独立的移动客户端。用户可通过浏览器在电脑或手机端访问 makefun.ai 使用相关功能。若后续推出独立 App,通常会在官网首页或关于页面公布,建议以官网信息为准。
Q: 生成的图片和视频会保存多久?
官网在生成界面提示「结果数据仅保留有限时间」,并未给出统一的长期存储承诺。这意味着用户生成的内容可能在一段时间后被清理,若未及时下载将无法找回。对于重要素材,建议在生成后立即下载到本地或云端备份,尤其是需要反复编辑的项目,最好保留原始提示词与参数,以便后续重新生成。