
详细介绍
工具简介
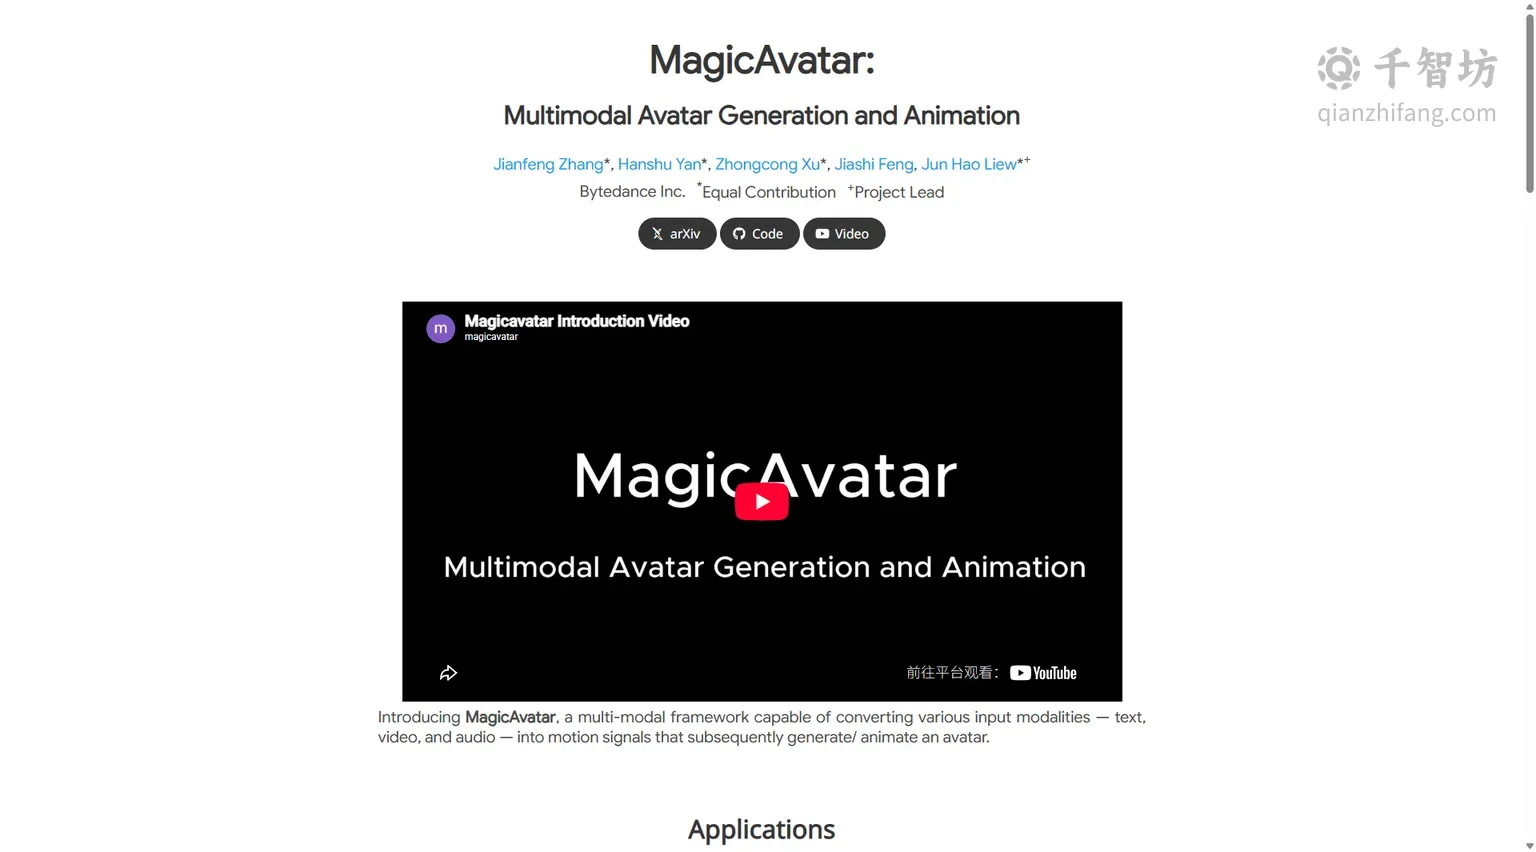
MagicAvatar 是由字节跳动(Bytedance Inc.)研发并推出的一款多模态虚拟人物生成与动画框架。它的核心能力在于将多种不同形态的输入信号——包括文本、视频和音频——统一转化为可驱动的动作信号,进而生成或动画化一个虚拟人物形象。该项目由 Jianfeng Zhang、Hanshu Yan、Zhongcong Xu、Jiashi Feng、Jun Hao Liew 等研究者共同完成,相关论文已发布在 arXiv(编号 2308.14748),并在 GitHub 上开源了代码,同时在 YouTube 上提供了演示视频,是一个兼具学术深度与工程落地潜力的 AI 视频生成工具。
与传统“直接从多模态输入生成视频”的思路不同,MagicAvatar 的独特之处在于将整个视频生成过程明确拆解为两个阶段。第一阶段负责把文本、视频、语音等输入转换为表示运动的信号,例如人体姿态、深度信息、DensePose 等;第二阶段则将第一阶段得到的运动信号与外观描述一起输入模型,最终渲染生成视频。这种“先动作、后外观”的解耦设计,使得生成结果在动作合理性和视觉一致性上更具可控性,也让同一套动作信号可以复用到不同的角色外观上。
主要功能
文本引导的虚拟人物生成
用户只需输入一句简单的文本提示,MagicAvatar 就能创建对应的虚拟人物并赋予其动作。官方展示的案例非常丰富,例如输入“一个在火山里踢踏舞的宇航员”“一个在燃烧建筑里打沙袋的勇敢消防员”“一个在海底练习瑜伽姿势的女宇航员”“一群在火山里跳舞的 K-pop 明星”“一个在山脚下走太空步的粗犷登山者”“一个在宏伟舞厅里交叉双臂的女舞者”“一个在宁静花园景观中练习瑜伽的练习者”“一群在公园里跳舞的孩子”“一个在海底倒立的宇航员”“一个在篮球场上走太空步的篮球运动员”“一个在军事基地敬礼的士兵”等提示词,系统都能生成相应的动作序列与视频画面。文本提示通常包含角色身份、动作类型和场景环境三个要素,组合方式灵活。
视频引导的虚拟人物生成
除了文本,MagicAvatar 还支持以源视频作为输入。用户提供一段源视频后,AI 会提取其中的动作信息,并创建一个跟随给定动作的新虚拟形象。官网展示的案例包括:让“穿红夹克的男孩奔跑”的动作驱动新角色、让“玩积木的孩子”的动作被复现、让“在水下跳舞的男人”的动作迁移到新形象、让“在雨中路上行走的黄衣女孩”的动作被跟随、让“在床上跳舞的绿衣婴儿”的动作被重现等。这一功能对于需要复用现有舞蹈、运动或表演动作的创作者尤为实用。
音频驱动的动画化
作为多模态框架,MagicAvatar 同样接受音频输入,并将其转化为动作信号来驱动虚拟人物。这意味着语音、音乐等声音内容可以成为角色动作的来源,为虚拟主播、音乐视频、口播动画等场景提供了新的创作路径。文本、视频、音频三种模态的统一处理,是 MagicAvatar 区别于单一模态工具的重要特征。
两阶段生成架构
MagicAvatar 将生成流程拆分为“运动信号生成”和“视频渲染”两个阶段。第一阶段把多模态输入转成人体姿态、深度信息、DensePose 等运动表示;第二阶段结合外观描述生成最终视频。这种架构让动作与外观相互解耦,既提升了动作的准确性,也方便用户对角色外观和动作分别进行调整。
多角色与复杂场景支持
从官方示例可以看到,MagicAvatar 不仅能生成单人角色,还支持多角色场景,例如“一群 K-pop 明星在火山里跳舞”“四个女孩穿着蓝色套装在夜间跳舞”“三个女孩在草地上跳舞”“两个人在火焰中练柔道”等。这表明其在多人动作协调和复杂场景构建上具备一定能力。
使用方法
MagicAvatar 目前主要以研究项目和开源框架的形式提供,官网(magic-avatar.github.io)展示了论文、代码仓库和演示视频的入口。典型的使用流程如下:
- 准备输入:根据需求选择文本提示、源视频或音频作为输入。文本提示建议包含角色、动作、场景三要素。
- 运动信号生成:系统第一阶段将输入转化为人体姿态、深度信息、DensePose 等运动表示。
- 外观与渲染:第二阶段将运动信号与外观描述结合,输入模型生成最终视频。
- 结果调整:根据生成效果调整提示词或源视频,重新生成以获得更理想的动作与画面。
对于希望深入使用的开发者,可参考 GitHub 上的开源代码进行本地部署和二次开发;对于普通用户,则可通过官网提供的演示视频了解其能力边界。
产品优势
| 对比维度 | MagicAvatar 的特点 |
|---|---|
| 输入模态 | 同时支持文本、视频、音频三种输入,覆盖面广 |
| 生成架构 | 两阶段解耦设计,动作与外观分离,可控性更强 |
| 动作质量 | 基于人体姿态、深度、DensePose 等运动信号,动作更合理 |
| 多角色支持 | 可生成多人协同的复杂场景 |
| 开放性 | 论文、代码、演示视频均公开,便于研究与二次开发 |
总体而言,MagicAvatar 凭借多模态统一输入、两阶段生成架构和开源开放的特性,在 AI 虚拟人物生成与动画领域形成了自己的差异化优势,尤其适合需要精确控制动作、复用动作素材以及进行学术研究或二次开发的用户群体。
核心功能
优缺点分析
适用人群
常见问题


