详细介绍
工具简介
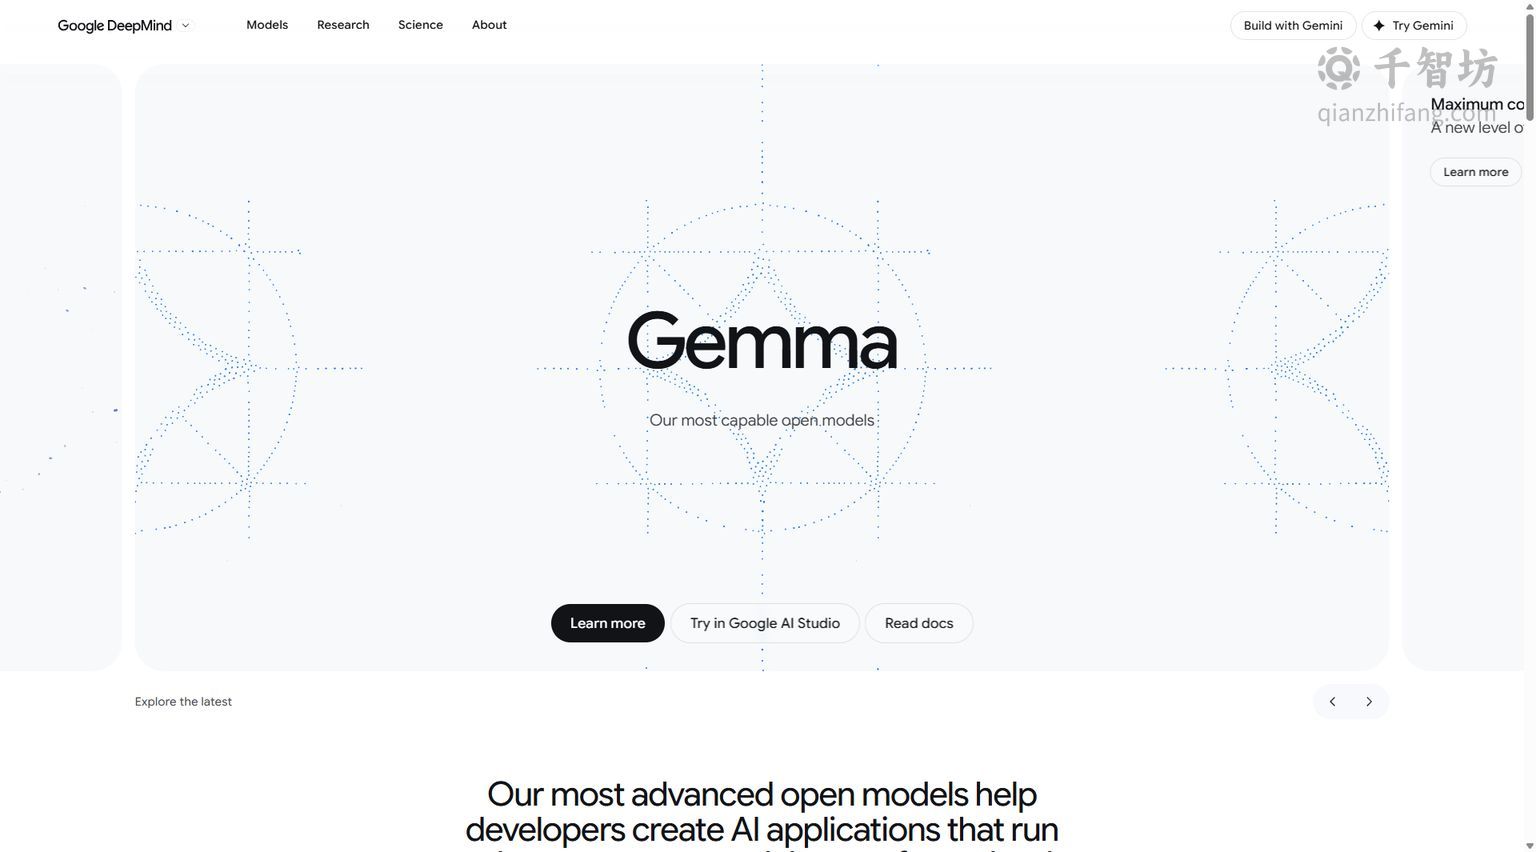
Gemma 是 Google DeepMind 推出的一系列轻量级、开源权重大型语言模型(LLM)。它并非凭空诞生,而是基于与 Google 旗舰级模型 Gemini 同源的技术构建而成。这意味着开发者与研究人员能够在自己的项目中,以更低的门槛获得接近前沿水平的 AI 能力。Gemma 的发布标志着 Google 在开源 AI 模型领域的重要布局,旨在推动 AI 技术的普及与创新。
从最初的 Gemma 系列到最新的 Gemma 4,该模型家族不断进化。根据公开信息,Gemma 4 于 2026 年 4 月发布,是一款专为高级推理和智能体工作流设计的开放模型。它以约 30B 的参数规模,在性能上逼近其他头部开源模型,展现了极高的参数效率。尤其值得一提的是,Gemma 4 的 26B MoE(混合专家)版本在推理时仅激活 3.8B 参数,却能实现令人瞩目的效果,这为在资源受限环境中部署强大 AI 提供了新的可能。
Gemma 的核心价值在于其“开放”与“轻量”的特性。与需要庞大算力集群才能运行的超大模型不同,Gemma 系列模型经过优化,可以在单 GPU 或 TPU 甚至消费级硬件上运行。这使得个人开发者、初创公司以及学术机构都能轻松上手,进行模型微调、应用开发或学术研究。无论是构建智能聊天机器人、代码辅助工具,还是进行复杂的文本分析与推理任务,Gemma 都提供了一个强大且灵活的基础。
主要功能
1. 开源权重大型语言模型
Gemma 提供预训练和指令微调两种版本的模型权重,用户可以直接下载并部署。这些模型基于 Gemini 的研究和技术,具备强大的自然语言理解和生成能力。开源权重意味着用户可以完全掌控模型,进行本地化部署,无需依赖外部 API,从而保障数据隐私和安全。
2. 高级推理与智能体工作流
最新的 Gemma 4 系列特别强调了高级推理和智能体(Agentic)工作流能力。模型能够处理多步骤的逻辑推理任务,理解复杂指令,并能在智能体框架中自主调用工具、规划任务,完成诸如自动研究、代码生成与调试等高级操作。
3. 多种参数规模与架构
Gemma 家族提供不同参数规模的模型,以满足不同场景的需求。例如,有适用于轻量级任务的 2B 小模型,也有性能更强大的 7B、9B 模型,以及最新的 31B 稠密模型和 26B MoE 模型。MoE 架构通过仅激活部分参数,在保持高性能的同时大幅降低推理成本。
4. 跨平台部署与优化
Gemma 模型针对多种运行环境进行了优化。它支持在 Google Cloud 的 Vertex AI 上部署,也支持在本地环境通过 Keras、PyTorch、JAX 等主流框架运行。此外,Gemma 还针对 NVIDIA GPU 和 Google TPU 进行了优化,并提供了在笔记本电脑、移动设备上运行的量化版本。
5. 易于微调与定制
开发者可以利用自己的数据集对 Gemma 进行微调,以适应特定领域或任务。Google 提供了详细的微调指南和工具,如 LoRA(低秩适应)等高效微调技术,使得在有限的计算资源下也能完成模型定制。
6. 负责任的 AI 开发
Google 在发布 Gemma 时,同步提供了模型卡、负责任的生成式 AI 工具包等资源,帮助开发者理解和减轻模型可能带来的偏见、安全等风险,促进 AI 的负责任使用。
使用方法
获取模型
用户可以通过 Kaggle 模型、Hugging Face、GitHub 等平台下载 Gemma 的模型权重。Google 提供了详细的下载和设置指南。
运行环境准备
根据模型大小和任务需求,选择合适的硬件。小型模型可在 CPU 或消费级 GPU 上运行,大型模型则建议使用具有足够显存的 GPU 或 TPU。需要安装相应的深度学习框架,如 PyTorch、JAX 或 TensorFlow。
推理与部署
使用官方提供的示例代码或社区工具,加载模型并进行推理。对于生产环境,可以考虑使用 Vertex AI、Ollama、LM Studio 等工具进行便捷部署和管理。
微调
参照官方微调教程,准备特定领域的数据集,使用 LoRA 或全参数微调方法对模型进行训练,以提升在特定任务上的表现。
产品优势
| 优势 | 说明 |
|---|---|
| 开源免费 | 模型权重开放,可自由下载、使用和修改,无 API 调用费用。 |
| 性能强劲 | 基于 Gemini 技术,以较小参数规模实现接近头部模型的性能。 |
| 部署灵活 | 支持云端、本地、边缘设备等多种部署方式,适应不同场景。 |
| 生态完善 | 与主流框架和平台集成,拥有活跃的社区支持和丰富的学习资源。 |
应用场景
- 智能对话系统:构建企业客服、个人助理等聊天机器人。
- 内容创作辅助:帮助撰写文章、生成创意文案、翻译文本。
- 代码生成与辅助:作为编程助手,提供代码补全、解释和调试建议。
- 学术研究与教育:用于自然语言处理研究、AI 教学和实验。
- 智能体开发:作为智能体核心,驱动自动化任务和复杂工作流。
核心功能
优缺点分析
适用人群
常见问题


