
详细介绍
工具简介
飞桨(PaddlePaddle)是百度推出的开源深度学习平台,定位为面向产业实践与前沿研究的全流程AI开发基础设施。它并不只是一个单一的模型训练框架,而是从底层算子、编译器、分布式训练,到上层开发套件、模型库、在线社区与算力服务的完整技术栈。对于想要系统学习深度学习、快速搭建AI应用,或者在企业环境中落地大规模模型训练的团队而言,飞桨提供了一条从入门到生产的完整路径。
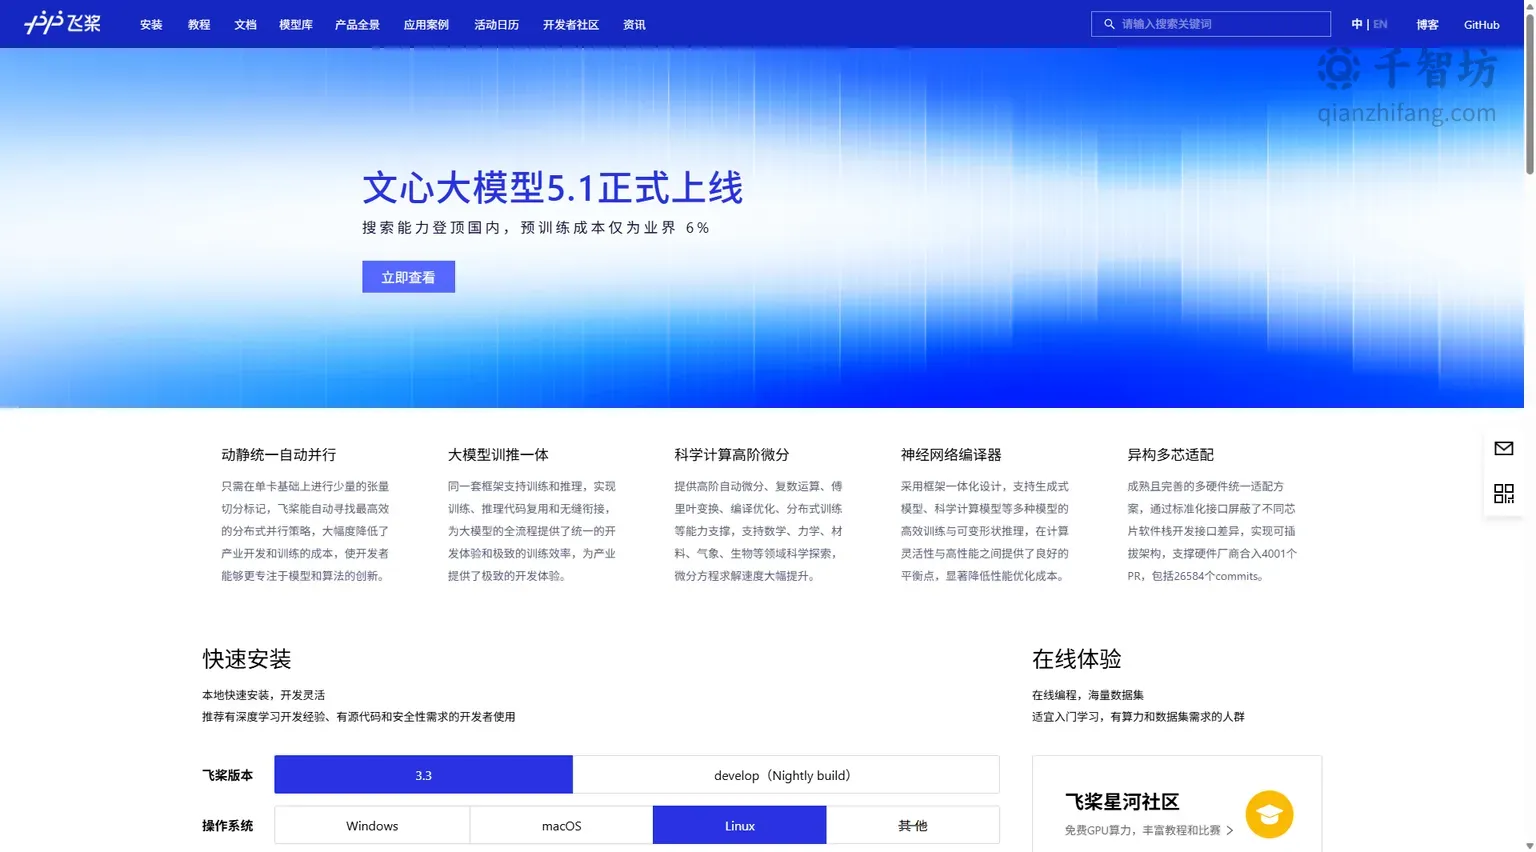
飞桨的核心设计理念可以概括为“动静统一、训推一体、软硬协同”。在框架层面,它同时支持动态图与静态图的开发体验,开发者可以用接近Python原生编程的方式调试模型,再通过自动并行机制将单卡代码平滑扩展到多卡、多机集群。在部署层面,同一套框架覆盖训练与推理,避免训练代码与推理代码重复开发,显著降低工程维护成本。在硬件层面,飞桨通过标准化接口屏蔽了不同芯片软件栈的差异,支持英伟达GPU、昆仑芯、海光、寒武纪、昇腾、燧原、太初、沐曦、天数智芯以及CPU等多种计算平台,形成了可插拔的异构适配方案。
主要功能
动静统一的自动并行训练
飞桨的自动并行能力是其面向大模型时代的重要特性。开发者只需在单卡代码的基础上进行少量的张量切分标记,框架就能自动搜索并生成高效的分布式并行策略,包括数据并行、张量并行、流水线并行等多种组合方式。这意味着团队不需要投入大量人力去手写复杂的并行逻辑,就能把模型规模扩展到数百亿甚至更大参数级别,从而把精力集中在模型结构和算法创新上,而不是分布式工程的细节里。
大模型训推一体
飞桨强调训练与推理使用同一套框架,训练完成的模型可以直接进入推理流程,代码复用度高,衔接过程无需额外的格式转换或框架迁移。这种一体化设计为大模型的全流程开发提供了统一的开发体验,减少了训练环境与部署环境不一致带来的问题,也提升了从实验到上线的整体效率。
科学计算与高阶微分
除了传统的深度学习任务,飞桨还面向科学计算场景提供了高阶自动微分、复数运算、傅里叶变换、编译优化和分布式训练等能力。这些能力可以支撑数学、力学、材料、气象、生物等领域的科学探索,尤其在微分方程求解等任务上能够大幅提升计算速度。对于从事AI for Science研究的团队来说,飞桨提供了一个将深度学习与数值计算结合的底层平台。
神经网络编译器
飞桨内置的神经网络编译器采用框架一体化设计,支持生成式模型、科学计算模型等多种模型的高效训练与可变形状推理。它在计算灵活性与高性能之间寻找平衡点,能够显著降低性能优化的人力成本,让模型在不同硬件和不同输入形状下都能获得较好的运行效率。
异构多芯适配
飞桨建立了一套成熟且完善的多硬件统一适配方案,通过标准化接口屏蔽不同芯片软件栈的开发接口差异,形成可插拔架构。根据官网信息,该方案已支撑硬件厂商合入4001个PR、包括26584个commits,覆盖英伟达CUDA多个版本、昆仑芯、海光DTK、寒武纪CANN、昇腾NeuWare SDK、燧原TopsRider、太初SDAA、沐曦MACAI、天数智芯以及X86、ArmV8等计算平台。这种开放的适配机制让企业在选择硬件时拥有更大的灵活性。
丰富的开发套件矩阵
飞桨围绕典型任务场景提供了大量开箱即用的开发套件,覆盖自然语言处理、多模态、语音、计算机视觉、文档解析、生物计算和科学计算等方向:
- PaddleNLP:面向大语言模型的开发套件,提供从预训练、微调到推理部署的完整工具链。
- PaddleMIX:多模态大模型开发套件,支持图文理解与生成等多模态任务。
- PaddleSpeech:语音识别与语音合成开发套件,覆盖语音处理的主要环节。
- PaddleOCR:文字识别与文档解析套件,是飞桨生态中应用广泛的热门产品,适用于票据、证件、文档等场景的文字提取。
- PaddleDetection:目标检测开发套件,内置多种检测模型与训练策略。
- PaddleSeg:图像分割开发套件,面向语义分割、交互式分割等任务。
- PaddleX:低代码开发套件,降低模型开发与部署门槛。
- PaddleHelix:生物计算套件,服务药物研发与生命科学场景。
- PaddleScience:科学计算套件,面向物理仿真与方程求解。
- PaddleFormers:Transformer模型库,方便开发者调用和二次开发主流模型结构。
在线社区与算力支持
飞桨星河社区(AI Studio)是在线学习与实训平台,提供在线编程环境、海量数据集以及免费GPU算力,适合入门学习者和有算力、数据需求的开发者。社区内还有丰富的教程、比赛和项目案例,形成了从学习到实践再到交流的闭环。对于本地开发需求较强的用户,飞桨也提供pip、docker、源码编译等多种安装方式,覆盖Windows、macOS、Linux等操作系统。
使用方法
飞桨的使用路径根据用户类型有所不同。对于初学者,推荐直接进入飞桨星河社区,在浏览器中完成在线编程,无需配置本地环境即可运行示例项目,并借助免费算力和数据集完成入门练习。对于有深度学习开发经验、关注源代码与安全性的开发者,可以选择本地安装:先根据操作系统和芯片厂商选择对应的飞桨版本与计算平台,再通过pip或docker快速安装,或使用源码编译获得更高定制能力。安装完成后,开发者可以按照官方教程从张量操作、模型定义、训练循环等基础内容入手,逐步过渡到使用PaddleNLP、PaddleOCR等开发套件完成具体任务。对于企业团队,则可以基于自动并行和训推一体能力,将单卡实验代码扩展到集群训练,并复用同一套框架完成推理部署。
产品优势
| 维度 | 飞桨的能力表现 |
|---|---|
| 分布式训练 | 单卡代码加少量切分标记即可自动寻找高效并行策略,降低产业开发和训练成本 |
| 训练与推理 | 同一套框架支持训练和推理,代码复用、无缝衔接 |
| 科学计算 | 高阶自动微分、复数运算、傅里叶变换等能力支撑多学科科学探索 |
| 硬件适配 | 可插拔架构,屏蔽芯片软件栈差异,支持国内外多种计算平台 |
| 生态套件 | 覆盖NLP、多模态、语音、CV、OCR、生物计算、科学计算等方向 |
此外,飞桨的开源属性和活跃的开发者社区也是其重要优势。开发者可以自由获取源代码、参与社区贡献,硬件厂商也能通过标准化接口接入生态,形成开放协作的技术氛围。文心大模型等百度自有模型能力也与飞桨生态保持联动,为开发者提供从框架到模型的多层次选择。
应用场景
- 产业级模型训练:制造、金融、能源等行业利用飞桨训练和部署视觉检测、文字识别、语音交互等模型。
- 大模型研发:研究团队借助自动并行与训推一体能力开展大语言模型和多模态模型的训练与微调。
- 科学计算研究:高校与科研机构使用高阶微分和科学计算套件进行方程求解、材料模拟、气象预测等探索。
- 教学与实训:教师和学生通过星河社区完成深度学习课程实验与竞赛训练。
- 文档智能化:企业使用PaddleOCR完成票据、合同、证件等文档的结构化信息提取。
核心功能
优缺点分析
适用人群
常见问题


