
详细介绍
工具简介
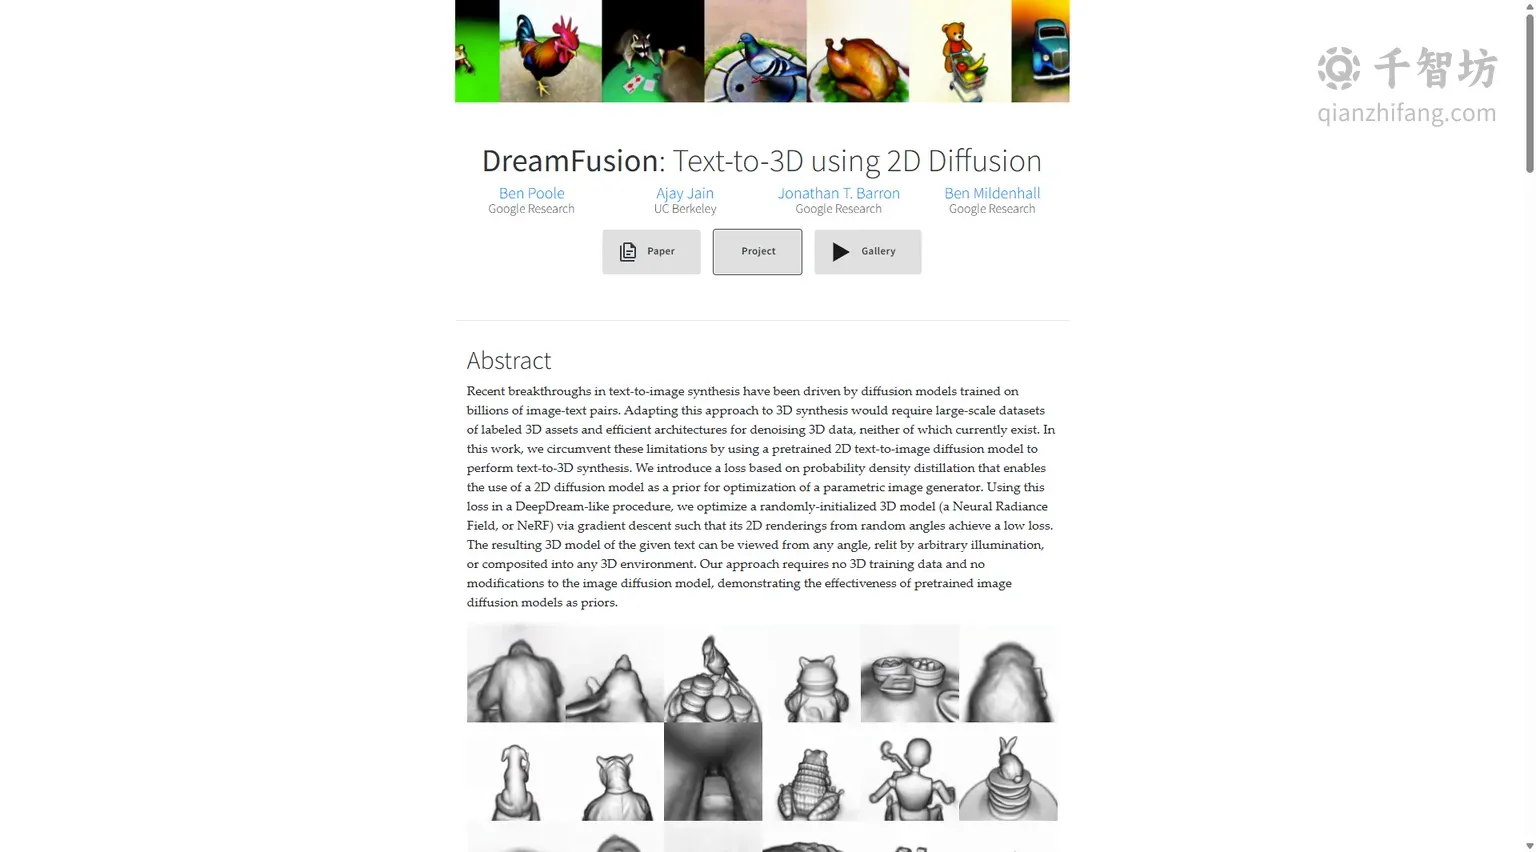
DreamFusion 是由 Google Research 与 UC Berkeley 的研究人员联合开发的一项前沿 AI 技术项目,旨在解决文本到 3D 模型生成这一极具挑战性的任务。该项目最早于 2022 年 9 月发布论文,第一作者为 Ben Poole,合作者包括 Ajay Jain、Jonathan T. Barron 和 Ben Mildenhall。DreamFusion 的核心创新在于:它不需要任何 3D 训练数据,也不需要对现有的 2D 图像扩散模型做任何修改,就能根据一段文字描述生成具有高保真外观、深度和法线信息的 3D 对象。
传统上,将文本到图像的生成能力迁移到 3D 领域面临两大障碍:一是缺乏大规模带标签的 3D 资产数据集,二是缺乏高效的对 3D 数据进行去噪的网络架构。DreamFusion 巧妙地绕过了这两个限制,它利用一个预训练的 2D 文本到图像扩散模型(如 Imagen)作为先验,通过一种基于概率密度蒸馏的损失函数,将 2D 扩散模型转化为优化 3D 模型的“裁判”。具体而言,系统从一个随机初始化的神经辐射场(NeRF)开始,通过类似 DeepDream 的优化过程,不断从随机角度渲染 2D 图像,并计算这些渲染图与文本提示之间的扩散损失,再通过梯度下降更新 NeRF 参数,最终得到一个与文本描述高度吻合的 3D 模型。
生成的 3D 模型可以从任意角度进行查看,支持任意光照条件下的重光照(relighting),还可以导出为网格(mesh)并合成到任何 3D 环境中。DreamFusion 的出现为文本到 3D 生成领域树立了重要的里程碑,其“2D 扩散先验 + NeRF 优化”的范式被后续大量研究所借鉴和发扬。
主要功能
文本到 3D 模型生成
用户只需输入一段自然语言描述,例如“一只穿着毛衣的青蛙”“一个精美的汉堡”“穿着紫色连帽衫的松鼠”等,DreamFusion 就能自动生成对应的 3D 模型。系统对描述的理解能力较强,能够处理包含材质、服饰、动作、场景等多种属性的复杂提示词。官网展示了大量示例,包括“穿着中世纪盔甲的松鼠”“正在读书的松鼠”“骑摩托车的松鼠”“吹萨克斯的松鼠”“切菜的松鼠”等,覆盖了不同动作和装扮的组合,体现了模型对文本语义的细粒度把握能力。
多角度查看与重光照
由于生成的模型以神经辐射场(NeRF)形式表示,DreamFusion 产出的 3D 对象不仅外观逼真,还可以从任意角度进行查看,不会出现传统 2D 生成方法常见的多视角不一致问题。同时,模型支持任意光照条件下的重光照,用户可以调整光源方向、强度等参数,观察模型在不同光照下的表现。官网特别强调,生成的 3D 对象具有高保真的外观、深度和法线信息,这些信息对于后续的渲染和编辑非常重要。
无需 3D 训练数据
DreamFusion 最大的技术亮点之一是完全不依赖 3D 训练数据。传统的 3D 生成方法通常需要大规模 3D 资产库进行训练,而高质量的 3D 数据获取成本极高、规模有限。DreamFusion 通过复用预训练的 2D 文本到图像扩散模型作为先验,绕过了对 3D 数据的依赖,极大地降低了数据门槛。同时,该方法也不需要对图像扩散模型进行任何架构修改或微调,直接利用现成的强大 2D 生成能力。
网格导出与场景合成
生成的 NeRF 模型可以通过 marching cubes 算法导出为网格(mesh),从而方便地集成到各类 3D 渲染器或建模软件中。这意味着用户不仅可以在 DreamFusion 的查看器中欣赏模型,还可以将模型导入 Blender、Maya 等工具进行二次编辑。此外,DreamFusion 支持将多个生成的物体组合到同一个 3D 场景中,官网展示了将多个对象合成到统一场景的示例,为场景搭建和内容创作提供了可能。
丰富的示例画廊
项目官网提供了一个包含数百个生成资产的完整画廊(Gallery),用户可以搜索和浏览各种文本提示下生成的 3D 模型。画廊中的示例覆盖了动物、食物、人物、乐器、交通工具等多种类别,并展示了不同材质(如木头雕刻、金属雕塑、苔藓套装等)和不同风格(如写实、卡通、高细节)的生成效果,帮助用户直观了解模型的能力边界。
使用方法
DreamFusion 目前主要以研究项目的形式呈现,官网提供了交互式演示入口。基本使用流程如下:
- 输入描述:在平台上输入你想要生成的 3D 模型的文本描述,描述应尽量具体,包含物体、材质、动作、风格等信息。
- 自动生成模型:系统根据描述,通过优化 NeRF 表示自动生成对应的 3D 模型。生成过程需要一定的计算时间,具体时长取决于提示词复杂度和硬件配置。
- 查看和调整:生成完成后,你可以从不同角度旋转查看模型,并调整光照条件,观察模型在不同环境下的表现。
- 导出使用:如需在其他 3D 软件中使用,可将 NeRF 模型导出为网格格式,再导入到渲染器或建模工具中。
需要注意的是,DreamFusion 官网本身是一个研究项目展示页,并非商业化产品,普通用户目前无法像使用普通 SaaS 工具那样直接上传图片或在线生成并下载模型。官网提供的交互演示主要用于展示技术能力,实际使用通常需要参考论文和开源实现(如 threestudio 等衍生项目)在本地或云端部署。
产品优势
| 对比维度 | DreamFusion | 传统 3D 生成方法 |
|---|---|---|
| 训练数据需求 | 无需 3D 训练数据,仅用预训练 2D 扩散模型 | 需要大规模带标签 3D 资产数据集 |
| 模型修改 | 不修改图像扩散模型架构 | 通常需针对 3D 数据设计专用网络 |
| 多视角一致性 | 通过 NeRF 优化保证任意角度一致 | 2D 方法多视角一致性较差 |
| 重光照能力 | 支持任意光照条件重光照 | 多数方法不支持或支持有限 |
| 输出格式 | NeRF 可导出为网格,便于集成 | 格式多样,质量参差不齐 |
此外,DreamFusion 的“2D 扩散先验 + NeRF 优化”范式具有很强的通用性和可扩展性,后续大量文本到 3D 工作(如 Magic3D、Fantasia3D、threestudio 等)都受其启发。该项目在学术上具有重要影响力,是 AIGC 尤其是 text-to-3D 任务中具有代表性的工作,凭借惊艳的 3D 生成效果获得了广泛关注。
应用场景
- 3D 内容创作:为游戏、动画、影视等行业的创作者提供快速生成 3D 资产的能力,降低建模门槛。
- 电商与产品展示:根据文字描述快速生成产品 3D 模型,用于在线展示和交互体验。
- 教育与科普:将抽象概念转化为可视化的 3D 模型,帮助理解和记忆。
- 学术研究:作为文本到 3D 生成领域的基线方法,供研究人员复现和改进。
- AR/VR 内容开发:快速生成可重光照的 3D 对象,用于沉浸式场景搭建。
目标用户
DreamFusion 主要面向 3D 内容创作者、AI 研究人员、游戏与动画开发者、电商产品展示团队以及对文本生成 3D 技术感兴趣的科技爱好者。对于希望快速验证创意的设计师来说,它提供了一种低门槛的 3D 原型生成方式;对于研究者而言,它则是理解 2D 扩散先验如何赋能 3D 生成的重要案例。
核心功能
优缺点分析
适用人群
常见问题


