
详细介绍
工具简介
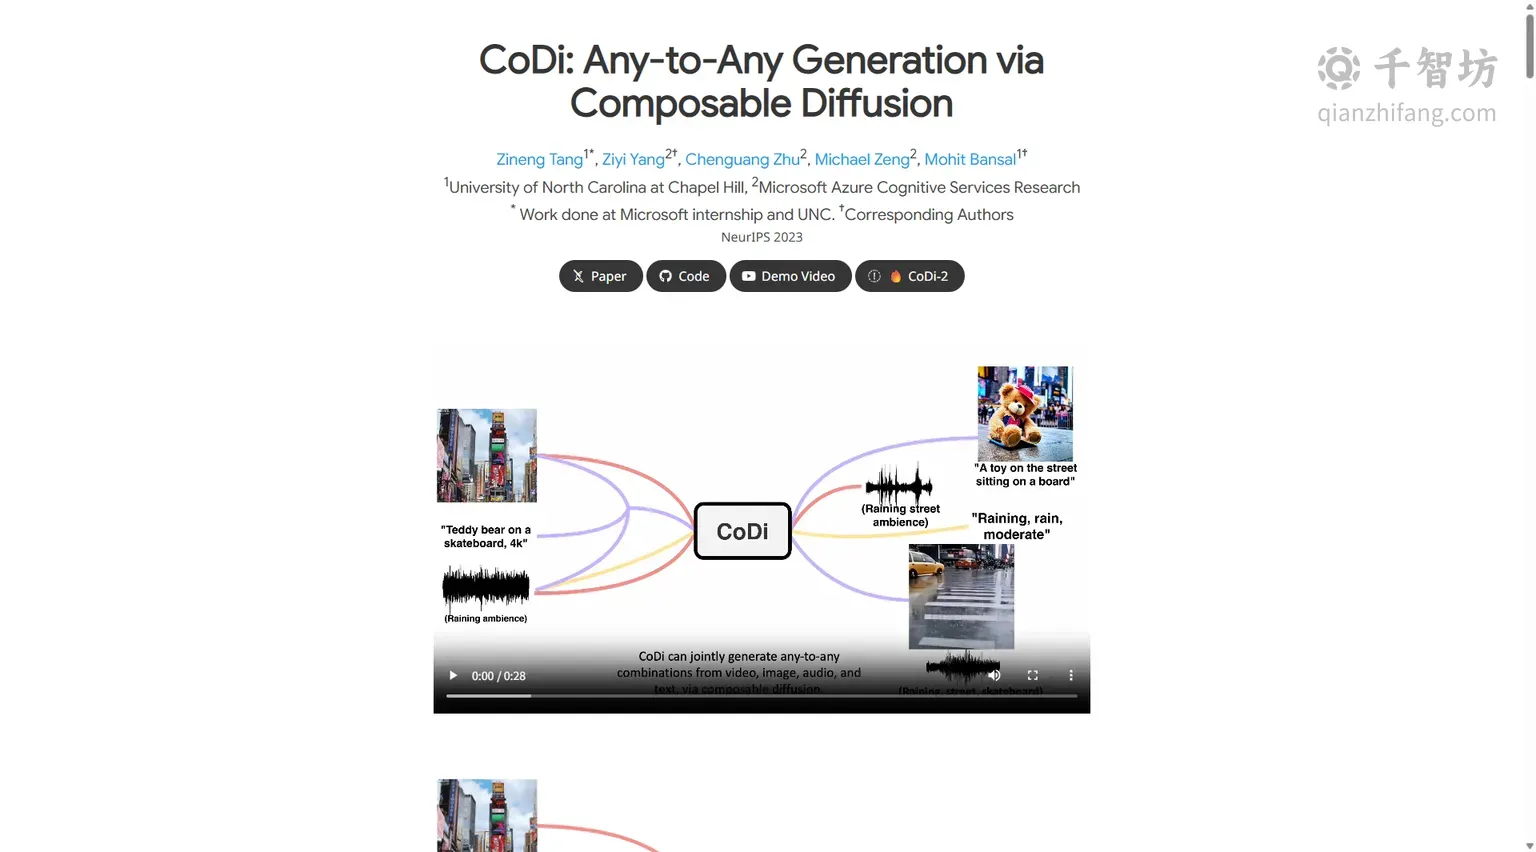
CoDi(全称Composable Diffusion,可组合扩散)是一款由北卡罗来纳大学教堂山分校(UNC)与微软Azure认知服务研究团队联合研发的多模态生成式AI模型,相关成果发表于NeurIPS 2023。该模型的核心突破在于:它能够从任意组合的输入模态(如语言、图像、视频或音频)生成任意组合的输出模态,真正实现了“任意到任意”(Any-to-Any)的跨模态生成能力。CoDi的官网为codi-gen.github.io,研究论文发布于arXiv(编号2305.11846),代码已在GitHub的microsoft/i-Code仓库中开源。
与现有的生成式AI系统不同,CoDi不仅可以并行生成多种模态,其输入也不再局限于文本或图像等单一子集。例如,用户可以同时输入文本、图像和音频,让模型生成一段带声音的视频;也可以仅输入一段文字,直接产出视频与音频同步对齐的完整内容。尽管许多模态组合的训练数据集在现实中并不存在,研究团队通过在输入和输出空间中对模态进行对齐,使CoDi能够自由地以任何输入组合为条件进行生成,即使这些组合从未在训练数据中出现过。
技术原理与架构
CoDi采用了一种新颖的可组合生成策略,其核心思想是在扩散过程中建立对齐关系,从而构建一个共享的多模态空间。这一设计使得交织模态(如时间上对齐的视频和音频)能够同步生成,而不是简单拼接。模型架构上,CoDi使用了多阶段训练方案,使其只需对线性数量的任务进行训练,却能在推理阶段覆盖所有输入和输出模态的组合,极大提升了训练效率与泛化能力。
具体而言,CoDi的扩散模型以模态对齐为基础,将不同模态的生成过程桥接在同一个潜在空间中。这种共享空间不仅让模型理解跨模态语义,还保证了输出内容在时间或语义上的一致性。例如在生成视频时,音频轨道会与画面动作自然匹配,而非独立生成后强行对齐。
生成模式与使用示例
CoDi支持多种灵活的生成模式,官方演示中展示了以下几类典型用法:
- 多输出联合生成:模型接受单个或多个提示(包括视频、图像、文本或音频),生成多个对齐的输出,如伴有声音的视频。例如输入“滑板上的泰迪熊,4k,高分辨率”的文本,同时给出参考图像和音频,模型可输出带音效的视频。
- 多条件生成:模型接受多个输入(包括视频、图像、文本或音频)生成输出,例如结合音频与图像生成对应的文本描述和图像。
- 单对单生成:模型接受单个提示(包括视频、图像、文本或音频)生成单个输出。例如仅输入“天空中的烟花”文本,即可生成视频与音频同步的内容。
官网演示中还给出了“珊瑚礁潜水”“火车进站”“森林中弹钢琴”“赛博朋克城市电影场景”等示例,覆盖文本到视频加音频、文本加图像到文本加图像等多种组合,充分体现了模型在跨模态创作上的自由度。
性能表现与定位
CoDi高度可定制且灵活,在联合模态生成质量上表现强劲,官方称其与单模态合成的最新技术相当或更优。这意味着用户在使用CoDi进行多模态联合生成时,不必在质量上做出妥协。作为一项研究导向的模型,CoDi目前主要通过论文、代码仓库和在线演示页面向研究者和开发者开放,尚未提供成熟的商业化产品界面,价格模式也尚未明确。
使用方法
目前体验CoDi的主要途径包括:访问官网codi-gen.github.io查看演示视频与生成示例;阅读arXiv上的研究论文了解技术细节;通过GitHub仓库(microsoft/i-Code/tree/main/i-Code-V3)获取代码进行本地部署或二次开发。对于希望深入研究多模态生成的研究人员,CoDi提供了完整的模型架构与训练思路参考。
主要功能
- 任意模态输入:支持文本、图像、视频、音频的任意组合作为条件输入。
- 任意模态输出:可生成文本、图像、视频、音频的任意组合,支持并行多模态输出。
- 同步交织生成:视频与音频等时间相关模态可同步对齐生成。
- 零样本组合泛化:即使训练数据中不存在的模态组合也能推理生成。
- 多阶段训练架构:线性任务训练覆盖全部输入输出组合。
核心功能
优缺点分析
适用人群
常见问题


