
详细介绍
工具简介
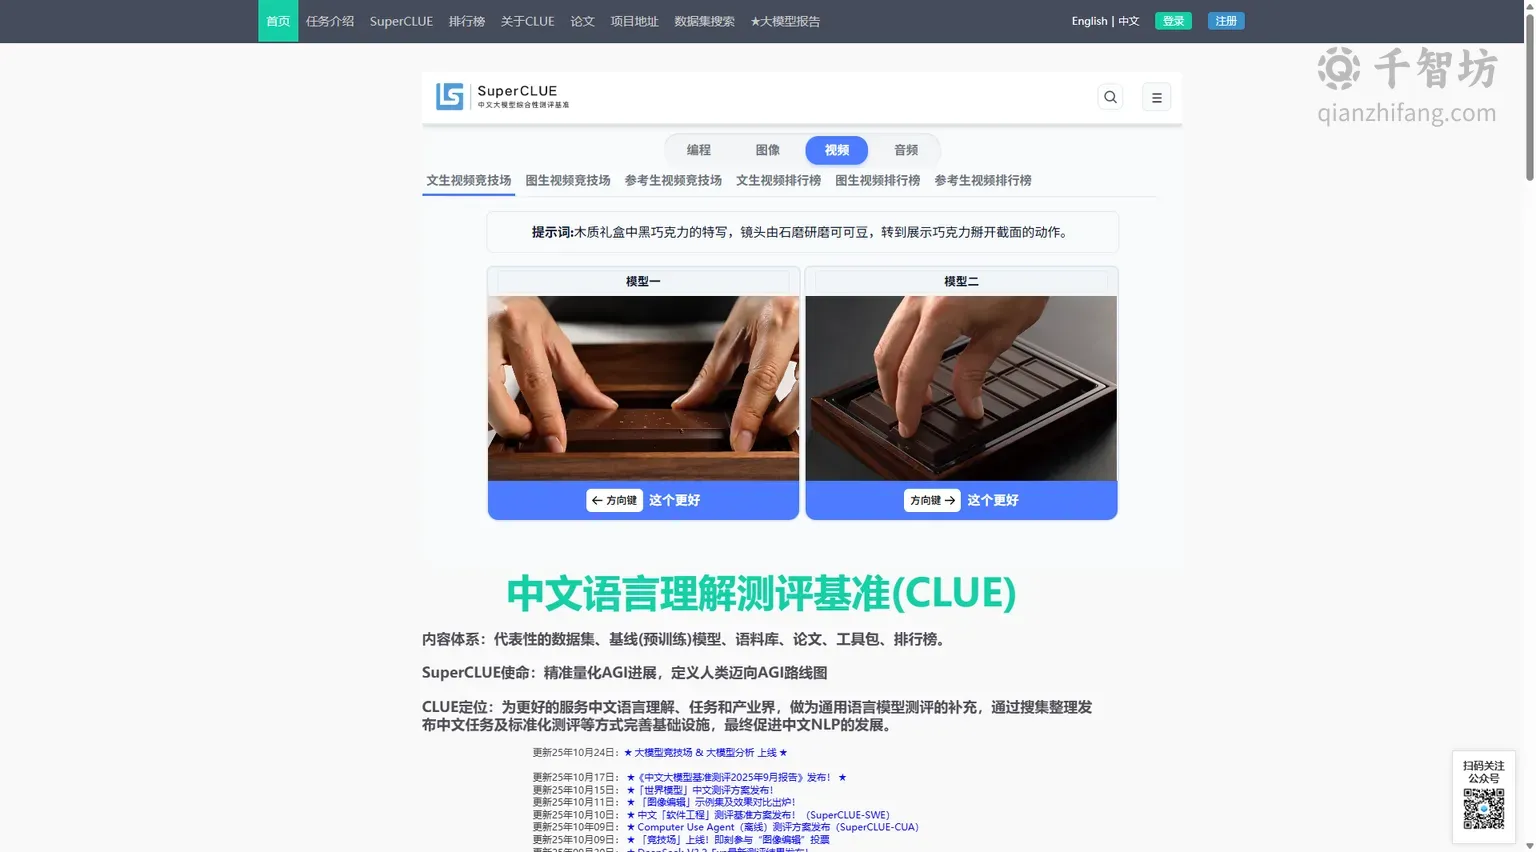
CLUE(Chinese Language Understanding Evaluation)中文语言理解基准测评是一个专注于中文语言理解能力评估的综合性平台。该项目由业界研究团队发起并持续维护,旨在为中文语言理解、任务和产业界提供通用语言模型测评的补充,通过完善中文语言理解基础设施的方式来促进中文语言模型的发展。CLUE 汇聚了代表性的数据集、基准预训练模型、语料库以及公开排行榜,构建了一套覆盖不同任务类型、不同数据量级和不同任务难度的测评体系。
作为中文 NLP 领域的重要基础设施,CLUE 并非单一的工具或模型,而是一套完整的评测生态。它选择了一系列具有代表性的任务对应的数据集作为测试基准,这些数据集覆盖了文本分类、阅读理解、自然语言推理、语义匹配、命名实体识别、小样本学习、零样本学习等多种任务类型。通过统一的评测标准和公开透明的排行榜,CLUE 为研究人员和开发者提供了一个客观比较不同中文语言模型能力的舞台。
随着大语言模型时代的到来,CLUE 团队在原有基准的基础上推出了 SuperCLUE 系列评测体系,将评测范围从传统预训练语言模型扩展到通用大语言模型,并针对金融、工业、汽车、安全、Agent、RAG 检索增强、代码生成、数学推理、文生视频等垂直场景和专项能力推出了细分的测评榜单。这使得 CLUE 从一个学术导向的基准测评逐步演化为覆盖学术研究与产业应用的综合性中文大模型评测平台。
主要功能
多任务数据集与基准模型
CLUE 提供了一套覆盖多种 NLP 任务的数据集集合,包括分类、阅读理解、自然语言推理、语义匹配、命名实体识别等。每个任务都配有相应的训练集、验证集和测试集,并提供了基准预训练模型供研究者参考。这些数据集经过精心筛选,兼顾了任务代表性和数据质量,使得评测结果能够真实反映模型的中文理解能力。
公开透明的排行榜体系
平台维护了多个维度的排行榜,包括总排行榜、分类排行榜、阅读理解榜、语义匹配榜、NER 排行榜、小样本学习榜、零样本学习榜等。排行榜定期更新,记录各模型在不同任务上的表现,并保留历史版本(如 1.0、1.1 等),方便研究者追踪技术演进趋势。所有榜单均公开可查,确保了评测的透明性和可比性。
SuperCLUE 大模型综合评测
SuperCLUE 是 CLUE 面向大语言模型推出的综合评测体系,涵盖最新榜单、大模型年度报告、金融大模型测评、工业大模型测评、汽车基准、Agent 中文场景、Safety 安全对抗、OPEN 多轮开放式、OPT 三大能力客观题等多个专项。SuperCLUE 琅琊榜作为核心榜单,汇总了各维度评测结果,为产业界选择大模型提供参考依据。
垂直领域与专项能力测评
CLUE 针对特定领域和专项能力推出了细分的测评模块,包括 RAG 检索增强测评、200K 超长文本测评、Role 角色大模型测评、Video 文生视频测评、Code3 代码生成测评、Math6 数学推理测评等。这些专项测评帮助开发者和企业了解模型在具体应用场景中的表现,为技术选型和产品优化提供数据支撑。
语料库与基础设施
除了数据集和排行榜,CLUE 还提供语料库等基础设施资源,支持中文语言模型的训练和评估。通过完善中文语言理解的基础设施,CLUE 降低了研究者和开发者进入中文 NLP 领域的门槛,推动了整个中文语言模型生态的繁荣。
使用方法
使用 CLUE 平台非常便捷,用户无需注册即可访问官网浏览各类榜单和数据集介绍。对于研究者,可以下载对应的数据集和基准模型,在自己的环境中复现评测结果或提交新的模型成绩。对于产业界用户,可以通过 SuperCLUE 榜单快速了解各主流大模型在中文场景下的能力表现,结合金融、工业、汽车等垂直领域榜单进行选型决策。平台还通过公众号等渠道发布大模型年度报告和月度报告,帮助用户把握技术动态。
产品优势
- 评测体系全面:覆盖传统 NLP 任务与大模型综合能力,兼顾学术研究与产业应用。
- 榜单透明可比:公开排行榜保留历史版本,便于追踪模型能力演进。
- 垂直场景深入:金融、工业、汽车、安全、Agent 等专项测评贴近真实应用需求。
- 基础设施完善:数据集、基准模型、语料库、排行榜一体化,降低研究与开发门槛。
应用场景
CLUE 广泛应用于学术研究中的模型对比实验、企业大模型选型评估、垂直行业模型能力验证、AI 产品研发中的效果基准测试等场景。无论是高校实验室还是企业 AI 团队,都可以借助 CLUE 的评测结果和数据集加速研发进程,提升中文语言模型的落地效果。
核心功能
优缺点分析
适用人群
常见问题


