
CLIP Interrogator 是一款结合 OpenAI CLIP 与 Salesforce BLIP 的提示词工程工具,可从图片反推出适合 Stable Diffusion 等文生图模型的文本提示词。
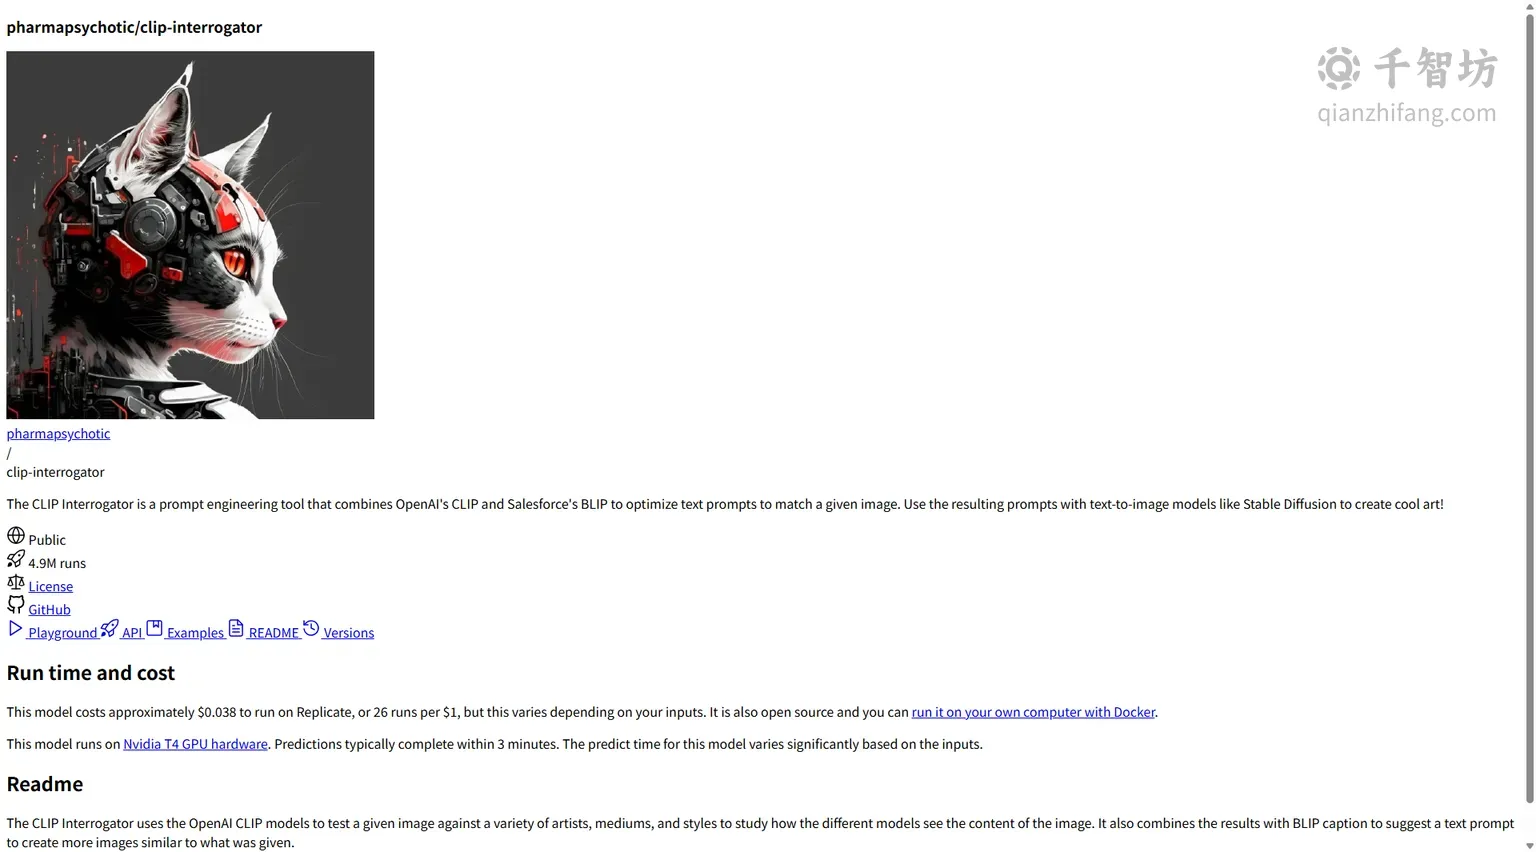
详细介绍
工具简介
CLIP Interrogator 是由开发者 pharmapsychotic 打造的一款提示词工程(Prompt Engineering)工具,托管于 Replicate 平台之上,其核心使命是解决文生图创作中的一个经典难题:当你看到一张心仪的图片,却不知道该如何用文字描述它,才能让 Stable Diffusion 等模型复现出类似风格与内容。CLIP Interrogator 正是为此而生——它能够对上传的图片进行深度分析,自动生成一段高度匹配该图像的文本提示词,让用户直接拿去做二次创作或风格迁移。
从技术架构上看,CLIP Interrogator 巧妙地组合了两大开源视觉语言模型:OpenAI 的 CLIP 与 Salesforce 的 BLIP。BLIP 擅长生成对图像内容的自然语言描述,能够识别画面中的主体、场景与动作;而 CLIP 则擅长衡量文本与图像之间的语义相似度,可以在海量候选标签中筛选出与图像最贴合的词汇组合。两者协同工作,使得最终输出的提示词既具备语义准确性,又具备风格描述力,远胜于单一模型的效果。
在 Replicate 平台上,该模型已累计运行超过 490 万次,公开可见、评分高达 4.9 分,足见其在 AI 绘画社区中的受欢迎程度。用户无需本地部署环境,打开网页即可上传图片、选择模型参数并一键生成提示词,也可以通过 API 将其集成到自己的工作流中。
主要功能
图像到提示词的反向解析
这是 CLIP Interrogator 最核心的能力。用户上传任意一张图片后,工具会分析画面的视觉特征,输出一段结构化的英文提示词,涵盖主体内容、艺术风格、光照氛围、构图方式、画质修饰词等维度。对于想要学习提示词写作的新手而言,这相当于一位随时在线的“提示词导师”,可以直观地看到专业提示词是如何组织的。
多档 CLIP 模型可选
工具提供了三种 CLIP 模型供用户选择,分别对应不同的文生图模型世代:
- ViT-L-14/openai:默认选项,适合 Stable Diffusion 1.x 系列模型,速度快、通用性强;
- ViT-H-14/laion2b_s32b_b79k:适合 Stable Diffusion 2.x 系列,语义理解能力更强;
- ViT-bigG-14/laion2b_s39b_b160k:适合 Stable Diffusion XL(SDXL),参数规模最大,对复杂画面的解析更为细腻。
这种按目标模型选择 CLIP 版本的设计,体现了工具对生成式 AI 生态的深度理解——不同世代的扩散模型在训练数据与文本编码器上存在差异,匹配对应的 CLIP 才能让反推出来的提示词发挥最大效用。
四种提示词生成模式
CLIP Interrogator 提供 best、classic、fast、negative 四种模式,兼顾质量与速度:
- best 模式:耗时约 10 至 20 秒,综合效果最佳,适合对提示词质量要求高的场景;
- fast 模式:仅需 1 至 2 秒即可出结果,适合快速预览或批量处理;
- classic 模式:采用经典的反推流程,输出风格相对稳定;
- negative 模式:生成负面提示词,帮助用户在文生图时排除不想要的元素,提升出图质量。
负面提示词模式尤其值得关注,因为在实际创作中,负面提示词对画面质量的调控作用往往不亚于正面提示词,而多数用户并不擅长撰写负面提示词,该模式正好填补了这一空白。
与 Stable Diffusion 生态无缝衔接
工具官方明确说明,其生成的提示词可直接用于 Stable Diffusion 等文生图模型,用于创作“酷炫的艺术作品”。这意味着用户可以形成“看图 → 反推提示词 → 修改润色 → 重新生成”的完整创作闭环,既可用于模仿特定风格,也可用于探索新的视觉表达。
API 与代码集成能力
作为 Replicate 平台上的模型,CLIP Interrogator 提供了完整的 API 接口,支持通过 Node.js、Python、HTTP 等方式调用,官方甚至提供了“一行代码”即可运行的示例。开发者可以将其嵌入自己的图像处理管线、设计工具或内容平台,实现自动化的提示词生成服务。
网页端交互式 Playground
Replicate 为 CLIP Interrogator 提供了 Playground 界面,用户可以直接在浏览器中上传文件(也支持调用摄像头拍照),选择模型与模式后点击运行,即可在页面上查看输出结果。对于不写代码的普通用户来说,这是最友好的使用方式。
使用方法
- 打开 Replicate 上 CLIP Interrogator 的模型页面,进入 Playground;
- 在 image 输入框中上传本地图片,或使用摄像头拍摄;
- 根据你使用的文生图模型选择 clip_model_name:Stable Diffusion 1 选 ViT-L,Stable Diffusion 2 选 ViT-H,SDXL 选 ViT-bigG;
- 选择 mode:追求质量选 best,追求速度选 fast,需要负面提示词选 negative;
- 点击运行,等待数秒至二十秒左右,即可获得反推的提示词文本;
- 将结果复制到 Stable Diffusion 等工具中,按需增删关键词后生成图像。
产品优势
| 对比维度 | CLIP Interrogator 的表现 |
|---|---|
| 技术组合 | CLIP + BLIP 双模型协同,兼顾语义理解与风格描述 |
| 模型适配 | 覆盖 SD 1.x、SD 2.x、SDXL 三代模型 |
| 模式灵活度 | 四种模式,质量与速度可自由权衡 |
| 使用门槛 | 网页即开即用,无需本地显卡与部署 |
| 社区验证 | 490 万次运行、4.9 分评分,口碑扎实 |
应用场景
- 风格模仿与学习:看到喜欢的插画、摄影或概念图,反推出提示词,研究其风格构成;
- 提示词写作训练:新手通过对比“原图”与“反推提示词”,快速理解提示词的组织逻辑;
- 创作流程提效:设计师以参考图为起点,快速获得可用的提示词草稿,再人工润色;
- 批量图像标注:开发者通过 API 为图库自动生成描述性文本,用于数据集构建或内容检索;
- 负面提示词生成:利用 negative 模式为已有创作补充负面提示词,改善出图稳定性。
目标用户与注意事项
CLIP Interrogator 主要面向 AI 绘画爱好者、提示词工程师、视觉设计师、内容创作者以及需要图像理解能力的开发者。需要提醒的是,工具输出的提示词为英文,且本质上是“最接近图像的描述”,并不保证复现原图;同时它运行在 Replicate 平台上,采用按运行计费的模式,具体价格需以平台定价页为准,大批量调用前建议先评估成本。
核心功能
优缺点分析
适用人群
常见问题


