
晨涧云

晨涧云

付费Web
访问官网

晨涧云是提供GPU云服务器租赁、大模型API接入与AI应用部署的算力服务平台,支持按小时计费,性价比高。

晨涧云访问官网

详细介绍

工具简介

晨涧云(MornAI)是一个专注于AI算力租赁与服务的云平台,官网为 https://www.mornai.cn。该平台致力于为人工智能开发者、研究机构和企业提供高效、稳定且成本低廉的GPU算力资源,同时整合了大模型API、镜像中心、算力市场等模块,形成从算力供给到应用部署的一站式服务体系。晨涧云通过云容器和云主机两种形态,让用户能够以小时计费的方式灵活使用高性能显卡,并支持一键部署AI应用,即开即用。

在AI模型训练与推理需求爆发式增长的背景下,算力成本成为许多团队的核心痛点。晨涧云瞄准这一市场,凭借数千张GPU卡、覆盖全国8个省市的节点网络,以及仅为传统公有云1-3折的定价策略,迅速构建起差异化竞争力。平台还创新性地推出算力变现计划,当GPU利用率低于40%时,用户可将闲置资源加入计划获取收益,从而实现成本效益最大化。


主要功能

GPU云服务器租赁

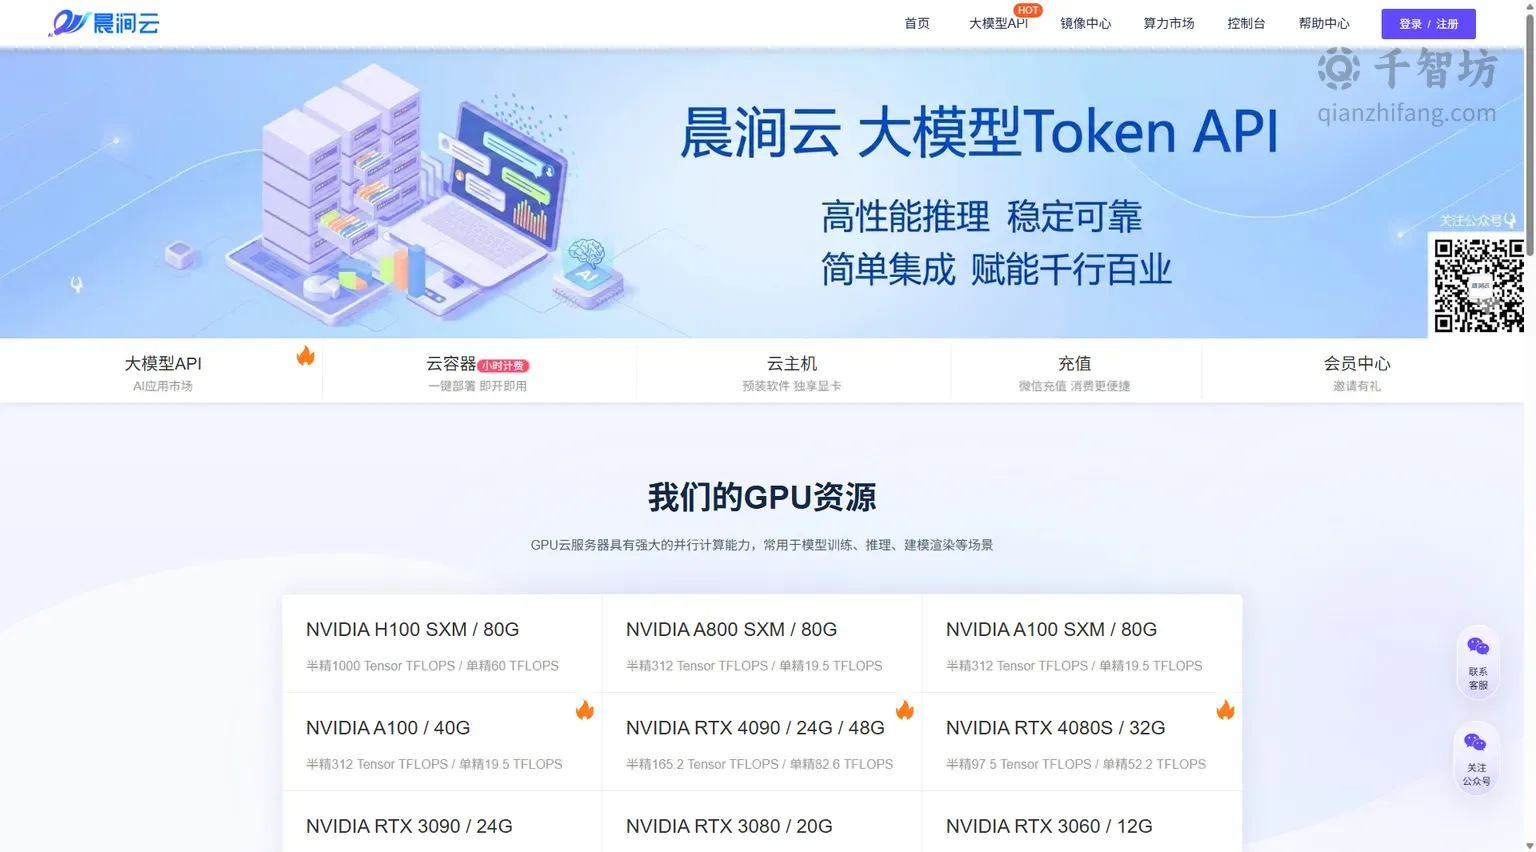
晨涧云提供多种型号的GPU云服务器,涵盖从入门级到旗舰级的完整产品线。具体包括:NVIDIA H100 SXM(80G),半精度Tensor算力达1000 TFLOPS,单精度60 TFLOPS;NVIDIA A800 SXM(80G)和A100 SXM(80G),半精度312 TFLOPS,单精度19.5 TFLOPS;A100(40G)版本;以及RTX 4090(24G/48G),半精度165.2 TFLOPS,单精度82.6 TFLOPS;RTX 4080S(32G),半精度97.5 TFLOPS;RTX 3090(24G),半精度71 TFLOPS;RTX 3080(20G)和RTX 3060(12G)等。这些GPU资源可广泛应用于深度学习模型训练、推理、建模渲染、大数据分析等场景,用户可根据业务需求精准匹配算力规格。

云容器与云主机

平台提供云容器小时计费和一键部署能力,用户无需关心底层环境配置,即可快速启动AI应用。云主机则预装常用软件,提供独享显卡资源,适合需要长期稳定运行的任务。两种形态互补,覆盖短期实验与长期生产的不同需求。

大模型API服务

晨涧云旗下的大模型API平台(apirouter.mornai.cn)聚合了多种主流大模型接口,开发者可通过统一入口调用AI能力,快速集成到自己的应用之中。该服务被平台标记为HOT,表明其是重点推荐功能,适合需要快速构建AI应用但不想自行部署模型的团队。

镜像中心与算力市场

镜像中心提供预配置的软件环境镜像,用户可直接选用,省去环境搭建时间。算力市场则展示各类GPU资源的实时价格与库存,方便用户比较和选购。控制台提供充值、会员中心、邀请有礼等功能,微信充值让消费更加便捷。


产品优势

资源丰富:平台拥有数千张GPU卡,种类繁多,从H100到RTX 3060覆盖不同算力层级,能够针对深度学习、大数据分析、图形渲染等不同业务提供精准匹配。

分布广泛:节点网络遍及全国8个省市,用户可将业务部署至离用户最近之处,优化响应速度并提升终端用户体验。

高性价比:GPU定价仅为传统公有云的1-3折,大幅降低AI开发与运行的算力门槛。同时,算力变现计划让闲置资源产生收益,进一步摊薄成本。

弹性调度:支持一键部署AI应用,智能系统根据业务流量波动自动扩容,确保稳定高效运行,简化运维流程。


使用方法

  1. 访问晨涧云官网并注册账号,完成登录。
  2. 在算力市场或镜像中心浏览可用的GPU规格与预装环境,选择适合的云容器或云主机。
  3. 根据提示完成配置并支付(支持微信充值),一键部署所需AI应用或开发环境。
  4. 通过控制台管理实例,监控资源使用情况,按需调整配置或扩容。
  5. 如需调用大模型能力,可前往大模型API平台获取接口并集成到应用中。


应用场景

  • 深度学习模型训练:利用H100、A100等高端显卡加速大规模神经网络的训练过程。
  • AI推理服务部署:通过云容器快速部署推理服务,弹性应对流量波动。
  • 科研与教学实验:学生和研究人员可按小时租用GPU,低成本完成实验项目。
  • 图形渲染与建模:借助RTX系列显卡的并行计算能力加速3D渲染和建模工作。
  • 大模型应用开发:通过大模型API快速集成对话、生成等AI能力,缩短产品开发周期。


企业服务

晨涧云面向企业客户提供释放智能潜力的全方位算力支持,以高效、专业的解决方案助力业务发展。企业可根据自身业务规模与合规要求,获得定制化的资源部署方案与技术服务,确保AI应用在生产环境中的稳定运行。

核心功能

1
多型号GPU云服务器
提供H100、A800、A100、RTX 4090/4080S/3090/3080/3060等多种GPU规格,覆盖从旗舰训练到轻量推理的全场景算力需求,用户可按业务精准匹配,兼顾性能与成本。
2
云容器小时计费
支持按小时计费的云容器服务,一键部署AI应用,即开即用,无需关心底层环境配置,适合短期实验、临时任务和快速验证场景,大幅降低使用门槛。
3
云主机独享显卡
提供预装常用软件的云主机,配备独享显卡资源,适合需要长期稳定运行的生产任务,避免资源争抢,保障计算性能的持续可靠。
4
大模型API接入
聚合多种主流大模型接口,开发者通过统一入口即可调用AI能力,快速集成到自有应用中,省去自行部署模型的复杂流程,加速AI应用落地。
5
镜像中心
提供预配置的软件环境镜像,涵盖常见AI框架和工具,用户可直接选用,省去环境搭建与依赖配置时间,快速进入开发状态。
6
算力市场
集中展示各类GPU资源的规格与价格,方便用户横向比较和选购,结合实时库存信息做出最优算力采购决策。
7
算力变现计划
当GPU利用率低于40%时,用户可加入算力变现计划,将闲置资源转化为实际收益,实现成本效益最大化,特别适合利用率波动较大的团队。
8
弹性调度与自动扩容
智能系统根据业务流量波动自动实现资源扩容,确保应用稳定高效运行,简化运维流程,让AI应用部署更加灵活便捷。

优缺点分析

优点
+GPU资源种类丰富,从H100到RTX 3060覆盖全面,数千张显卡可满足不同层级算力需求
+定价仅为传统公有云的1-3折,性价比突出,显著降低AI开发与运行成本
+节点遍布全国8个省市,可就近部署优化响应速度,提升终端用户体验
+支持小时计费、一键部署和弹性扩容,使用灵活,运维负担轻
缺点
-官网未明确公示具体价格明细,用户需注册后在算力市场查看,前期比价不够直观
-平台功能模块较多(云容器、云主机、API、镜像中心等),新用户初次上手需要一定学习成本

适用人群

AI算法工程师与深度学习研究者,需要灵活租用GPU进行模型训练和实验初创AI团队与中小企业,追求高性价比算力以控制研发成本应用开发者,希望通过大模型API快速集成AI能力到产品中高校师生与科研人员,需要低成本GPU资源完成科研项目和教学实验图形渲染与建模从业者,需要并行计算能力加速渲染工作

常见问题

Q: 晨涧云的GPU算力价格如何?计费方式是怎样的?
晨涧云宣称其GPU定价仅为传统公有云的1-3折,具体价格因GPU型号和租用形态而异,用户可在官网的算力市场页面查看实时价格。平台支持云容器小时计费,按实际使用时长付费,适合短期和弹性需求;云主机则适合长期稳定使用。充值支持微信支付,消费便捷。此外,当GPU利用率低于40%时,用户还可加入算力变现计划,将闲置资源转化为收益,进一步降低实际成本。
Q: 晨涧云支持哪些GPU型号?分别适合什么场景?
平台提供丰富的GPU型号选择:H100 SXM(80G)适合大规模模型训练和高性能计算;A800/A100 SXM(80G)适合深度学习训练与推理;A100(40G)为中等规模任务提供平衡选择;RTX 4090(24G/48G)和RTX 4080S(32G)适合推理、渲染和中等规模训练;RTX 3090/3080/3060则适合轻量级任务、教学实验和小型推理服务。用户可根据算力需求、显存大小和预算精准匹配。
Q: 大模型API服务如何使用?
用户可访问晨涧云的大模型API平台(apirouter.mornai.cn),该平台聚合了多种主流大模型接口。开发者注册后获取API密钥,即可通过统一入口调用所需模型能力,将其集成到自己的应用、网站或工作流中。这种方式省去了自行部署模型的硬件采购和环境配置环节,特别适合希望快速构建AI应用但缺乏算力运维经验的团队。具体接入文档可在平台帮助中心查阅。
Q: 云容器和云主机有什么区别?应该如何选择?
云容器采用小时计费、一键部署、即开即用的模式,用户无需关心底层环境,适合短期实验、临时任务和快速验证场景,灵活性高。云主机则预装软件并提供独享显卡资源,适合需要长期稳定运行的生产任务,能避免资源争抢。简单来说,短期弹性需求选云容器,长期稳定需求选云主机。两者可以配合使用,例如用容器做开发测试,用主机跑生产服务。
Q: 晨涧云的节点分布和网络覆盖情况如何?
晨涧云的节点网络遍及全国8个省市,这一布局使用户能够将业务精准部署至离终端用户最近的位置,从而优化响应速度并增强用户体验。对于对延迟敏感的应用(如实时推理、在线服务),就近部署尤为重要。用户在选择资源时可根据目标用户分布选择合适地域的节点,平台的控制台和算力市场会展示可用区域信息,帮助做出合理部署决策。