
详细介绍
工具简介
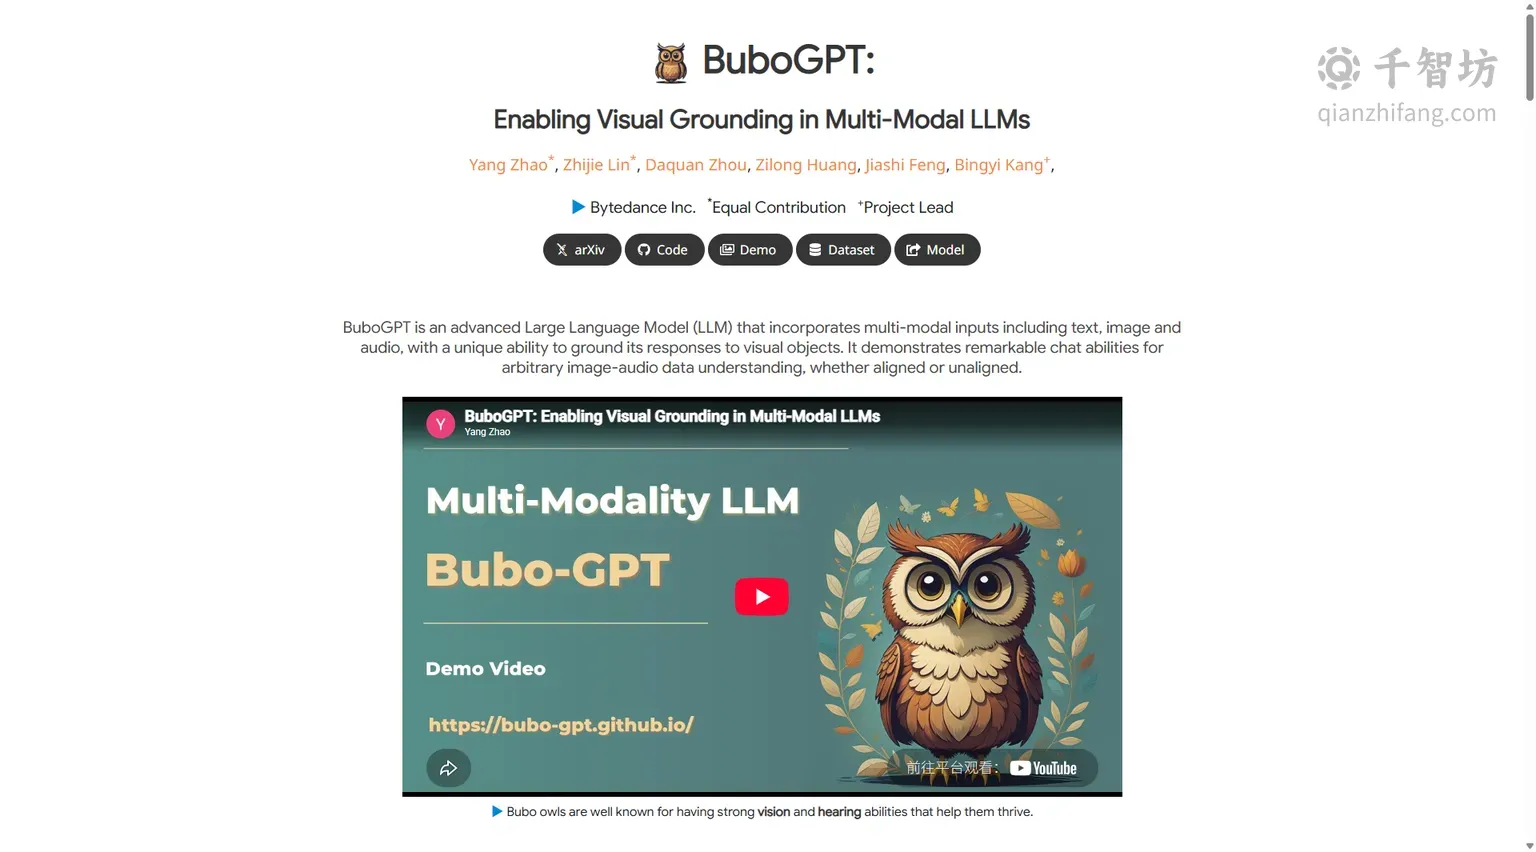
BuboGPT 是由字节跳动(ByteDance Inc.)研究团队推出的一款先进多模态大语言模型(Multi-Modal Large Language Model)。该模型的核心突破在于,它不仅能够同时处理文本、图像和音频三种模态的输入,还具备一项独特的能力——视觉定位(Visual Grounding),即将其对视觉对象的语言响应精确地“锚定”到图像中的具体区域。这一能力使得 BuboGPT 在多模态理解领域脱颖而出,区别于 MiniGPT-4、LLaVA、X-LLM 等仅能生成粗粒度映射的同类模型。
BuboGPT 的命名灵感来源于鸮(Bubo 为雕鸮属的学名),这类猫头鹰以卓越的视觉和听觉能力著称,能够在复杂环境中精准定位猎物。研究团队借此寓意模型在视觉与听觉信息处理上的强大能力。该项目由 Yang Zhao、Zhijie Lin 等人共同完成,其中 Yang Zhao 与 Zhijie Lin 为共同第一作者,Bingyi Kang 担任项目负责人,相关论文已发布在 arXiv 上,并开源了代码、演示、数据集与模型。
技术架构与核心原理
共享语义空间学习
BuboGPT 的核心设计思想是构建一个共享表示空间(Shared Representation Space),将文本、图像和音频三种模态的语义对齐到统一空间中,并与预训练的 Vicuna 语言模型良好对齐。具体而言,模型通过多模态编码器分别提取图像和音频特征,再将其映射到与文本语义一致的空间中,从而让语言模型能够“理解”非文本信号。这种设计使得 BuboGPT 能够执行联合的多模态理解与对话,而非简单地将各模态独立处理。
现成的视觉定位流水线
为了探索不同视觉对象与不同模态之间的细粒度关系,研究团队构建了一条现成的视觉定位流水线(Off-the-shelf Visual Grounding Pipeline)。该流水线能够在模型生成文本回答的同时,定位出回答所对应的图像区域,从而实现“言之有物”的响应。无论是图像与音频对齐(aligned)还是未对齐(unaligned)的场景,BuboGPT 都能展现出卓越的聊天与理解能力。例如,当用户输入一张图片和一段音频时,模型不仅能描述音频内容,还能指出音频中声音来源在图像中的具体位置。
多模态指令微调数据
训练如此强大的多模态模型离不开高质量的数据支撑。研究团队构建了一套多模态指令微调数据集(Multimodal Instruct Data),其中包含细粒度的音频描述和跨模态声音定位标注,并引入了正负图像-音频配对用于语义匹配,以促进跨模态理解。根据官网公布的数据集信息,主要数据文件包括:
- conversation_58k.json:约 126 MB,包含 58K 条对话样本;
- detail_23k.json:约 20.5 MB,包含 23K 条细节描述样本;
- complex_reasoning_77k.json:约 79.6 MB,包含 77K 条复杂推理样本。
这些数据覆盖了对话、细节描述与复杂推理等多种任务类型,为模型的多模态理解能力提供了坚实基础。数据集已在 HuggingFace 平台开放下载。
主要功能
多模态联合理解与对话
BuboGPT 支持文本、图像和音频的联合输入,能够在一个统一的对话框架内对多种模态信息进行综合理解。用户可以上传一张图片并配上一段音频,模型会结合两者给出连贯的回答,而非孤立地处理每一种输入。这种联合理解能力使得交互更加自然,贴近人类的多感官认知方式。
视觉定位响应
这是 BuboGPT 最具差异化的能力。模型在生成语言回答时,能够将其描述的对象定位到图像中的具体区域,实现文本与视觉内容的细粒度对应。例如,当被问及“图中哪个物体发出了这个声音”时,模型不仅能回答物体名称,还能标出其位置。这一能力显著提升了多模态对话的可解释性与实用性。
任意图像-音频理解
无论图像与音频是否在语义上对齐,BuboGPT 都能进行有效理解。对于对齐数据(如视频中画面与声音自然匹配),模型可以顺畅地联合描述;对于未对齐数据(如图片与无关音频),模型也能分别理解并处理,展现出较强的鲁棒性。
跨模态语义匹配
通过引入正负图像-音频配对训练,BuboGPT 具备判断图像与音频语义是否匹配的能力。这一功能在内容审核、多媒体检索、跨模态推荐等场景中具有潜在应用价值。
复杂推理与细节描述
借助包含 77K 复杂推理样本和 23K 细节描述样本的指令微调数据,BuboGPT 能够执行多步推理任务,并对图像内容进行细致入微的描述。这使得它在需要深度理解的应用中表现优异。
使用方法与获取途径
BuboGPT 是一个开源研究项目,用户可通过其官网(bubo-gpt.github.io)获取论文、代码、演示(Demo)、数据集和模型等资源。官网提供了 arXiv 论文链接、GitHub 代码仓库、在线 Demo 体验入口以及 HuggingFace 数据集下载地址。研究人员和开发者可以基于开源代码进行复现、微调或二次开发。由于该项目定位为研究型模型,普通用户主要通过官方 Demo 体验其多模态对话与视觉定位能力,暂未提供成熟的商业化产品界面。
产品优势与局限
优势方面,BuboGPT 首次在多模态大语言模型中实现了细粒度的视觉定位,弥补了同类模型仅能构建粗粒度映射的不足;其开源策略为学术研究和产业应用提供了宝贵资源;多模态指令数据的构建方法也具有参考价值。
局限方面,作为研究项目,BuboGPT 目前缺乏面向普通用户的产品化封装,使用门槛较高;其定价模式尚未公布,商业化路径不明确;此外,模型对计算资源的要求较高,普通开发者部署存在一定难度。
应用场景
- 学术研究:多模态学习、视觉定位、跨模态理解等方向的研究者可基于该模型开展实验。
- 智能助手开发:开发者可借鉴其架构构建具备视觉定位能力的多模态对话系统。
- 多媒体内容分析:用于图像-音频匹配检测、视频内容理解等任务。
- 无障碍技术:为视障用户提供结合声音与图像定位的描述服务。
核心功能
优缺点分析
适用人群
常见问题


