
详细介绍
工具简介
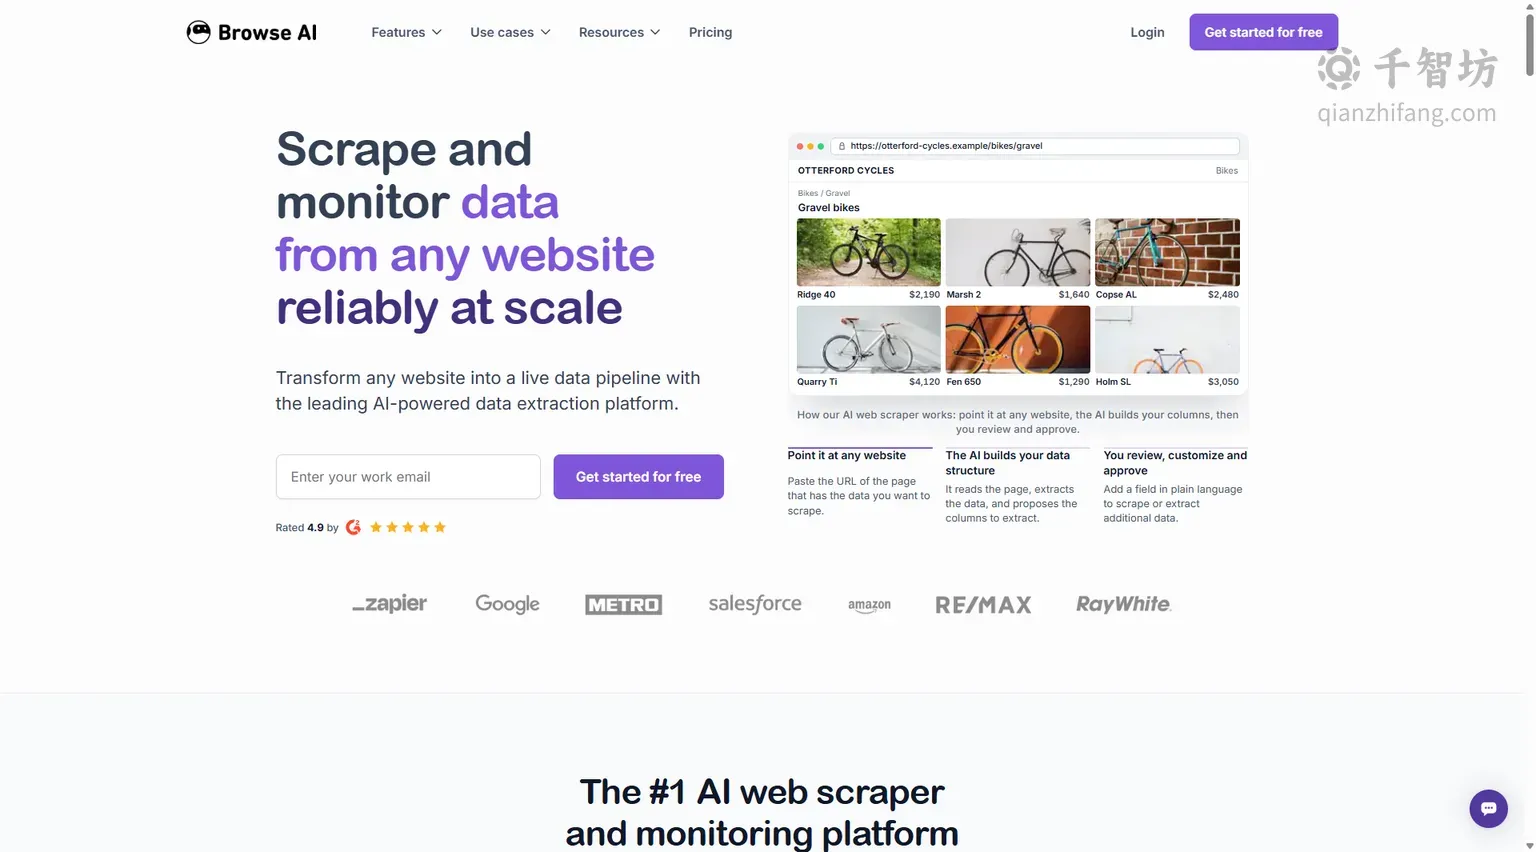
Browse AI 是一款基于人工智能的无代码网页数据抓取与监控平台,由 Browse AI 团队推出,官网地址为 https://browse.ai。它的核心使命是让任何人都能像使用普通办公软件一样,轻松地从互联网上提取、监控和自动化数据,而无需编写一行代码。传统网页抓取往往依赖技术团队编写爬虫脚本,一旦目标网站改版,脚本就可能失效,维护成本极高。Browse AI 通过 AI 驱动的“机器人”技术改变了这一局面:用户只需输入网址,AI 会自动读取页面结构并推荐需要提取的数据列,用户确认后即可生成一个可持续运行的抓取机器人。该平台将网站转化为可靠的实时数据管道,即使网站布局发生变化,AI 也能自适应调整,保持数据提取的稳定性与准确性。
截至目前,Browse AI 已被全球数千家企业信任,累计帮助用户节省了超过 25 万小时的工作时间,并自动化了 25 万多个任务。平台拥有超过 77 万用户,在评测中获得 4.9 分的高评价。无论是市场研究、竞品价格监控,还是销售线索生成、房地产数据采集,Browse AI 都能提供开箱即用的解决方案。
主要功能
无代码抓取与智能监控
Browse AI 的核心交互方式是“点选式”构建机器人。用户将目标网页的 URL 粘贴到平台后,AI 会自动解析页面内容,识别出可提取的数据字段,并生成建议列。用户只需审核、微调并确认,一个抓取机器人便创建完成。整个过程无需任何编程知识。更重要的是,平台内置了 AI 变化检测与监控能力,用户可以设置定时运行任务,并配置变化阈值——只有当页面数据发生实质性变化时才触发警报。例如,电商运营者可以监控竞品价格,设置每日检查,一旦价格下调超过设定幅度,系统便会通过邮件或集成应用发送通知。这种智能监控避免了频繁抓取带来的资源浪费,也让数据更新更具针对性。
强大的数据提取能力
Browse AI 能够处理现代网页中常见的复杂场景。它支持分页抓取,包括传统的“下一页”按钮和无限滚动加载;支持子页面深度抓取,即先抓取列表页中的链接,再逐一进入详情页提取更丰富的信息;支持地理位置过滤,可模拟不同地区的访问以获取本地化数据;内置代理管理和 CAPTCHA 解决机制,能够应对 ReCaptcha、hCaptcha 等验证码挑战。此外,机器人可以模拟人类行为,如点击、滚动、填写表单等,从而绕过部分反爬虫机制,确保数据采集的连续性。这些能力使得 Browse AI 不仅能抓取静态页面,也能应对大量动态渲染和交互式网站。
丰富的预构建机器人模板
为了进一步降低使用门槛,Browse AI 提供了 200 多个预构建机器人模板,覆盖 Amazon、Etsy、Airbnb、TikTok、YouTube、Reddit、Google Maps、Redfin 等热门网站。用户无需从零开始配置,一键部署即可开始抓取。例如,想要分析 TikTok 上的热门视频和评论,可以直接选用对应模板,几分钟内就能获得结构化数据;想要追踪 YouTube 播放列表的更新,也有现成机器人可用。这些模板经过大量用户验证,稳定性和字段设计都较为成熟,非常适合快速启动项目。
灵活的调度与自动化工作流
Browse AI 支持按小时、每天、每周或每月定时运行机器人,满足不同频率的数据更新需求。平台具备批量提取能力,单次任务可处理高达 50 万页的数据,适合大规模数据采集场景。更值得一提的是链式工作流功能:用户可以设置一个机器人先抓取列表页,另一个机器人随后自动进入每个详情页提取深度信息,形成流水线式的自动化流程。例如,每周自动从 Redfin 抓取房地产列表,并将结果导出到 Google Sheets,整个过程无需人工干预。
无缝集成与数据输出
抓取到的数据可以轻松流转到用户日常使用的工具中。Browse AI 支持将数据导出为 Google Sheets、Airtable 等表格形式,也可以直接推送到 9,000 多个应用和工具,通过 Zapier、Webhooks 等方式实现自动化。平台还提供“网站转 API”功能,用户可以将任意网站的抓取结果转化为 API 接口,方便开发团队将数据集成到自有系统中。此外,Browse AI 支持将数据同步给大语言模型(LLM),为 AI 应用提供实时、结构化的外部数据源。
企业级服务与定制支持
对于有复杂需求的企业用户,Browse AI 提供全托管的网页抓取与监控服务,包括定制化数据后处理、大规模抓取方案设计等。用户可以通过预约咨询与销售团队沟通,获得针对特定业务场景的解决方案。平台还提供完整的 API 文档,支持开发者在其之上构建应用。联盟计划则为推荐者提供 20% 的永久佣金,显示出平台对生态建设的重视。
使用方法
使用 Browse AI 的流程非常直观,大致可分为以下几步:
- 注册并登录:访问官网,使用邮箱注册账号,即可免费开始抓取第一个网站的数据。
- 创建机器人:粘贴目标网页 URL,AI 自动分析页面并建议数据列;用户审核、增删字段后确认。
- 配置抓取规则:根据需要设置分页方式、子页面抓取、地理位置、代理等高级选项。
- 设置调度与监控:选择运行频率,配置变化检测阈值和警报通知方式。
- 选择输出目标:将数据导出到 Google Sheets、Airtable,或通过集成推送到其他应用。
- 运行与维护:机器人按计划自动运行,AI 持续适应网站变化,用户可在仪表盘查看运行状态和历史数据。
对于不熟悉配置的用户,预构建机器人模板可以跳过大部分步骤,一键部署即可使用。
产品优势
与传统网页抓取工具相比,Browse AI 的优势体现在多个维度:
| 对比维度 | Browse AI | 传统抓取工具 |
|---|---|---|
| 技术门槛 | 无代码,点选式操作 | 需要编程或脚本知识 |
| 网站改版适应性 | AI 自动适应布局变化 | 脚本易失效,需手动维护 |
| 监控与警报 | 内置变化检测和阈值警报 | 通常需额外开发 |
| 预构建模板 | 200+ 现成机器人 | 一般无或较少 |
| 集成能力 | 9,000+ 应用,支持 API 输出 | 集成能力有限 |
此外,Browse AI 的 AI 自适应能力显著降低了长期维护成本。传统爬虫在目标网站调整页面结构后往往需要重新编写选择器,而 Browse AI 的机器人能够理解页面语义,自动调整提取逻辑,保证数据管道的持续稳定。平台的高评分和庞大用户基础也从侧面验证了其可靠性。
应用场景
Browse AI 的适用场景非常广泛,官网按数据类别列出了多个方向:
- 价格监控:可靠地监控任意网站的商品价格和促销信息,帮助电商卖家及时调整定价策略。
- 电子商务:大规模抓取和监控产品数据、竞品动态和供应商信息。
- 房地产数据:从主流房产网站抓取房源列表、价格和市场数据,辅助投资决策。
- 职位列表:跨平台抓取和监控招聘信息、候选人数据,用于招聘市场分析。
- 法律数据:提取和监控案件数据、判决文书、法律条款等。
- 销售线索生成:将任意网站转化为线索生成引擎,自动提取潜在客户信息。
- 为大语言模型提供数据:从网站提取数据并同步给所选 LLM,增强 AI 应用的数据供给。
无论是市场研究人员、电商运营、房产分析师,还是销售团队和 AI 开发者,都能在 Browse AI 中找到对应的解决方案。
核心功能
优缺点分析
适用人群
常见问题


