
详细介绍
工具简介
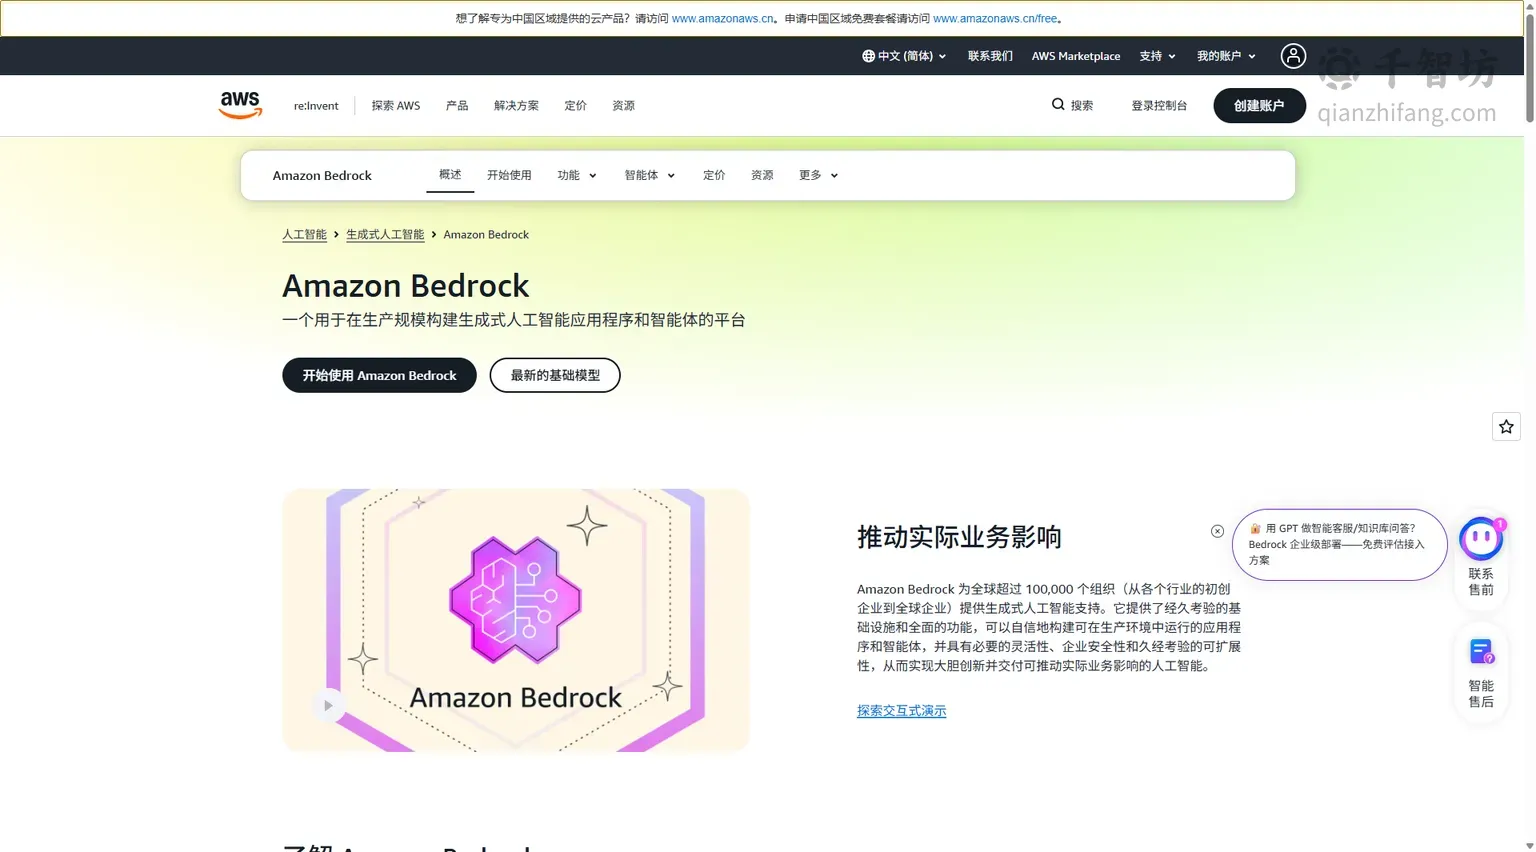
Amazon Bedrock 是亚马逊云科技(AWS)推出的一项全托管生成式 AI 服务,旨在帮助开发者和企业以更简单、更安全的方式构建和扩展生成式 AI 应用。通过单一 API 接口,用户可以访问来自多家领先 AI 公司的基础模型(Foundation Models,简称 FMs),包括 Amazon 自研的 Titan 系列模型以及来自 Anthropic、AI21 Labs、Cohere、Meta、Mistral AI、Stability AI 等第三方提供商的模型。Bedrock 降低了生成式 AI 应用开发的门槛,让开发者无需管理底层基础设施即可快速实验、定制和部署模型。
作为 AWS 云服务体系的重要组成部分,Bedrock 提供了从模型选择、评估、微调到部署和监控的完整工具链。它支持文本生成、图像生成、嵌入向量生成等多种任务类型,并且通过知识库(Knowledge Bases)、代理(Agents)和护栏(Guardrails)等附加功能,帮助企业构建具备上下文感知能力、可执行复杂任务的智能应用。Bedrock 强调数据隐私与安全,明确承诺不会使用客户数据来训练基础模型,并通过传输中加密、静态数据加密和基于身份的数据访问管理策略来保护客户数据。
主要功能
多模型统一访问
Bedrock 的核心价值在于模型无关性。开发者可以通过统一的 API 访问来自不同提供商的数十种基础模型,根据任务需求灵活切换。例如,对于需要深度推理的复杂任务可以选择 Anthropic 的 Claude 系列模型;对于创意写作可以选择 AI21 Labs 的 Jurassic 系列;对于图像生成可以使用 Stability AI 的 Stable Diffusion 模型。这种设计避免了供应商锁定,让团队能够持续使用最适合当前任务的模型。
模型评估与比较
Bedrock 提供模型评估工具,支持用户通过自动化评估和人工评估两种方式比较不同模型在特定任务上的表现。用户可以使用自己的数据集进行测试,获得关于准确性、毒性、鲁棒性等维度的量化指标,从而做出更明智的模型选择决策。这对于企业构建生产级 AI 应用至关重要。
模型定制与微调
Bedrock 支持对部分基础模型进行微调(Fine-tuning),用户可以使用自己的标注数据对模型进行定制化训练,以提升特定领域的表现。此外,Bedrock 还提供持续预训练和蒸馏等高级定制能力,帮助企业在保持成本可控的前提下获得更贴合业务需求的模型。
知识库(Knowledge Bases)
Bedrock 知识库功能允许企业将私有数据(如文档、数据库内容)与基础模型连接,实现检索增强生成(RAG)。系统会自动将数据转换为嵌入向量并存储在向量数据库中,当用户提问时,系统检索相关片段并注入提示词,从而生成基于企业私有知识的准确回答。这大大降低了模型产生幻觉的风险。
代理(Agents)
Bedrock Agents 功能使开发者能够构建自主智能体,这些智能体可以理解用户请求、分解任务、调用外部 API 并执行多步骤工作流。例如,一个预订酒店的智能体可以自动查询可用房间、确认价格并完成预订。代理功能支持与 AWS Lambda、API Gateway 等服务集成,扩展了 AI 应用的能力边界。
护栏(Guardrails)
Bedrock Guardrails 提供内容安全与合规控制,允许企业定义主题过滤、内容过滤、敏感信息过滤和单词过滤策略,确保模型输出符合企业政策和法律法规要求。同时支持对模型输出进行上下文 groundedness 检查,减少不准确信息的传播。
安全与隐私
Bedrock 从不存储或使用客户数据来训练模型。所有数据传输和存储均经过加密,并支持基于身份的数据访问管理。企业可以通过 AWS IAM 精细控制谁可以访问哪些模型和功能,满足严格的合规要求。
使用方法
使用 Bedrock 的基本流程如下:
- 登录 AWS 控制台,进入 Amazon Bedrock 服务页面。
- 选择模型:在模型目录中浏览可用模型,查看各模型的特性、定价和适用场景。
- 申请模型访问权限:部分第三方模型需要提交使用申请,获批后即可调用。
- 在 Playground 中测试:使用内置的测试环境与模型交互,调整参数并观察输出效果。
- 集成到应用:通过 AWS SDK 或 API 调用模型,将生成式 AI 能力嵌入到自己的应用程序中。
- 配置知识库和代理(可选):上传私有数据创建知识库,或定义代理工作流以执行复杂任务。
- 设置护栏(可选):配置内容过滤策略,确保输出安全合规。
- 监控与优化:利用 CloudWatch 等工具监控调用量、延迟和错误率,持续优化应用性能。
产品优势
| 优势维度 | 具体说明 |
|---|---|
| 全托管服务 | 无需管理服务器或基础设施,AWS 负责底层运维,开发者专注于应用逻辑。 |
| 模型多样性 | 汇集多家领先 AI 公司的模型,避免单一供应商锁定,灵活匹配任务需求。 |
| 企业级安全 | 数据加密、访问控制、不用于模型训练,满足金融、医疗等行业的合规要求。 |
| 无缝集成 | 与 AWS Lambda、S3、DynamoDB 等服务原生集成,便于构建端到端解决方案。 |
| 成本可控 | 按需付费,无前期承诺,支持预置吞吐量以满足高负载场景。 |
应用场景
- 智能客服:结合知识库构建基于企业文档的问答系统,提升客服效率和准确性。
- 内容生成:自动生成营销文案、产品描述、报告摘要等,提高内容生产效率。
- 代码辅助:利用代码生成模型辅助开发者编写、解释和调试代码。
- 文档处理:从合同、发票等非结构化文档中提取关键信息,实现自动化流程。
- 智能搜索:通过嵌入向量实现语义搜索,提升企业知识库的检索体验。
- 对话式智能体:构建能执行多步骤任务的虚拟助手,如旅行预订、订单查询等。
总体而言,Amazon Bedrock 是一个面向企业级应用的生成式 AI 平台,它通过整合多模型访问、安全合规、知识库和代理等能力,为开发者提供了一站式的 AI 应用构建体验。无论是初创团队还是大型企业,都可以借助 Bedrock 快速将生成式 AI 落地到实际业务中。
核心功能
优缺点分析
适用人群
常见问题


