
详细介绍
工具简介
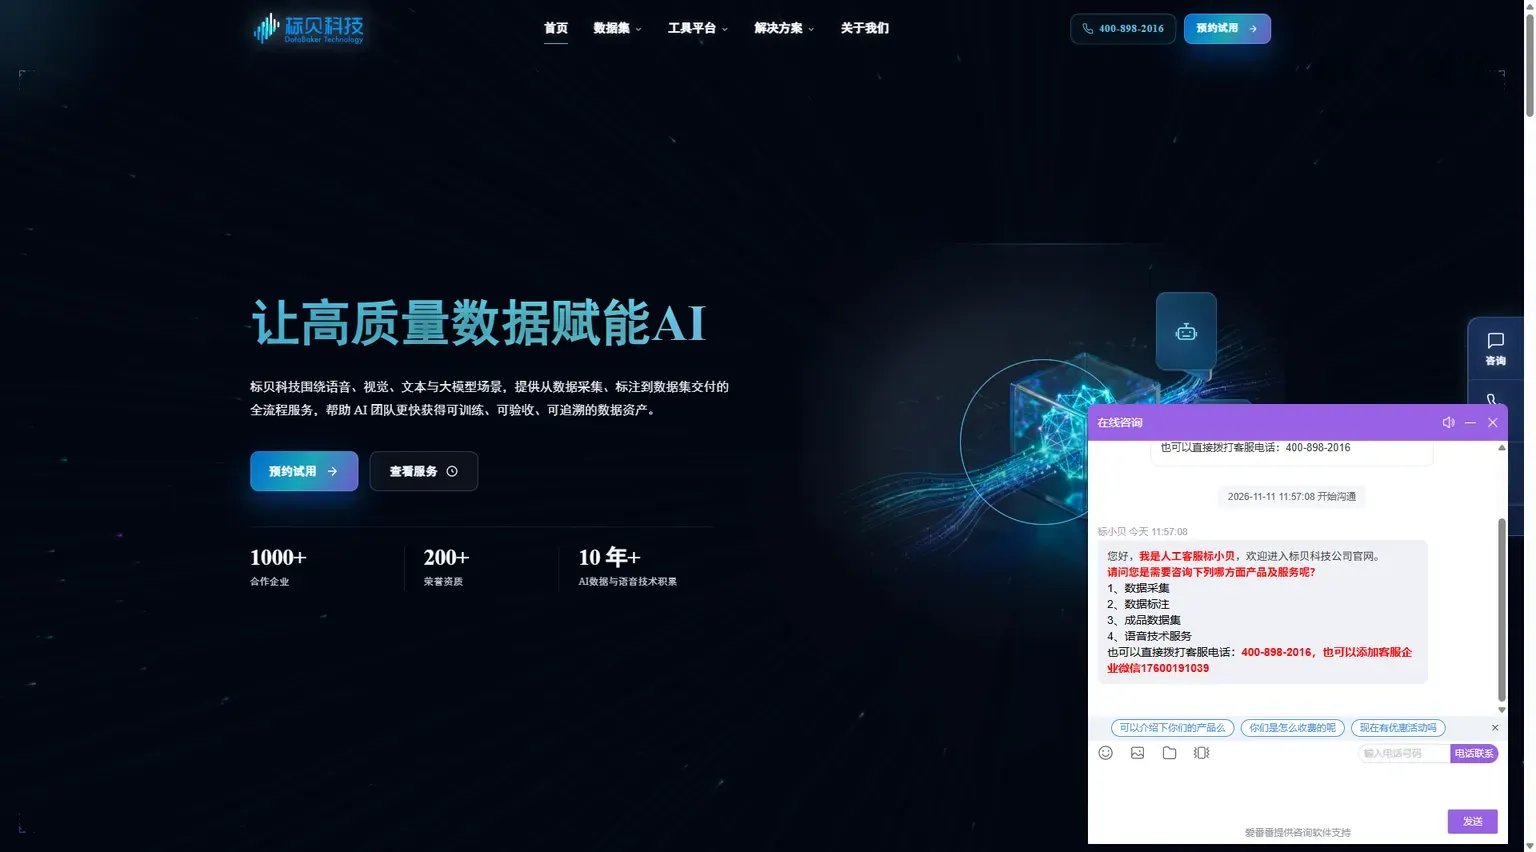
Baker(官网域名 data-baker.com)是标贝科技旗下的一站式AI数据服务平台。从品牌定位来看,它并不像市面上常见的“AI生成内容”类工具那样直接面向普通消费者提供写作、绘画或对话功能,而是聚焦于AI产业链更上游、也更关键的一环——高质量数据资产的构建与交付。正如其官网首页所强调的核心理念“让高质量数据赋能AI”,Baker围绕语音、视觉、文本与大模型等场景,提供从数据采集、数据标注到成品数据集交付的全流程服务,帮助AI研发团队更快获得“可训练、可验收、可追溯”的数据资产。
根据官网披露的信息,标贝科技在AI数据与语音技术领域已积累10年+的行业经验,累计服务1000+合作企业,并获得200+项荣誉资质。这些数据从侧面说明,Baker并非一个刚起步的实验性产品,而是经过大量商业化项目验证的成熟数据服务平台。对于需要训练语音识别、语音合成、计算机视觉、大语言模型乃至具身智能模型的团队而言,数据的质量、合规性与交付效率往往直接决定模型效果的上限,而Baker正是围绕这一痛点构建起完整的能力矩阵。
从产品结构上看,Baker的能力可以划分为三条主线:数据采集服务、数据标注服务与成品数据集产品,三者相互衔接,形成“从原始数据到模型可用数据”的一站式交付链路。与此同时,平台还提供标注平台、采集平台、标贝悦读、开放平台等工具平台,以及面向具身智能、自动驾驶、大模型、金融、医疗、互联网、智能终端、内容审核等行业的场景化解决方案,并对外输出ASR语音识别、TTS语音合成等智能语音能力。这种“数据服务+工具平台+行业方案+语音技术”的组合,使Baker更像是一个面向AI研发全流程的数据基础设施,而非单一功能型工具。
主要功能
一、多模态数据采集服务
数据采集是模型训练的第一步,也是决定数据多样性与真实性的关键环节。Baker的采集服务围绕语音、图像、视频、文本等数据需求,建立了从样本设计到采集执行的标准化流程。具体而言,平台支持人群与场景配额设计,可以按语种、设备、场景和人群画像组织采集任务,确保样本覆盖目标分布;支持多端采集任务管理,将语音、图像、视频、文本统一纳入任务流,便于后续清洗、质检和版本管理;同时强调数据脱敏与版权确认,通过采集授权、隐私脱敏、过程留痕与质量抽检共同构成可验收的数据链路。官网特别提到其具备“多国资源覆盖”能力,能够按语种、设备、场景和人群画像快速补齐多模态样本,这对于需要多语种语音数据或跨地域图像数据的团队尤为重要。
二、专业数据标注服务
标注质量直接决定监督学习的效果。Baker的标注服务覆盖分类、转写、分割、框选、偏好排序与大模型评测等多种任务类型,并形成可追溯的质检链路。平台强调多轮质检与抽检机制,通过多轮校验降低标注错误率;针对复杂任务提供SOP拆解,把大型标注项目拆解为可管理、可分工的标准作业流程;并通过标注平台与项目管理联动,让任务分配、进度跟踪与质量验收在同一体系内完成。对于大模型时代兴起的偏好排序(如RLHF所需的排序标注)与大模型评测需求,Baker也已将其纳入标注服务范围,体现出对前沿训练范式的跟进。
三、成品数据集产品
对于希望快速启动项目、或不愿自行组织采集标注的团队,Baker提供覆盖语音识别、语音合成、视觉、文本与大模型训练数据的成品数据集。数据集按具身智能、大模型、语音识别(ASR)、语音合成(TTS)、图像、视频、文本等类别组织,支持标准数据集快速选型、行业场景定制补充以及训练集/评测集分层交付。这种“开箱即用+可定制扩展”的模式,既能满足快速验证的需求,也能支撑长期的数据迭代。
四、工具平台矩阵
Baker配套提供标注平台、采集平台、标贝悦读与开放平台等工具。标注平台与采集平台支撑任务执行与项目管理;标贝悦读通常面向语音合成语料的录制与朗读场景;开放平台则以API等形式对外输出智能语音能力,包括ASR语音识别、TTS语音合成及语音拓展产品。工具平台与数据服务的联动,使得采集、标注、质检、交付可以在统一体系内闭环。
五、行业解决方案
Baker针对不同行业的差异化数据需求提供场景化方案,覆盖具身智能、自动驾驶、大模型、金融、医疗、互联网、智能终端与内容审核等领域。例如自动驾驶需要道路场景图像与点云数据,医疗领域对隐私合规与专业标注要求极高,金融与内容审核则涉及大量文本分类与风险识别任务。行业方案的价值在于把通用的采集标注能力与行业know-how结合,降低客户的适配成本。
使用方法
Baker作为企业级数据服务平台,使用流程通常遵循以下步骤:
- 需求沟通与预约试用:通过官网“预约试用”入口或客服电话(400-898-2016)联系团队,说明数据模态、规模、语种、场景与交付时间等需求。
- 方案设计与配额规划:平台根据需求设计样本方案,包括人群与场景配额、采集设备规范、标注SOP与质检标准。
- 采集执行:通过采集平台组织多端采集任务,过程留痕并同步进行脱敏与授权确认。
- 标注与质检:在标注平台上分配任务,经过多轮质检与抽检后形成可追溯的标注结果。
- 交付与验收:按训练集/评测集分层交付,附带质量报告与过程记录,支持后续定制扩展。
若选择成品数据集,则可直接在数据集页面按类别选型,缩短启动周期。
产品优势
| 维度 | Baker的表现 |
|---|---|
| 经验积累 | 10年+ AI数据与语音技术积累,1000+合作企业,200+荣誉资质 |
| 模态覆盖 | 语音、图像、视频、文本、点云、文档、对话等多模态统一任务流 |
| 交付链路 | 采集—清洗/脱敏—标注—质检—交付全流程可追溯 |
| 合规能力 | 采集授权、隐私脱敏、过程留痕与质量抽检构成可验收链路 |
| 行业适配 | 覆盖具身智能、自动驾驶、大模型、金融、医疗等8+行业场景 |
总体来看,Baker的核心优势在于全链路一体化与合规可追溯:客户无需在多家采集商、标注商之间协调,即可在同一平台完成从原始数据到可训练数据的转化;而标准化的质检与授权流程,则降低了数据合规风险。对于追求数据质量与交付确定性的AI团队,这种一体化能力具有明显价值。
应用场景
- 语音模型训练:为ASR、TTS提供多语种、多场景语音采集与转写标注。
- 大模型对齐与评测:提供偏好排序标注、大模型评测数据集与训练语料。
- 自动驾驶与具身智能:采集道路场景图像、视频与点云数据并完成框选、分割标注。
- 金融与医疗:在强合规要求下完成文本分类、实体识别等专业标注。
- 内容审核:构建文本与多模态内容审核训练集。
需要说明的是,Baker定位为企业级数据服务,官网未公开标准化定价,价格模式需通过预约试用或商务沟通确认,个人开发者与小团队在采购前应充分评估预算与需求规模。
核心功能
优缺点分析
适用人群
常见问题


