
详细介绍
工具简介
arXiv Xplorer 是一款专为学术研究者打造的语义搜索引擎,聚焦于全球最大的预印本论文库 arXiv,同时兼容 bioRxiv 和 medRxiv 的开放获取数据。与传统的基于关键词匹配的检索方式不同,arXiv Xplorer 借助 OpenAI 的 Embeddings 技术,将论文的标题与摘要转化为高维向量,从而实现真正意义上的“语义级”搜索——即使用户无法准确回忆起论文标题或专业术语,也能通过描述研究意图找到高度相关的文献。
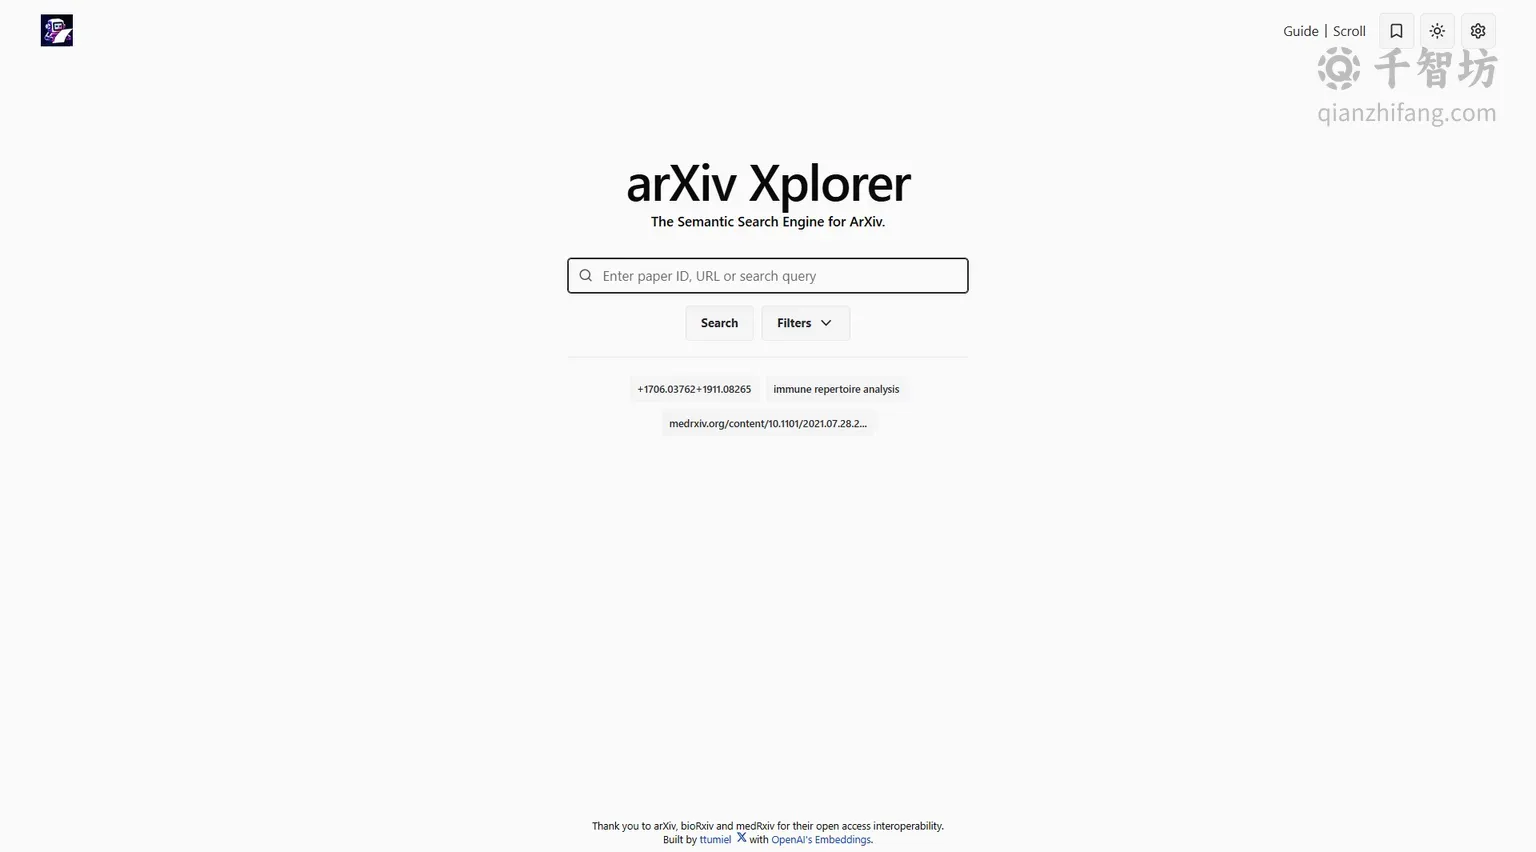
该工具由开发者 ttumiel(Tom Tumiel)独立构建,官网设计极为简洁,核心界面仅包含搜索框、标签筛选、年份筛选以及搜索过滤器等元素,没有冗余的广告或社交功能,体现出鲜明的学术工具属性。arXiv Xplorer 明确致谢 arXiv、bioRxiv 和 medRxiv 提供的开放获取互操作性支持,这意味着其数据来源合法合规,且能够覆盖物理、数学、计算机科学、生物学、医学等多个学科领域的前沿预印本成果。
对于长期依赖 arXiv 进行文献调研的研究生、博士后和高校教师而言,arXiv 官方搜索虽然功能强大,但在处理模糊查询、跨学科概念联想以及长尾语义匹配时存在明显短板。arXiv Xplorer 正是瞄准这一痛点,将大语言模型时代的向量检索能力引入学术搜索场景,让“用自然语言描述你想找的研究”成为可能。目前该工具以 Web 形式免费开放使用,无需注册登录即可发起检索,降低了使用门槛。
主要功能
语义向量检索
arXiv Xplorer 的核心能力在于语义搜索。系统利用 OpenAI Embeddings 将论文文本映射为向量表示,当用户输入查询语句时,搜索引擎计算查询向量与论文向量之间的相似度,并返回语义上最接近的结果。这一机制使得用户可以用完整句子、研究问题甚至假设描述来检索,例如输入“如何利用对比学习提升小样本图像分类性能”,系统能够召回相关论文,而不要求标题中出现“对比学习”或“小样本”等精确词汇。
标签与年份筛选
搜索界面提供 Tags(标签)和 Year(年份)两个筛选维度。标签筛选允许用户将结果限定在特定的 arXiv 学科分类或主题标签下,避免跨领域噪声干扰;年份筛选则帮助研究者聚焦于近期成果或回溯经典文献,例如限定 2023 年之后发表的论文,以追踪最新研究进展。
搜索过滤器
界面中的 SearchFilters 选项提供了更细粒度的结果控制能力,用户可以根据需要调整检索范围与排序逻辑,使搜索结果更贴合具体的文献调研任务。结合语义检索,过滤器能够有效缩小候选集,提升查准率。
多源数据覆盖
虽然工具名称聚焦 arXiv,但官网明确说明其数据互操作性覆盖 arXiv、bioRxiv 和 medRxiv 三大预印本平台。这意味着生物医学领域的研究者同样可以使用该工具检索尚未正式发表的预印本成果,对于追踪快速演进的领域(如 AI 制药、基因组学)具有实用价值。
指南与滚动浏览入口
官网提供 Guide(使用指南)页面,帮助新用户快速理解语义搜索的用法与技巧;同时设有 Scroll 子站点入口,提供另一种浏览论文的交互方式,方便用户以信息流形式探索学术内容。
使用方法
- 访问官网:在浏览器打开 arxivxplorer.com,无需注册即可进入搜索主页。
- 输入查询:在搜索框中用自然语言描述研究主题、问题或关键词组合,支持中英文(建议英文以获得更优的向量匹配效果)。
- 设置筛选:根据需要选择 Tags 标签和 Year 年份范围,必要时展开 SearchFilters 调整检索参数。
- 浏览结果:查看语义排序后的论文列表,点击标题跳转至 arXiv 等源站阅读摘要与全文。
- 迭代优化:根据首轮结果调整查询措辞或筛选条件,逐步逼近目标文献集合。
产品优势
| 对比维度 | arXiv Xplorer | arXiv 官方搜索 |
|---|---|---|
| 检索方式 | 语义向量匹配,支持自然语言描述 | 关键词/字段匹配为主 |
| 模糊查询能力 | 强,可跨术语召回相关论文 | 较弱,依赖精确词汇 |
| 数据来源 | arXiv + bioRxiv + medRxiv | 以 arXiv 为主 |
| 使用门槛 | 免注册,界面极简 | 免注册,功能繁多 |
此外,arXiv Xplorer 完全基于开放获取数据构建,不涉及付费墙内容,且技术栈透明(官网标注使用 OpenAI Embeddings),对于关注检索可解释性的研究者较为友好。
应用场景
- 开题调研:研究生在确定研究方向时,用自然语言描述兴趣点,快速摸清领域脉络。
- 跨学科检索:当研究问题涉及多个领域术语时,语义搜索可降低因术语不熟导致的漏检。
- 追踪前沿:结合年份筛选,持续关注某主题近一两年内的预印本进展。
- 生物医学预印本挖掘:通过 bioRxiv/medRxiv 数据覆盖,辅助医学与生命科学研究。
核心功能
优缺点分析
适用人群
常见问题


