
详细介绍
工具简介
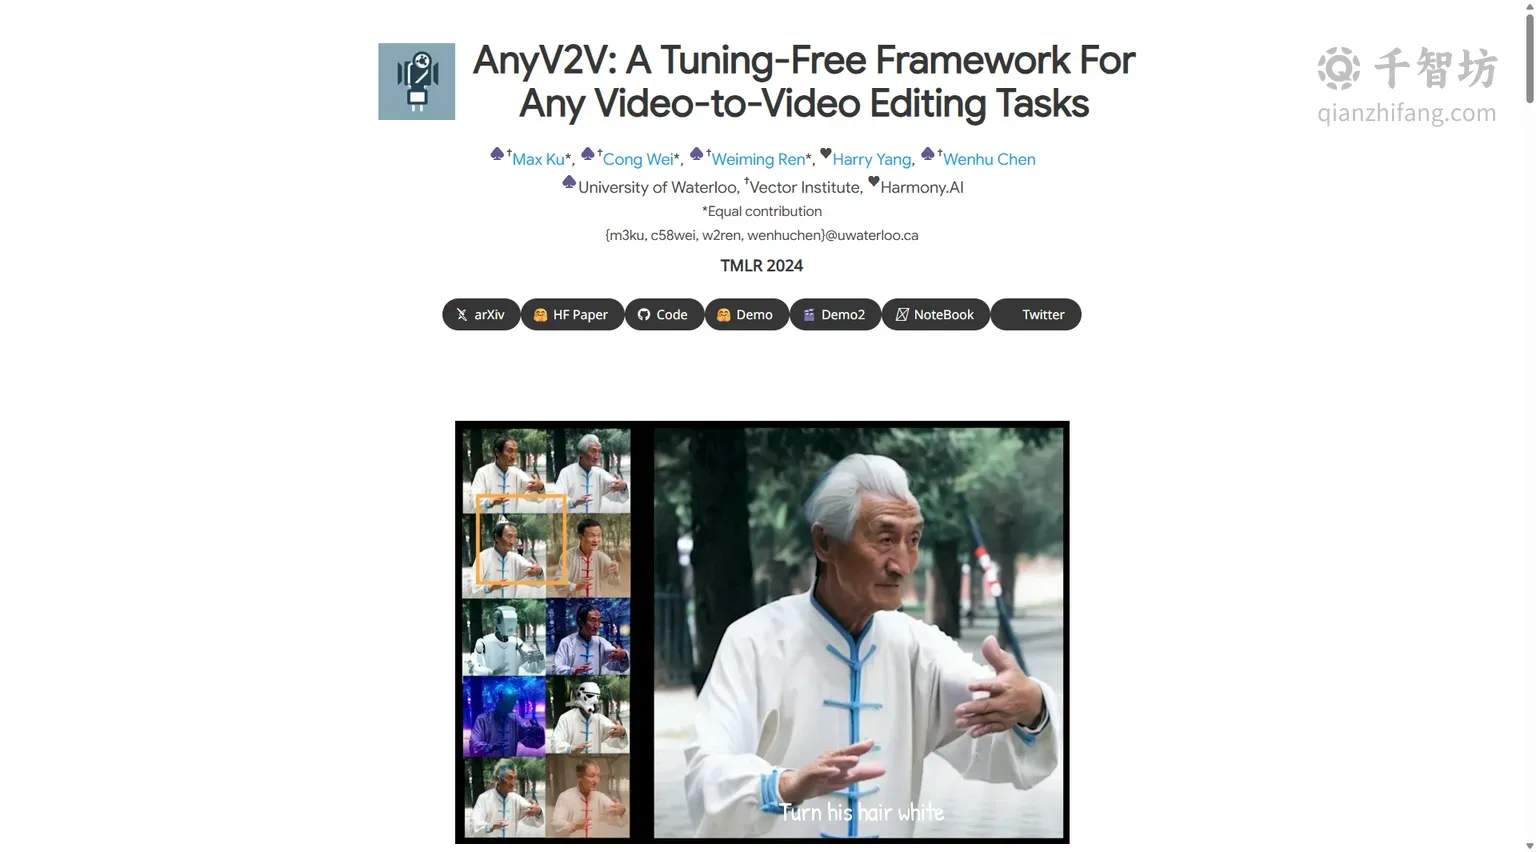
AnyV2V 是由滑铁卢大学(University of Waterloo)、Vector Institute 以及 Harmony.AI 联合推出的一款免调优(Tuning-Free)视频到视频编辑框架。该工具在 2024 年发表于 TMLR(Transactions on Machine Learning Research),是首个将图像到视频(Image-to-Video,简称 I2V)生成模型引入视频编辑领域的工作。AnyV2V 的出现,为数字内容创作者提供了一种全新的视频编辑范式,极大地降低了视频编辑的技术门槛,同时提升了编辑效果的灵活性和质量。
传统的视频编辑方法通常面临两大困境:要么是从图像生成模型零样本(zero-shot)扩展而来,导致视频流畅度不足;要么需要进行大量的微调训练,耗时耗力且效果难以保证。此外,这些方法往往依赖文本输入作为编辑指导,存在语义歧义,限制了可执行的编辑类型。AnyV2V 针对这些痛点,提出了一种创新的两阶段编辑流程,将复杂的视频编辑任务拆解为两个相对简单且成熟的步骤,从而绕开了传统方法的诸多限制。
核心原理与工作流程
AnyV2V 的核心思想是将视频编辑过程解耦为两个独立阶段:首帧图像编辑和图像到视频重建。这种设计巧妙地利用了现有图像编辑模型和图像到视频生成模型的强大能力,无需对模型进行任何额外的训练或微调。
第一阶段:首帧图像编辑
在第一阶段,AnyV2V 接收源视频作为输入,提取其第一帧图像,然后使用任意现成的图像编辑模型(如基于提示词的编辑模型、参考图风格迁移模型、主体驱动编辑模型等)对该首帧进行修改。由于图像编辑领域已经非常成熟,拥有大量高质量的工具和模型,因此这一步可以充分利用这些资源,实现精细、准确的修改。用户可以根据自己的编辑需求,灵活选择不同的图像编辑方法,这为后续的视频编辑提供了极大的灵活性。
第二阶段:图像到视频重建
在第二阶段,AnyV2V 将编辑后的首帧图像作为条件,利用现有的图像到视频(I2V)生成模型来生成完整的编辑后视频。具体来说,源视频会被反转(invert)为初始噪声,然后使用 DDIM 采样进行去噪。在采样过程中,框架会提取源视频的空间特征、空间注意力等信息,并通过时间特征注入(Temporal Feature Injection)机制将这些信息注入到 I2V 模型的生成过程中。这样,生成的视频不仅与编辑后的首帧保持一致,还能保持与源视频在时间上的连贯性和视觉一致性。由于 I2V 模型本身具备生成任意长度视频的能力,AnyV2V 也因此能够支持任意长度的视频编辑。
主要功能
AnyV2V 的功能覆盖了多种视频编辑任务,且得益于其两阶段设计,能够支持传统方法难以实现或无法实现的编辑类型。以下是其核心功能:
- 基于提示词的编辑(Prompt-based Editing):用户可以通过文本提示词描述想要修改的内容,例如将视频中的物体替换为其他物体、改变场景风格等。首帧图像编辑模型根据提示词修改首帧,随后 I2V 模型生成连贯的编辑视频。
- 基于参考图的风格迁移(Reference-based Style Transfer):用户可以提供一张风格参考图,将源视频的整体风格(如油画风格、卡通风格等)迁移到视频中。首帧图像编辑模型会按照参考图风格修改首帧,再生成风格一致的视频。
- 主体驱动编辑(Subject-driven Editing):用户可以指定一个主体(如人物、动物或物体),并对其进行替换、修改或重新设计。例如,将视频中的人物替换为另一个特定人物,或者改变人物的服装、发型等属性。
- 身份操控(Identity Manipulation):针对人脸或人物身份进行编辑,例如将视频中的人物身份替换为另一个人,同时保持动作和表情的自然过渡。
- 任意长度视频支持:AnyV2V 不限制视频长度,可以处理从几秒到几分钟的视频。官方在 2024 年 4 月 16 日的更新中,将本地 Gradio 演示的编辑长度扩展到了最长 16 秒(128 帧),展示了其处理较长视频的能力。
- 免调优框架:用户无需对模型进行任何训练或微调,直接使用现成的图像编辑模型和 I2V 模型即可完成编辑,大大降低了使用门槛和计算成本。
使用方法
AnyV2V 提供了多种使用方式,方便不同技术背景的用户体验和使用。用户可以通过官方提供的 Hugging Face Demo 在线试用,也可以下载代码在本地运行 Gradio 演示。基本使用步骤如下:
- 准备源视频:选择一段需要编辑的视频,确保视频格式受支持。
- 选择图像编辑模型:根据编辑任务类型,选择合适的图像编辑模型(如文本引导编辑、风格迁移、主体驱动等),并准备好相应的输入(如提示词、参考图等)。
- 编辑首帧:使用选定的图像编辑模型对源视频的第一帧进行编辑,得到编辑后的首帧图像。
- 配置 I2V 模型:选择现有的图像到视频生成模型(如 Stable Video Diffusion 等),并设置相关参数。
- 生成编辑视频:将编辑后的首帧和源视频输入 AnyV2V 框架,框架会自动完成时间特征注入和视频生成,输出编辑后的视频。
- 预览与调整:查看生成结果,如有需要,可以调整图像编辑参数或 I2V 模型参数,重新生成。
对于开发者,AnyV2V 提供了完整的代码和论文,方便进行二次开发和学术研究。官方还提供了详细的 Notebook 示例,帮助用户快速上手。
产品优势
AnyV2V 在多个方面展现出显著优势,使其在视频编辑领域具有竞争力:
| 对比维度 | AnyV2V | 传统视频编辑方法 |
|---|---|---|
| 是否需要训练/微调 | 完全免调优,直接使用现成模型 | 通常需要大量微调或零样本扩展,效果不稳定 |
| 编辑灵活性 | 支持任意图像编辑模型,可完成提示词编辑、风格迁移、主体驱动、身份操控等多种任务 | 多依赖文本输入,编辑类型受限,存在语义歧义 |
| 视频长度支持 | 支持任意长度视频(本地演示已支持 16 秒/128 帧) | 往往受限于模型训练长度,长视频编辑困难 |
| 视觉一致性 | 通过时间特征注入保持与源视频的视觉一致性,编辑质量高 | 容易出现闪烁、不一致等问题 |
| 使用门槛 | 提供在线 Demo 和本地 Gradio 界面,易于上手 | 通常需要专业知识和复杂配置 |
此外,根据官方论文的评估,AnyV2V 在自动评估和人工评估中均显著优于其他基线方法,在保持与源视频视觉一致性的同时,实现了高质量的编辑效果。
应用场景
AnyV2V 的通用性和灵活性使其适用于多种应用场景:
- 影视后期制作:快速修改视频中的特定元素,如替换道具、改变场景色调、调整人物造型等,提高后期效率。
- 广告与营销:为产品视频进行风格化处理或主体替换,制作多版本广告素材,降低制作成本。
- 社交媒体内容创作:创作者可以轻松地将个人视频转换为不同风格(如动漫风、油画风),或进行趣味性身份替换,提升内容吸引力。
- 学术研究:作为视频编辑领域的前沿框架,为研究人员提供可复现的基线和新思路。
- 个人娱乐与创意表达:普通用户可以通过在线 Demo 体验视频编辑的乐趣,实现创意想法。
总结
AnyV2V 作为一款免调优的视频到视频编辑框架,通过创新的两阶段设计,巧妙融合了图像编辑和图像到视频生成的优势,打破了传统视频编辑的诸多限制。它不仅支持多种编辑任务和任意长度视频,还保持了高质量的视觉一致性,且使用门槛低。无论是专业创作者还是普通用户,都能从中受益。随着官方持续的更新和社区的发展,AnyV2V 有望成为视频编辑领域的重要工具。
核心功能
优缺点分析
适用人群
常见问题


